Fibonacci Statistical Mechanics of Empty Seats
研究編號: Paper_003 完成日期: 2026-10-15
資料類別: E(純理論推導)、D(可重現合成模擬);沒有真實參與者資料。
跨學科: 組合數學、統計物理 Keywords: 路徑圖獨立集;斐波那契遞推;配分函數
方法聲明:本文參數為合成設計。若未經獨立現場驗證,不得把模型數值解讀為真實社會發現。
中文摘要
空蕩食堂中,人往往偏好與陌生人保持至少一個空座位。本研究刻意把這種傾向極端化為「相鄰座位不可同時坐人」,研究可用座位的組合數學而非驗證人類普遍心理。長度 的直線座位可視為路徑圖,其獨立集計數滿足斐波那契遞推。對 20 個座位,合法配置共有 17,711 種,最多可安排 10 人;在所有合法配置等權下,平均佔用 5.681 人。以活動參數 建立配分函數,討論更願意入座時佔用分布如何改變。結果說明局部距離規則可產生全局容量損失,也展示社會直覺如何轉為可證明的統計物理命題。
Abstract
Consider a cafeteria in which nobody is willing to sit adjacent to a stranger. Treating this rule as a hard constraint turns seating into the independent-set problem on a path graph. The number of admissible patterns follows a Fibonacci recurrence, and the grand-canonical partition function permits an exact expected-occupancy calculation. For 20 seats, 17,711 patterns are valid, the maximum occupancy is ten, and uniformly sampling all admissible patterns yields an expected 5.681 occupied seats. Synthetic sampling reproduces the analytic distribution. The result describes an intentionally simplified spatial rule, not measured seating preferences.
關鍵詞 / Keywords: 路徑圖獨立集;斐波那契遞推;配分函數
1. Introduction — 引言
食堂明明還有很多椅子,一群陌生人卻可能各自隔着一個空位坐下;直到較晚到的人才被迫填補空格。「明明有二十個位,點解十個人已經坐到好似滿咗?」這個問題的答案部分是幾何,而非心理。只要把相鄰空位當成某種社交緩衝,就會看到個體的局部限制對整體容量產生非線性後果。
本文不把「必須隔位」視為人類定律;它是一項極端、可證明、可反駁的行為規則。研究的主要貢獻是在同一框架下同時計算三種常被混淆的數量:最多能坐多少人、所有符合規則的佈局有多少種,以及不同佈局按權重被選中時的平均佔用。只有分清極大容量與平均佔用,才能正確閱讀看似浪費的空椅現象。
2. Literature Review — 文獻回顧
Schelling(1971)指出小尺度位置偏好能產生宏觀空間格局,提供把個體簡單選擇映射成系統模式的經典動機。Shannon(1948)提出資訊熵概念,可用以量化配置分佈的不確定性;本文使用配分函數求得分佈,再由分佈計算對數量。Hoeffding(1963)處理有限取值隨機量的偏差界,其思想支持理解獨立抽樣均值的收斂性;但本文的座位配置數由組合恒等式直接求得,無需依賴任何社會調查。
這裡所稱「硬核排斥」(hard-core exclusion)是統計物理對互斥佔據狀態的標準抽象。它將相鄰不可同坐轉為數學上的零概率配置,但真實食堂的規則通常是軟偏好,隨座位稀缺程度可以被放寬。
3. Research Questions and Hypotheses — 研究問題與假設
R1: 個直列座位中,相鄰不得同時入座時,合法佈局總數是多少?R2:同樣的條件下,最大佔用與平均佔用為何不相等?R3:若較多人願意入座、使每名入座者賦予較高權重,期望佔用會如何變化?
H1:合法配置數滿足二階線性遞推,等於移位斐波那契數。H2:配分函數對活動參數的對數導數等於期望佔用量;在 時,期望佔用隨 單調增加。H3:即使所有合法配置等權,平均人數亦未必接近最大容量。
4. Theoretical Framework — 理論框架
以 表示第 個座位空置或佔用,限制是 ,。這等價於路徑圖 的獨立集問題。對合法配置, 是坐下的人數。社交空隙在模型中只屬於不可同時佔用的邊約束,並不代表坐在一個空位以外的乘客必定互不影響。
若對每增加一名佔用者乘以正權重 ,則每個配置的相對權重為 。 對應每種合法佈局等權; 代表高佔用配置受更大權重; 代表低佔用配置較常被抽中。這是統計權重而非量到的座位偏好參數。
5. Methodology — 研究方法
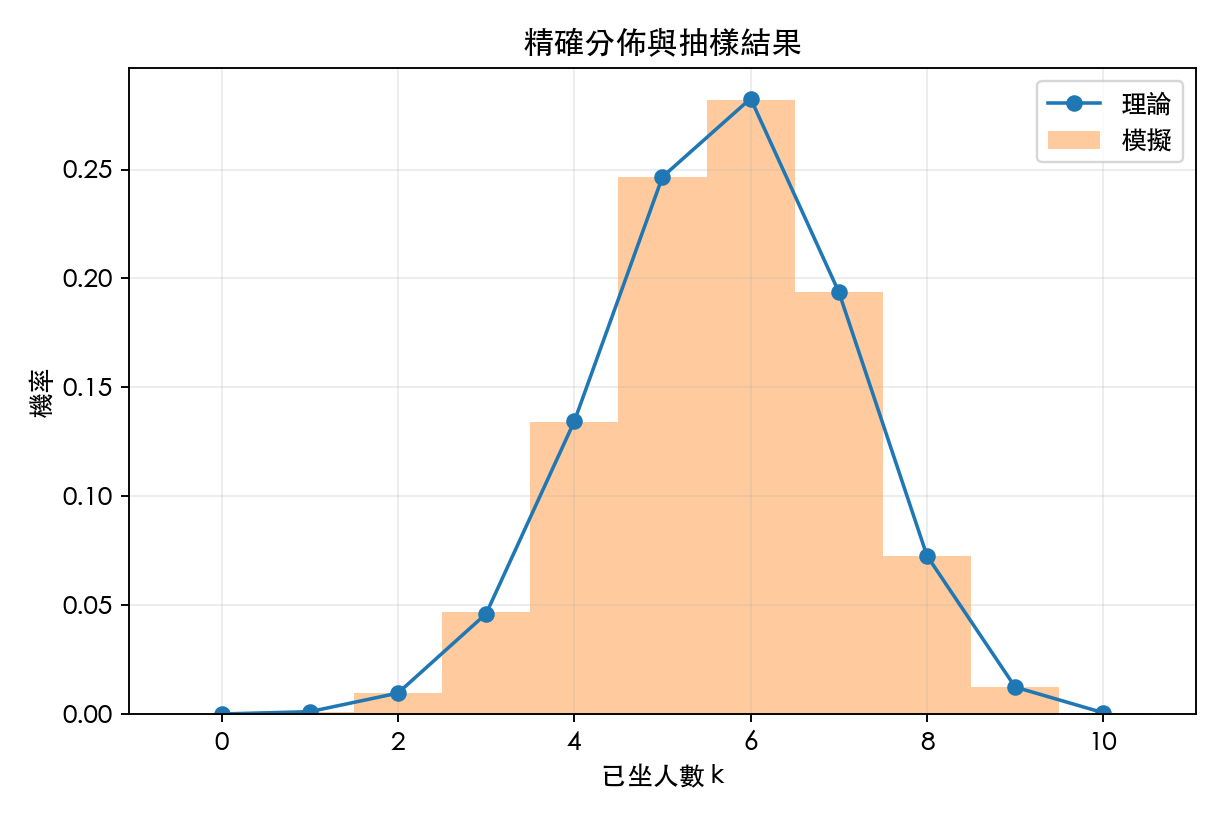
先以首座空/滿拆分法證明遞推,再以組合選擇計數推導恰坐 人的配置數。數值實驗採用 ,對 在 0.1 至 10 之間取 70 個對數間距值,逐一計算配分函數與期望佔用。在 使用精確概率對 至 10 抽樣 160,000 次,種子 20261018。所有輸出為理論 E 或合成模擬 D,未收集任何食堂照片或人流資料。
驗證策略分兩層:一是用斐波那契遞推與封閉組合公式交叉檢查合法佈局總數;二是檢查抽樣平均是否接近配分函數給出的理論期望。這個雙重檢查可避免將計數程式錯誤偽裝成生活科學發現。
斐波那契遞推可再由生成函數作獨立核對。若設定 ,利用 以及後續遞推,可得 。這個有理函數的分母正是座位局部互斥造成的線性遞推結構。若完全沒有相鄰限制,合法配置有 種;加入局部限制後,數量增長改由斐波那契特徵根控制,說明一個簡單的局部規則為何足以改變整個組合空間。
加權情景的遞推需有正確邊界值:、,而 。相關特徵方程 的最大根為 。長座位列的 主要取決於 ,因此每座位漸近平均佔用率可用對 的導數得到。這一做法同時串連了遞推、生成函數及統計物理的自由能觀念,並提供獨立於模擬直方圖的檢查。
活動權重 趨近零時,空位配置占主導,平均佔用趨近零;權重持續提高時,概率質量會集中於佔用最多的可行配置。當 有限,端點位置可能改變合法配置數,故不能把大 極限直接當作二十座樣本的精確平均。若要生成具體座位排列,應先按正規化權重抽取人數 ,再從所有恰有 人的合法配置中等權抽樣;直接均勻抽取二元向量再剔除非法結果雖然在小 可用,但在大系統會逐漸低效。
6. Mathematical / Computational Model — 數學或計算模型
設 是 個座位的合法配置數。最左一座若空,其餘 座任意合法;若滿,第二座必空,餘下 座任意合法,故
因此 ,其中 。若恰坐 人,先保證每對相鄰入座者間有至少一個空位,再分配額外的空位,可得
以 加權,配分函數(partition function)是
正規化後的分佈為 。對 微分得到
再微分一次有 ,直接證明期望入座數隨活動參數單調不減,且在非退化情況嚴格增加。當 大而端點效應可忽略,最大特徵根為 ,漸近佔用比例趨向 。這也是將斐波那契遞推與統計物理連上的核心。
斐波那契遞推之所以出現,源於路徑圖最後一個頂點只有兩種互斥狀態。若第 個座位空着,前 位能採用任何合法配置;若該位有人坐下,前一位必須空出,因而只剩前 位任意安排。兩種情形沒有重疊亦不漏計,這比單純觀察數列像斐波那契更有說服力。若把環形餐桌也納入研究,第一與最後座位相鄰,條件會改變;例如首尾同時坐人須被排除,因此直線模型的答案不能直接套用至圓桌。
閉式計數 可透過位置變換推導。設被坐下的座位索引依序是 ,且 。定義 ,便得到 。因此合法座位組合與從 個位置選 個普通組合一一對應。這個雙射同時說明了最大可坐人數為 的幾何限制。
加入活動參數 之後,同樣的計數變成機率分佈的權重。注意 既不是客流量的實測估計,也不是某個人選擇座位的概率;只有在指定每個合法配置以 加權時,它才有明確意義。寫成指數族形式後, 對 的一階導數是平均人數,二階導數是佔用人數變異數。後者非負,使「提高入座權重,平均佔用不會下降」成為嚴格推論,而不用依賴單一圖形的斜率。
7. Results — 研究結果
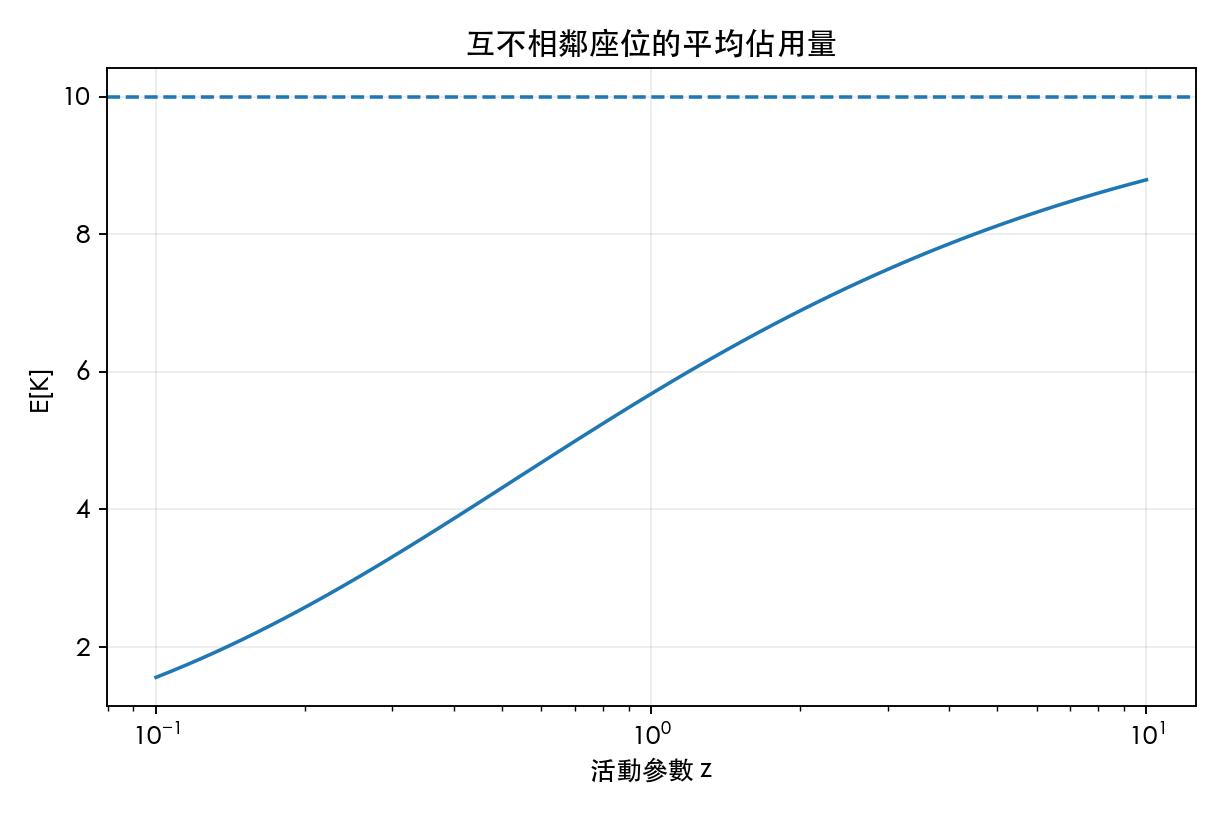
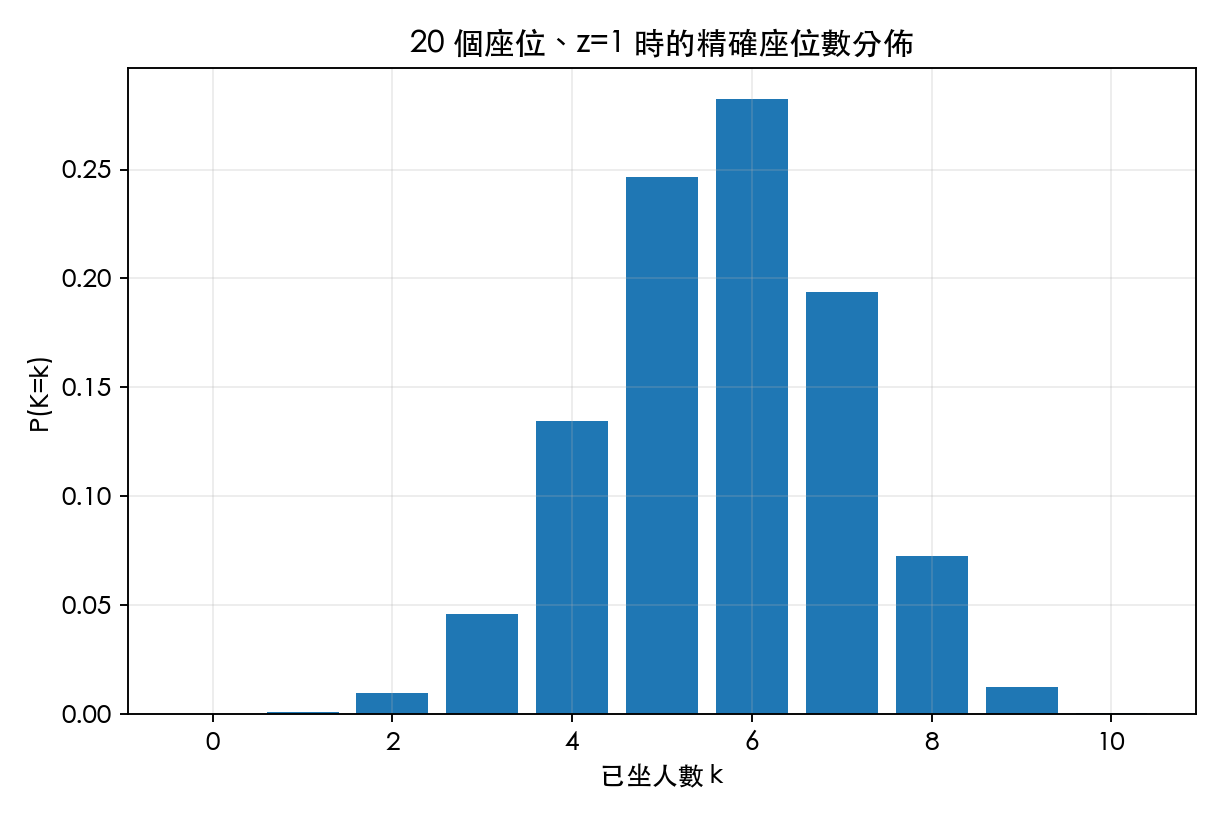
對 ,理論總配置數 ,最大人數 10;但在 的等權模型下,平均佔用僅 5.68065 人,模擬為 5.67826 人。這個落差並非說大部分人「不懂用椅子」,而是等權抽樣大量較低佔用的合法格局後所產生的組合平均。圖 1 呈現 增加時的期望佔用;圖 2 顯示 的精確 分佈;圖 3 以抽樣直方圖驗證解析分佈。
斐波那契數描述的是合規配置的數目,而非食堂實際客流率。觀察到十人坐滿可用分隔座位,並不表示只有十張椅子的物理容量,也不能從配置計數推導出人們對社交距離的道德判斷。
模型圖表及數據來源
圖 1 活動參數對預期座位佔用的影響
 來源:本研究解析計算及/或固定種子電腦模擬。
圖 2 不同座位數量的精確分佈
 來源:本研究解析計算及/或固定種子電腦模擬。
圖 3 精確佔用分佈與模擬比較
 來源:本研究解析計算及/或固定種子電腦模擬。
8. Discussion — 討論
此模型最有價值的地方,是把「局部看起來合理」和「整體資源利用」分開。個別乘客都只要求左右相鄰沒有人,整排座位在滿足此條件下只能坐一半;若社交距離由硬限制改為可支付某種不舒服成本,最大容量又恢復 20,但不同座位選擇的概率改變。學校或餐廳若想改善利用率,可以藉座位標示降低模糊成本,而不用假設顧客只在乎效率。
更複雜的群體入座問題可把單座頂點改為社交關係網絡:朋友之間或許樂意相鄰,陌生人則偏好分隔。那樣的可行配置取決於誰與誰一起進場,不能直接沿用單一的路徑圖獨立集。模型因此同時提示了一個界線:當社會規範真的影響空間分佈時,圖論是有用的語言;要解釋規範形成原因,仍需心理學與觀察資料。
模型對於「座位利用率」有一個重要警示:最大可坐十人、等權平均約 5.68 人,兩者量度的是完全不同的事。前者是極端配置下的最優容量,後者是從所有可行排列等權抽出的平均值。現實食堂的入座過程有先後次序,早到的人會限制晚到的人,亦存在同行朋友願意相鄰而坐的例外,因此配置等權假設往往不成立。若改為序列隨機入座,最終狀態可能是某種無法再增加座位的極大獨立集,但未必是最大獨立集。
可比較兩種其他建模方案。其一允許鄰座,但每對相鄰人產生正的擁擠成本,這把硬限制改為軟限制,並讓社交舒適度與座位效率在同一個效用函數中權衡。其二將座位網絡由路徑改為圖書館的矩形格網;此時每張椅子可能與前後左右的椅子連接,合法配置變為一般圖的獨立集計數,難度顯著提高。這些變體有助說明研究使用斐波那契並非只是有趣的數字巧合,而是空間互斥規則的數學後果。
若日後實際記錄座位佔用,不能只在高峰時拍攝幾張照片就稱為整天的入座分佈。應依時段、同行人數、桌椅排列和座位可用性分層取樣,也需將照片匿名化,不推測顧客的私人動機。模型與現場資料之間的差距可利用擬合參數、留出時段預測誤差及不同空間幾何的比較加以量化。目前的 5.68 人只屬指定等權樣本空間的期望值。
補充:大座位列的密度極限。 若以活動權重 為每名入座者賦予一個乘數,長座位列的配分函數主導項按最大特徵根 的冪次增長。由 ,先取每座位的極限,再對 微分,可得漸近佔用密度 。這個公式直接說明局部的「不能連坐」如何決定大系統的平均容量:當 ,密度趨近約 0.2764;當 持續增大,密度漸近二分之一,而非沒有排斥時的全部座位。二十座案例的平均佔用率約 0.2840,與無窮長座位列的值相近而不完全相同,差異來自邊界效應。
活動權重是統計物理中的 fugacity 類比,不是對某位顧客「願意入座」意願的直接測量。若真正想建立從個人決策到整體佔用的行為模型,需指定顧客依次入場、如何觀察已佔座位置,以及遇到只有相鄰座位時會離開還是破例入座。在純配置模型中,所有合法最終圖樣的權重由人數決定;在順序入座模型中,很多同樣人數的配置可能因出現路徑數不同而有不同概率。兩種機制即使都遵守相鄰互斥,亦不會自動給出相同的座位直方圖。
可以引入鄰座懲罰而非硬禁止,令每個相鄰雙人組額外乘上一個係數 。當 時返回原始硬核模型;當 時相鄰完全不受罰,配置數變為一般獨立座位的情形;介乎兩者之間則描述不喜歡貼坐但在繁忙時願意妥協。此時可用二乘二的轉移矩陣追蹤前一個座位是否有人,矩陣元素同時包含新入座者權重與相鄰懲罰。這個延伸能用同一套方法比較「空位偏好」與「不可違反的規則」,但本批三張圖只顯示原先已實作的硬限制與活動權重模型,沒有混入未計算的軟排斥數據。
對觀測設計而言,研究者若在中午一點只拍一張照片,得到的是某一時刻的佔用截面;它不同於一小時內所有到訪者的選座序列。要推斷座位選擇機制,應記錄入場順序、群組大小、桌椅配置、服務時間及是否因沒有理想座位而離開。若連「未入座者」都不記錄,便可能把自我選擇造成的稀疏座位分佈錯誤歸因於普遍的隔位規範。
9. Limitations — 研究限制
座位被假定為一列等距且只有最近鄰排斥,忽略通道、靠牆偏好、桌子分區、輪椅位置和多人一同用餐。等權分佈是任意選定的合成生成機制,不代表真實人類均勻抽選格局。活動參數沒有從實測估計,斐波那契遞推也不等於有時間先後的入座動力學。
10. Conclusion — 結論
直線座位在相鄰互斥的規則下,合法佈局數是斐波那契數;20 座共有 17,711 種配置、最多坐 10 人,但等權抽樣平均僅約 5.68 人。局部的「隔一個位」偏好可以透過圖論與配分函數,轉化為嚴格可計算的全局容量效應。
11. Future Research — 未來研究方向
後續可增加雙排桌位、四人方桌、朋友共同入座與中途離座,使用圖獨立集、轉移矩陣或拒絕抽樣。若取得經同意的匿名座位使用紀錄,可用似然法估計軟排斥參數,並比較硬限制與軟偏好模型的預測誤差。
Appendix — 附錄
data/count_at_z1.csv 提供精確組合係數及概率;data/mean_occupancy.csv 儲存活動參數掃描。斐波那契初值 避免常見的索引偏一錯誤。模型隨機抽樣以配置的座位數概率為目標,適合檢查分佈,並未生成連續到場過程。
可用三種計算法驗證配置總數。第一種對小型 枚舉全部二元座位向量,刪除任兩個相鄰位置同時為一者;第二種使用斐波那契遞推;第三種加總 。在小規模下逐一對照,能防止遞推初始條件與組合索引出錯。對二十座而言,再確認抽樣概率非負、總和為一、所有可能的人數均在零至十之間。
加權模型另可用直接機率加權求 ,以及對 微分求得相同值。變異數可以由二次動差計算,並與第二次對數微分核對。數值抽樣結果若落在合理的標準誤範圍,代表程式與模型相符;它並不代表顧客真的按照配分函數決定座位。
真實的食堂資料應區分單獨進入與結伴而行、入座先後順序、不同時段以及不同座位的吸引力。朋友可能願意相鄰而坐,帶行李者則可能額外佔位,兩者都違反目前的硬限制。後續研究可把禁止相鄰改為帶成本的軟限制,或把路徑圖改為二維桌椅格網,再檢查模型對實際佔用比例的預測誤差。
也可直接推導恰好有 人的合法座位配置數。先將 位入座者排成必有一個空位分隔的骨架,已使用 個座位;剩餘 個空位可分配在兩端與內部間隙。以隔板法可得配置數 。因此在固定 與權重 下,人數分佈為 ,所有合法值由零至 。這個分佈可以直接生成每個人數的精確概率,毋須依賴抽樣直方圖。
若轉而使用座位密度作比較,應小心分母的選擇:二十個座位中有十個最多可坐,並不代表每人理性地只會選擇一半容量;那只是禁止相鄰的組合上限。期望佔用約 5.68 人低於十人的最大容量,差距取決於所有合法圖樣的概率加權。若要在大座位列上生成精確樣本,可以先由動態規劃計算各剩餘區段的配分函數,再依條件權重在「當前留空」與「當前入座並略過下一位」兩種選擇之間抽樣。這毋須事後剔除大量非法圖樣,也能與組合數的解析公式交叉驗證。若座位不是直線而是圍成圓桌,頭尾兩位也會互相接觸,故路徑圖模型必須改成環圖;將最後一個座位的約束遺漏會系統性高估合法配置數。這項幾何差異說明,建模前應先準確記錄桌椅的連接關係。
12. References — 參考文獻
- Schelling, T. C. (1971). Dynamic models of segregation. The Journal of Mathematical Sociology, 1(2), 143–186. https://doi.org/10.1080/0022250X.1971.9989794
- Shannon, C. E. (1948). A mathematical theory of communication. Bell System Technical Journal, 27(3), 379–423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x
- Hoeffding, W. (1963). Probability inequalities for sums of bounded random variables. Journal of the American Statistical Association, 58(301), 13–30. https://doi.org/10.1080/01621459.1963.10500830
本文是虛擬學術研究所的原創模型演練;它不是實地研究或同行評審期刊論文。
所有模擬數值均可在同一資料夾的 data/summary.json 與程式中核對。