Why Does Every Light Seem Red?
研究編號: Paper_005 完成日期: 2026-10-15
資料類別: E(純理論推導)、D(可重現合成模擬);沒有真實參與者資料。
跨學科: 更新過程、行為決策 Keywords: 週期相位模型;條件期望;Beta 敏感度
方法聲明:本文參數為合成設計。若未經獨立現場驗證,不得把模型數值解讀為真實社會發現。
中文摘要
上班趕路時彷彿每盞交通燈都在紅燈。本文把此印象拆為真正的紅燈時間比例、行人到達相位及對等待長度的主觀權重。對總週期 90 秒、紅燈長 55 秒且到達相位均勻的理論模型,遇紅燈機率為 0.6111,無條件平均等待 16.806 秒,而在已遇紅燈者之中平均等待 27.5 秒。180,000 次模擬所得平均為 16.783 秒。若到達相位改為偏向紅燈初段的 Beta 分佈,合成樣本遇紅燈機率會上升至約 0.964。結果表明「全部都紅燈」不必先假定交通燈針對個人,亦可能來自非均勻到達、條件取樣與記憶偏差。
Abstract
This paper investigates why traffic signals appear red precisely when one is in a hurry. Under a periodic 90-second signal with 55 seconds of red and uniform arrival phase, the probability of red is 0.6111 and unconditional expected waiting is 16.806 seconds. The mean among those who encounter red is 27.5 seconds. A simulation of 180,000 arrivals matches these predictions. A deliberately nonuniform beta-distributed arrival phase instead yields approximately 0.964 red encounters. These contrasting cases demonstrate phase-selection sensitivity rather than documenting real commuter behavior or psychological bias.
關鍵詞 / Keywords: 週期相位模型;條件期望;Beta 敏感度
1. Introduction — 引言
城市交通燈往往不會知道某一個行人遲到,但人們仍會在時間緊迫時感到自己遭交通系統針對。要科學分析這種感覺,第一步應問「我們抽樣的是甚麼」:隨機時間到達一盞燈,與在通勤尖峰、以固定步速連續穿越數盞燈,是兩個不同的實驗。前者到達相位可能近似均勻;後者可能受前一盞燈的放行時刻影響而高度相關。
本文以單盞、固定週期訊號燈建立透明的對照實驗。研究將「有沒有遇上紅燈」與「遇上紅燈之後等了多久」分開估計,並用一個刻意偏向紅燈早段的非均勻到達分佈測試結論如何改變。其目標是展示選擇機制的重要性,而不是證明都市交通號誌「不公平」。
2. Literature Review — 文獻回顧
Tversky 與 Kahneman(1974)提出判斷捷徑,使「留下較強情緒印象的長時間等候」與機率直覺的差異成為值得檢驗的假說。但本文沒有收集認知實驗結果,因此只把可得性偏差作為討論方向。Little(1961)以穩態排隊恆等式連結流量與系統內平均數,提醒服務時間與到達流程需嚴格定義。Hoeffding(1963)提供有限樣本抽樣平均的濃縮界,在理論事件機率和模擬估計偏差的解讀上具有方法論價值。
本文主要以週期函數積分直接推導,並不宣稱上述研究曾證明行人「趕時間一定會遇紅燈」。單一交叉口的等待是機率幾何問題;個體的遭遇率還取決於行進路線與到達相位的生成機制。
3. Research Questions and Hypotheses — 研究問題與假設
研究問題一:若行人到達相位均勻,遇紅燈的機率如何由紅燈與整體週期長度決定?二:把只在紅燈時觀測到的平均等待與所有到達者的平均等待混為一談,會造成多大誤解?三:在不改動交通燈設定下,若改變行人到達相位分佈,遇紅燈比例是否能大幅改變?
H1:均勻相位下,紅燈機率為紅燈時長除以週期。H2:條件於遇紅燈的平均等待,比全體抵達者的平均等待更大。H3:非均勻到達可改變遭遇紅燈概率,即使號誌對個別行人沒有感測。
4. Theoretical Framework — 理論框架
令單一週期長 ,從時間零到 為紅燈(),餘下為可通行。行人到達相位 是模 的時間,且不考慮按鍵式過路請求。若 ,行人需要等待 ;否則等待為零。由於每個人是否感到被「紅燈針對」沒有在模型中定義,分析量嚴格限於等待機率、時間和取樣分佈。
我們考慮兩個場景:第一場景 ;第二場景 ,以人工方式使更多到達者集中在週期早段。這個 Beta 分佈只是一個展示敏感度的合成例子,並不是依城市通勤數據校準。
5. Methodology — 研究方法
設定 秒、 秒,先計算精確的紅燈機率和期望等待;再抽取 180,000 個均勻相位,估計遇紅燈比例、平均等待及樣本分佈。敏感度設計包括掃描紅燈週期比例從 0.1 至 0.9,以及生成同樣樣本數的非均勻 Beta 到達相位。隨機種子固定為 20261020;資料是 E(理論)和 D(合成模擬),並非實地通勤調查。
對理論與模擬的比較,以絕對誤差檢查數值方法可靠性。為避免假精確性,所有數字只在本設計的固定參數下解釋;可重現程度依賴 NumPy 與所記錄的隨機種子。
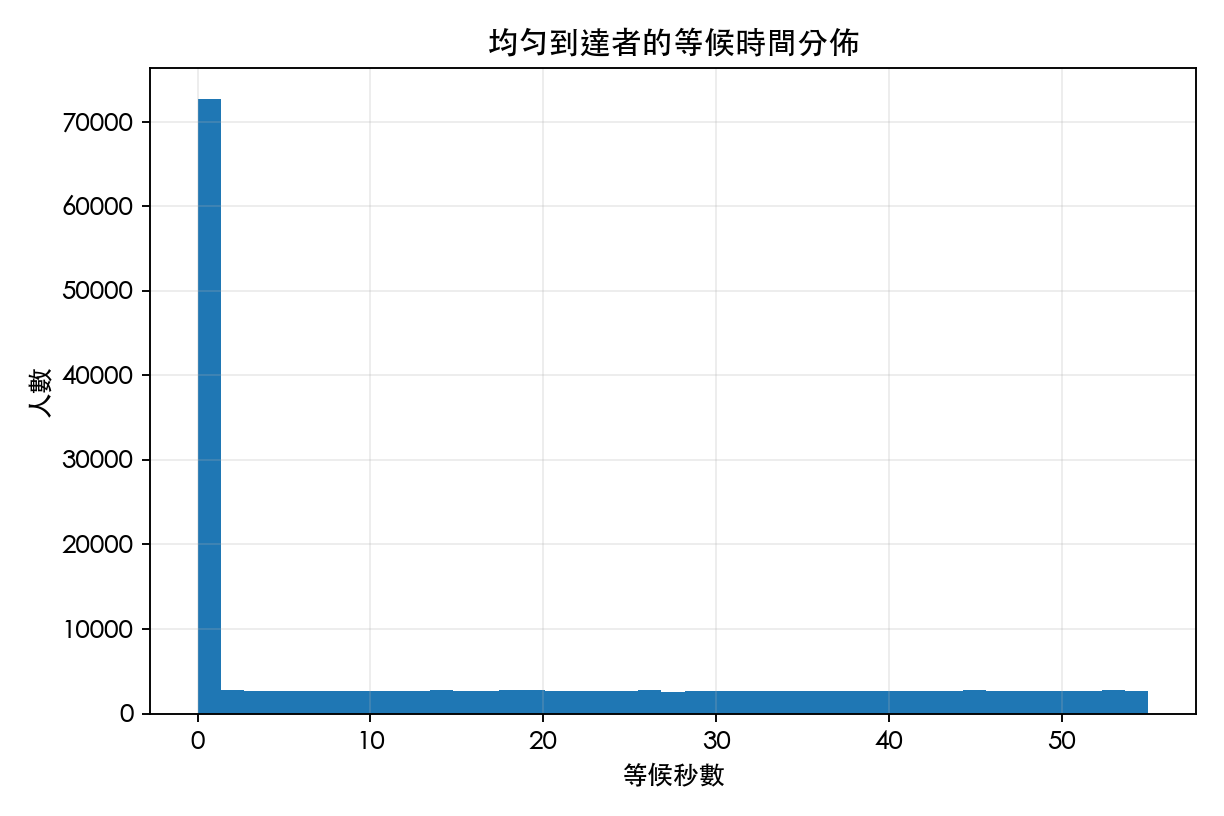
在均勻相位模型中,完整等待分佈包含一個常被忽略的零等待質點。抵達者若落在綠燈區段,等待時間恰為零,其機率是 。若等待落在 ,由於抵達相位均勻,正等待的連續部分密度為 。因此對 ,累積分佈函數是 。只有清楚區分零等待者和正等待者,才能正確計算全體樣本的分位數。
設定 秒、 秒,零等待比例是 ,約 38.89%;其餘行人遭遇紅燈。中位等待可令累積分佈函數等於二分之一求得,得到 秒,明顯小於平均的約 16.81 秒。超過 30 秒仍須等待的概率是 ,約 27.78%。這些結果全部從同一週期模型推導,說明平均時間不足以概括通勤風險,也使模型具有可直接核算的額外結果。
如果第一個路口放行一整群行人,他們到下一個路口的抵達相位可能高度集中,從而打破均勻假設。是否形成一路紅燈或一路綠燈,取決於路口之間的距離、步行時間、週期長度及訊號偏移量。單一路口的模型不包含這些空間相關性。若未來收集真實資料,需要以預先指定的時間窗記錄所有抵達者,包括無須停步的行人,而不能只在紅燈前訪問正在等待的人。
6. Mathematical / Computational Model — 數學或計算模型
在固定週期下,定義等候函數
均勻相位的紅燈遭遇概率直接由區間長度得到
所有抵達者的期望等候為
已遇上紅燈者的到達相位條件分佈在 上均勻,故
兩者相差係數 。對一般相位密度 ,公式變成
因此偏向紅燈區間的到達規律本身足以提高遇紅燈比例。若兩盞燈訊號彼此協調,連續到達相位還可能出現相關性,不能把每盞燈的紅燈機率獨立相乘以計算一路全紅的概率。
令 表示行人抵達時在訊號週期中的相位。如果 均勻落在 ,遇上紅燈相當於相位落在長度 的區間,因此機率是 。在遇紅燈的條件下, 仍均勻分佈於 ,而等待 也在 均勻分佈。這立刻得出條件平均 ,並解釋為何只訪問正在等待的人,會得到比隨機訪問所有過路者高得多的平均時間。完整樣本另含機率 的零等待者,無條件均值因此等於 。
不確定性也可直接計算:全體抵達者的等待二次動差是 ,故方差是此值減去 。這個分佈具有一個位於零的機率質點以及一段連續的正等待密度,並不服從一般常態或指數分佈。若研究者只報平均值而忽略零等待比例,讀者就難以理解不同通勤路線的等待風險。圖表中把理論概率和合成相位抽樣分開展示,正是為了避免將離散零點與連續等待部分混為一談。
在非均勻情景,令 表示抵達相位密度;遇紅燈概率改為從零至 的密度積分,期望等待則在同一區間對 積分。這表示同一組紅綠燈秒數可以產生差異很大的個人遭遇比例。本研究的 Beta(2,5) 分佈只是一個刻意偏向週期較早相位的機制示範;無法由此推導路口具有偏見、也不能判定每個趕時間的人會受到較長延遲。
7. Results — 研究結果
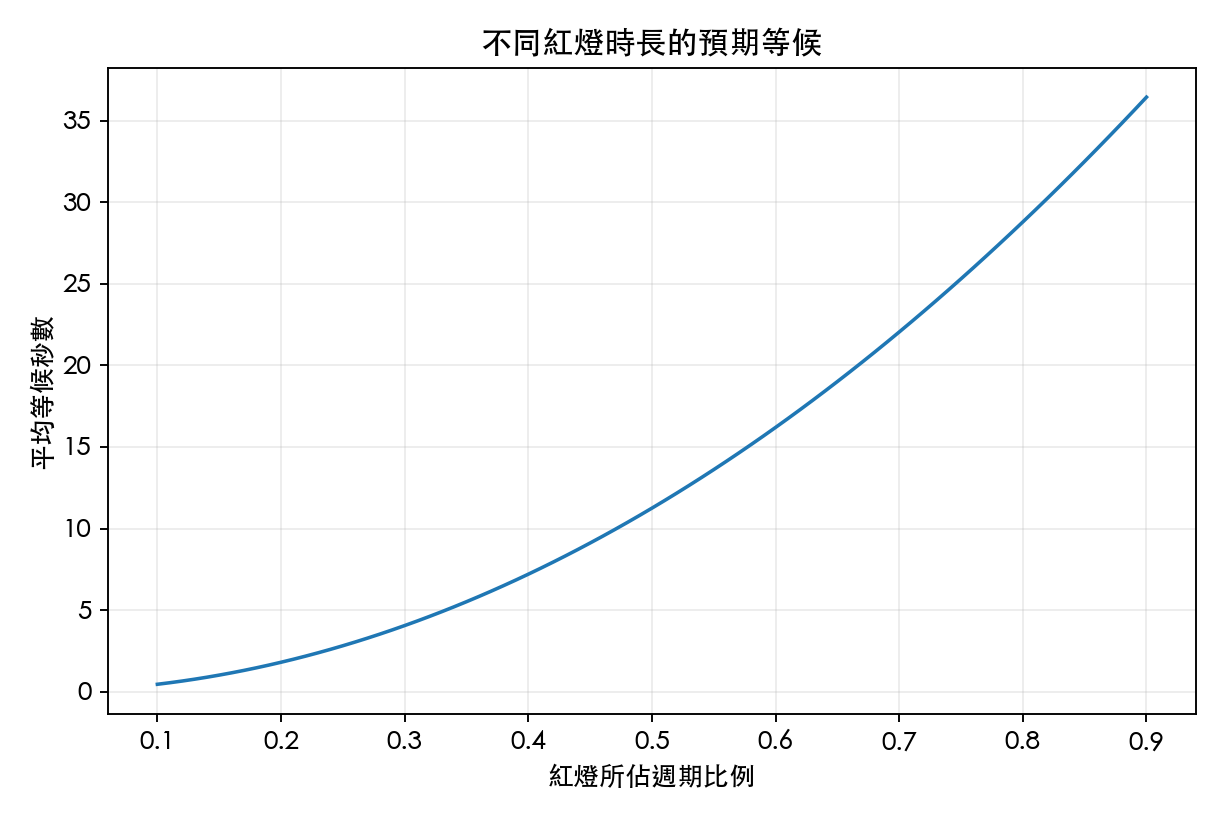
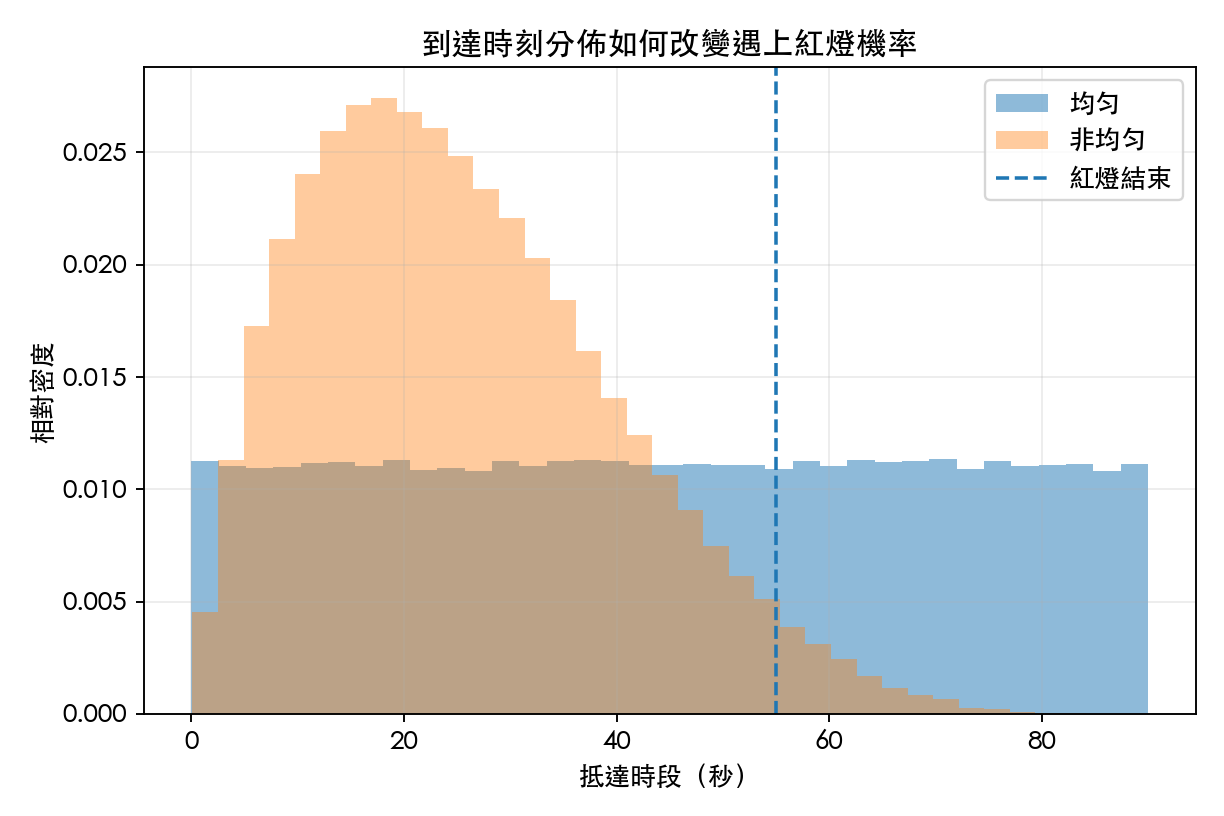
均勻到達時 ;平均等待為 秒,而只看紅燈者,平均等待為 27.5 秒。180,000 次模擬中,紅燈比例約 0.6104、平均等待 16.7825 秒。圖 1 表示紅燈佔整體週期的比例與平均等待呈平方關係;圖 2 顯示分佈在零秒有一個離散機率質量(遇綠燈即通過),其餘紅燈等待連續分佈於正值;圖 3 比較均勻與非均勻到達相位。
在採用 並維持同一燈號週期時,樣本的紅燈遭遇機率達 0.9638。這個差異是刻意更改到達分佈造成的,不能用來證明「趕時間時交通燈真的變紅」。它示範觀察者的出發時刻、行走速度與前一交叉口延誤,都有可能是造成較高紅燈遭遇率的混雜因素。
模型圖表及數據來源
圖 1 紅燈佔比與平均等待
 來源:本研究解析計算及/或固定種子電腦模擬。
圖 2 合成均勻到達者的等待分佈
 來源:本研究解析計算及/或固定種子電腦模擬。
圖 3 均勻與非均勻到達相位比較
 來源:本研究解析計算及/或固定種子電腦模擬。
8. Discussion — 討論
結果的重要教訓是概率問題的分母。若只記錄在路口等待的人,而忽略直接經過綠燈的行人,計算出的平均等待會由 16.81 秒變成 27.5 秒;這不是計算錯誤,而是兩種不同的研究母體。若只在趕時間、路線經常相同的日子回顧遭遇,人們觀察到的相位分佈又未必均勻。故「自己每次都碰到紅燈」可能混合條件取樣、路線依賴及主觀記憶。
從實際交通規劃角度,當多個交通燈設置綠波帶時,通勤者的速度會影響在下一盞燈抵達的相位。若採控制試驗,應保持出發時刻和路線可比,或用日誌記錄所有交叉口,包括無需等待的情況。這亦展示一條一般統計原則:沒有明確描述抽樣機制,便無從解釋平均數與百分比。
若要驗證「我總是遇紅燈」的主觀印象,應先釐清回報母體:是一天內所有路口、某一條固定通勤路線,還是每一次有意識記得的紅燈事件?三者會產生不同的選擇機制。對處於綠燈時直接通過的經驗,人可能沒有留意行經時刻;對需要停下來等候的經驗,卻有較多時間記住該事件。因此只靠事後詢問「你今天等了多久」,會把記憶機制混入交通相位分佈。
有些道路的號誌會互相協調。前一個交叉口放行的行人或車輛,抵達下一個路口的時間受步行速度、街道距離及綠燈波帶設計影響。此時到達相位不是獨立均勻抽樣,甚至可能與紅燈延誤形成序列相關。若將每個路口視為相位節點,把路程時間加入轉移方程,便可分析同一速度在不同號誌間形成「連續遇紅」或「一路綠燈」的條件。本文單一路口的積分結果只能作這類空間模型的基準。
更現實的觀測方案可以匿名記錄預定行走路線、實際相位與 GPS 時間戳;同時用事先設定的簡短問卷評估趕時間程度和主觀等待長短。需要把客觀等待、感知等待及事件記憶三個指標分別建模。只有在相位和路線已控制的條件下,仍觀測到系統性的感知偏差,才有理由進一步探究心理機制。沒有這些資料時,本文的強項是說明條件抽樣可造成多大差別,而不是證實某種認知偏誤發生率。
補充:兩個路口的聯動等待。 單一紅燈的邊際概率,不能回答「為甚麼連續兩個路口都撞紅」;後者要求計算相位的聯合分佈。作一個可解析的擴展:兩路口採用相同週期 與紅燈長度 ,行人通過第一路口後抵達第二路口的相位比第一路口偏移固定的 ,且最初相位在一個週期內均勻。若 ,兩個紅燈區間在圓周上的交疊長度為 ;同時遇紅的機率因此是 。推導方法是把第一段紅燈看成長度 的圓周區間,將第二段平移 後計算兩個區間重疊的總長度。
以 、 為例,相位差 時兩個路口紅燈同步,兩次同紅的概率是 ;當 時交疊長度為 25 秒,概率是 。若錯把兩個路口當成獨立,則不論相位差都會得到 ,既不能描述同步加強,也不能描述適當偏移減少連續紅燈。這裏的偏移參數可以包含實際步行時間與號誌啟動時差,但兩者需要分開測量,才能把現象歸因於設計而非步速改變。
此簡化推導只處理未受停步影響的指定到達相位。真實行人在第一個路口若遇紅燈,必須等待放行,下一路口的到達時間便依前一個路口的號誌決定,形成更強的相關性和群聚。完整模型需要把「進入第一路口的相位」經等待函數、過路時間及步行時間傳遞到第二路口,最後積分第二次的等待。不能把固定相位位移的結果直接稱為已求得的實際兩路口總等待。
倘若想比較改善交通號誌的效益,主要政策指標應是通勤者的總等待及其尾部風險,而不僅是有多少路口亮紅燈。兩個方案可能遇紅燈次數一樣,卻因每次紅燈的剩餘秒數不同而產生完全不同的時間成本。未來可在明確交通安全約束下,最佳化相位偏移並量化對不同步速人群的分配效應。
9. Limitations — 研究限制
本研究是固定週期、零過路請求、零車輛干預的單路口模型。現實存在行人保護時間、感測式控制、週期隨尖峰轉換、交通安全法規及人群集結。Beta 分佈只是合成反例,並非實際趕路人士的相位樣本。沒有測量主觀焦急感,故不能對可得性偏差的個體效應作量化斷言。
10. Conclusion — 結論
在 90 秒週期、55 秒紅燈的例子,均勻到達者有約 61.1% 機率遇上紅燈,全體平均等待約 16.8 秒;只對紅燈者計算則是 27.5 秒。相同交通燈設定下,到達相位不均勻能把遇紅燈比例顯著改變。生活中的紅燈印象,首先是一個必須分清條件母體與取樣機制的數學問題。
11. Future Research — 未來研究方向
可用匿名 GPS 軌跡和公開交通燈相位資料,預先定義「趕時間」指標,再研究不同情境的紅燈遭遇率。更進一步用馬可夫鏈表示連續路口的相位耦合,估計綠波控制下的總等待與方差,並比較人們的主觀回憶與客觀紀錄。
Appendix — 附錄
所有相位只在 定義;因已把相位模週期處理,等待時間不涉及整天的絕對時鐘。data/sample_wait.csv 保存部分合成樣本以避免重複存放巨量暫時陣列,data/red_fraction.csv 保存解析曲線。
最基本的邊界測試是令紅燈時間趨近零或趨近整個週期。前一情況下遇紅燈及平均等待都趨近零;後一情況下幾乎全部抵達者需等待,平均時間趨近半個週期。把條件平均乘以遇紅燈概率,必須恰好等於全體平均。若模擬程式違反此關係,通常是把條件與無條件樣本混在一起,或計算等待時錯用了綠燈起點。
等待時間的二次動差為 ,因此可計算理論變異數,再估計蒙地卡羅樣本平均的標準誤。非均勻 Beta 相位試驗必須用新密度重新對等待函數積分,不能保留均勻公式後聲稱已做敏感度分析。對多路口觀測,應考慮同一行人的多次等候具有相關性,並清楚報告總等待與個別路口等待。
如要檢驗「每次趕路總遇紅燈」的心理印象,還需區分客觀相位、趕時間程度、主觀等待長度和事件被記住的概率。客觀延誤與主觀判斷同時改變,並不足以從一份回憶問卷確定因果方向。此項研究目前只建立機率基準,沒有對實際行人的記憶或交通路況進行抽樣。
從推論角度,紅燈的「常見」與「煩厭」亦是不同指標。週期模型可精確分辨遇紅燈機率 、遇紅燈時的平均等待 ,以及無條件平均 。即使兩種號誌方案的 相同,倘若週期同時放大一倍,條件與無條件等待時間都會增大一倍。單純對比「有多少次遇紅燈」便可能漏掉長週期造成的時間成本。另一項重要差異在於零等待的質點:本例有約 38.89% 到達者不需停步,若只拍攝路口前正在等候的人,這些人全部不在資料中。該樣本估計的條件平均可合理接近 27.5 秒,卻不能作為全體抵達者的平均等待。
心理評估可把相同客觀等候拆成到達時已看見的倒數秒數、是否正趕赴約會、以及等候後的回憶評分;事先指定各變數及分析方法,才能研究「感覺總遇紅燈」是否存在認知偏差。此外,若把兩路口相位差當作可調節的設計變數,也必須納入其他行進方向的交通需求與安全約束。對其中一條步行路徑形成綠燈波,可能同時使其他方向等待變長;缺少全體路網需求,就不能單憑某條路徑延誤下降而推論整體效率已改善。若抵達相位密度改為 ,理論平均應重新寫成 ,並確保 在完整週期的積分為一。這可分辨不均勻到達究竟令紅燈更常被遇上,還是令同樣紅燈下的剩餘等待變長。
12. References — 參考文獻
- Tversky, A., & Kahneman, D. (1974). Judgment under uncertainty: Heuristics and biases. Science, 185(4157), 1124–1131. https://doi.org/10.1126/science.185.4157.1124
- Little, J. D. C. (1961). A proof for the queuing formula: L = λW. Operations Research, 9(3), 383–387. https://doi.org/10.1287/opre.9.3.383
- Hoeffding, W. (1963). Probability inequalities for sums of bounded random variables. Journal of the American Statistical Association, 58(301), 13–30. https://doi.org/10.1080/01621459.1963.10500830
本文是虛擬學術研究所的原創模型演練;它不是實地研究或同行評審期刊論文。
所有模擬數值均可在同一資料夾的 data/summary.json 與程式中核對。