Why Does a USB Connector Seem to Need Three Flips? A Bayesian Decision Model of Orientation, Misalignment, and Information
研究單位: 荒誕學術研究所(Institute of Absurd Academic Research) 研究類型: 純理論與可重現合成模擬 日期: 2026-10-16
中文摘要
傳統 USB-A 插頭只有一種可插入方向,卻經常被幽默地形容為「先試一次,翻過來,再翻回去才成功」。本文不把這種敘述當作實測事實,而將之轉化成一項可精確求解的序貫決策問題:插頭正確方向未知,即使方向正確仍可能因對準不良而插入失敗,故每次失敗只提供不完全訊息。研究建立二元隱藏方向的有限期部分可觀察馬可夫決策模型,定義貝氏後驗、翻轉成本、一次性視覺提示、最多六次嘗試及停止損失。解析推導證明:在兩個方向具有相同條件成功率時,依序在方向 0 與方向 1 都失敗後,方向 0 的後驗會回到初始先驗;因此「0→1→0」在特定低翻轉成本條件下可以是條件最優路徑。於全為研究者設定的基準參數下,容許先觀察外形的最優策略,預期總成本為 2.327362,強制每次失敗就翻面的規則為 2.819358,差額約 0.491996 人工成本單位;這不是產品或人類行為的測量結果。35,000 次固定種子合成蒙地卡羅、短期模型獨立窮舉及分枝列舉相互核對。五張圖說明政策區域、策略成本、成功率敏感性、資訊價值及後驗軌跡。研究亦指出:插頭表面的可見方向線索可以改變最優操作,但其價值須扣除辨認成本;真實應用必須以實測資料重新估計參數。
關鍵詞: USB-A、貝氏更新、部分可觀察馬可夫決策、資訊價值、有限期動態規劃、動作失敗、合成蒙地卡羅
English Abstract
The joking claim that a USB plug requires several flips is recast as a finite-horizon Bayesian decision problem, not treated as an observed average. For an orientation-sensitive USB-A connector, the correct orientation is latent, and a correctly oriented insertion may still fail due to misalignment. Failed attempts therefore update rather than determine the orientation belief. We derive the failure posteriors, a Bellman recursion with switching and stopping costs, and the value of one optional visual cue. Two failures with opposite orientations exactly cancel in likelihood-ratio space when alignment success probabilities match. In a deliberately hypothetical six-attempt example, the optimal policy has expected cost 2.327362 units compared with 2.819358 for obligatory alternation; a distinct low-switching-cost condition yields an optimal conditional path of orientations 0, 1, 0. Independent enumeration, exact policy evaluation, and seeded Monte Carlo corroborate the calculations. The model provides a falsifiable decision-theoretic explanation but no empirical claim about USB manufacturing, real users, or actual numbers of flips.
Keywords: USB Type-A; Bayesian belief updating; POMDP; alignment failures; visual cues; finite-horizon optimization; synthetic simulation
1. 引言:一個方向只有兩種可能,為何感覺有第三面?
在一段流行的電腦使用笑話中,人們把傳統 USB 插頭形容成擁有三種方向:第一面插不進,翻成第二面仍插不進,最後翻回第一面才插得進。從幾何來看,一個只能上下兩面選擇的插頭不可能真的長出第三種方向。若兩次失敗能完全辨識插頭朝向,第三次的嘗試似乎尤其沒有道理。然而日常動作並非理想化的幾何判斷:方向可能正確,手部仍可能因高度、傾角、端口阻力或視線而未能完成插入。因此,「插不進」不是「方向一定錯」的同義詞。這個簡單但常被忽略的觀察,為從概率與決策理論解開笑話提供一個切入點。
本文研究的是傳統具有方向限制的 USB Type-A 插頭的抽象問題,不包括可雙面插入的 USB-C。方向 0 與方向 1 是任意編號,並非某一品牌的官方朝向標識。令隱藏變數 H 指出目前物件真正可插入的朝向;使用者只知道其先驗機率,選擇一個朝向進行插入,然後收到成功或失敗訊號。正確朝向成功的條件概率 s 可小於一,錯誤朝向則假設必定失敗。這個非對稱觀察機制既足夠簡潔,可以導出明確的似然比,也足夠豐富,可以讓「試過失敗」與「知道錯誤」不再等價。
研究動機不只是替笑話找到一套公式。當一項行動既可能完成目標,又可能提供資訊,決策者便面對典型的探索與利用問題:到底應繼續相同動作以排除對準噪聲,改變方向以測試另一假設,還是先花少量時間看清楚插頭上的辨識線索?如果每次翻轉有額外時間或手部成本,選擇最可能正確的方向也不必然使總期望成本最小;如果最多只允許嘗試六次,最後一次之前的決策還必須考慮無法完成任務的代價。這些取捨使問題成為一個有限期的部分可觀察馬可夫決策過程,而非簡單的猜硬幣遊戲。
文章提出三項不同層級的貢獻。第一,從貝氏定理推出失敗後的精確更新規則及兩次相反方向失敗的消去恆等式,指出「翻回原方向」在何種資訊條件下可以合理。第二,建立含翻轉、一次性觀察與停止代價的 Bellman 遞迴,利用窮舉核對有限期最優政策。第三,提供可重現計算及五種互補可視化,使結論不依賴不可公開的調查或筆記。研究資料全部屬研究者指定的合成世界,沒有採訪任何人、沒有測量任何 USB 插孔,亦沒有觀察真實插入次數;數值只在明列參數及假設之下成立。
本文所謂「三次」有意仔細區分語義。若操作序列是朝向 0、朝向 1、再朝向 0,那是三次方向選擇、兩次方向翻轉,而非實際翻轉三次。日常笑話混用「翻了三次」與「試了三次」,如果研究者也混用,便會在成本方程中把翻轉次數多算一次。本文因此分別記錄嘗試數 A、翻轉數 F、提示觀察數 O,以及最後成功與否,並明確給出它們各自的成本。這項術語上的嚴謹看似過分,恰恰是把荒誕問題研究得可信的第一步。
2. 文獻回顧:從不完整觀察到有限期規劃
Smallwood 與 Sondik(1973)的有限期部分可觀察馬可夫過程研究,構成本研究的數學基礎之一:當系統的真實狀態不能直接取得,而決策影響後續觀察,最適控制可以透過資訊狀態而非不可見的物理狀態來描述。這裏借用的是決策結構,而不是該文任何特定應用的參數或實驗結果。本文的狀態 H 只有兩個可能值、物理方向在一次插入流程中固定不變,因此貝氏信念可由單一數字表示;這比一般具有大量隱藏狀態和狀態轉移的 POMDP 簡單得多,但保留了觀察、動作、更新與規劃的核心問題。
Kaelbling、Littman 與 Cassandra(1998)對部分可觀察隨機環境中的規劃與行動作出系統性論述,說明信念狀態可以把一連串歷史壓縮成足夠進行決策的摘要。對 USB 問題而言,無需保存每次手指角度或完整插入歷史,只要模型的假設正確,當前的 b=P(H=0|歷史)、上一個嘗試方向、剩餘嘗試數及有否使用提示,就足以計算後續最佳選擇。這項「足夠統計量」不是說真正的人會依公式心算,而是說演算法只需要相關概率資訊,就可以解答研究者定義的最適化問題。
Ross、Pineau、Paquet 與 Chaib-draa(2008)回顧 POMDP 的線上規劃演算法,提醒讀者一般 POMDP 需要仔細權衡計算負擔與政策品質。本研究故意採用二元狀態與最多六次插入,不借用大型近似演算法;其好處是可以用兩套結構不同的遞迴相互檢查,減少把程式錯誤誤認為神秘行為規律的可能。若日後加入多種插孔阻力、方向依賴的摩擦、不同觀察精度或會隨動作改變的端口狀態,信念空間會變成更高維度,屆時點式值迭代或近似動態規劃才可能真正有必要。
在認知背景上,Tversky 與 Kahneman(1974)研究人們面對不確定性時使用的啟發式與判斷偏差,能為理解「一次失敗就是方向錯」這類直觀捷徑提供概念上的提醒。但這篇文獻沒有對本研究的 USB-A 插頭做任何實驗;由它不能推出真實使用者一定採用交替策略,更不能推出我們設定的翻轉成本。Langer(1975)討論控制錯覺,使人注意到「多做一次動作」不一定能增加任務完成概率;然而在本文的模型內,翻轉可以改變選擇朝向並改善成功率,故並不能簡單歸結為純心理安慰。對啟發式與模型決策的比較,是研究者提出的理論問題,並非沿用文獻的實驗數據。
Hick(1952)討論選擇與資訊取得的心理學關係,提醒我們「先看清楚朝向」同樣耗用人的認知與時間資源。本文對視覺提示定義準確率 q、支付成本 c_o,但兩者是刻意抽象化的參數;視覺標誌的顏色、光照、視力、插孔位置及個別人士的操作習慣均會影響實際值。把資訊成本放進 Bellman 方程並非聲稱認知過程可完全化為固定 0.4 單位,而是讓「先看是否值得」變成有明確價格與可比較後果的問題。此一取捨具有跨領域意義:工程上的方向標記、介面辨識與使用者的序貫操作,都可以用可觀察性改變決策損失的觀點來分析。
既有研究提供的是方法、形式與行為背景,並沒有提供 USB 插入失敗時可用的真實估計。本文填補的並不是已被證實的實測空缺,而是一項可檢查的模型推論空缺:如果正向插入仍有失敗率,怎樣改變先驗、後驗及最佳行動?如果把失敗當成完美診斷,答案是否會變得不同?視覺訊號的價值在何時抵不過其成本?這些問題可以不依賴實地調查而先獲得條件性數學答案;但由模型走向產品改善,仍需要專門採集資料並估計參數。
3. 研究問題、假設與反例設計
研究問題 RQ1:在兩個朝向中,假如方向正確仍只有 s 的插入成功率,觀察到失敗後應如何更新對正確方向的信念?我們的可證命題 H1 是:當 0 與 1 方向的條件成功率相同且所有嘗試在給定 H 後獨立,對相反朝向各失敗一次,其似然比效應恰好互相抵銷,最後後驗等於初始先驗。這不是「失敗沒有資訊」:第一次失敗強烈支持相反方向,第二次失敗則提供方向相反且同樣強的證據,因而在這個特別對稱的條件下抵銷。若其中任何一項條件不成立,等式便可能失效。
研究問題 RQ2:即使每次只能選擇 0 或 1,為何當前最可能正確的朝向未必就是成本最小的下一步?H2 是有條件而非普遍的最優性敘述:在指定有限期、停止損失、翻轉價格與提示價格下,貝氏值函數選出的動作,其合成期望總成本不高於同一模型可行行動類別中的任意固定策略。這屬 Bellman 最優性原理而非新的人類行為定律;為防止將計算器的輸出當成證明,本文採用短期全部分枝窮舉作獨立核對,並將每個比較策略接受相同嘗試預算與失敗損失。
研究問題 RQ3:先把插頭或端口形狀看清楚是否應該是預設的首選動作?H3 是在已知信號準確率 q 和觀察成本 c_o 的條件下,允許選擇一次視覺觀察的最優值函數,不會高於完全禁止觀察時的最優成本。這是一項決策集合包含關係:允許觀察不等於強迫觀察。若觀察昂貴或訊號幾乎沒有辨識能力,最優策略仍可跳過這個選項。模型預測資訊存在一個成本門檻;是否在真實使用者身上存在同一門檻,並非本次研究已獲驗證的事實。
研究問題 RQ4:翻轉成本對「0→1→0」序列有甚麼影響?H4 指出,當翻轉代價接近零,而初始先驗稍偏向朝向 0 時,先以 0 嘗試、失敗後改以 1、再失敗後回到 0 可以符合貝氏最優選擇。當翻轉變得昂貴、提示變得準確或停止代價下降時,同一序列不一定仍然最優。這讓流行笑話獲得一個可反駁的邊界:它不是任何插入過程的必然法則,只是在某些可靠度和成本條件下可發生的決策路徑。
最後,我們明確設計至少三項反事實。第一,令 s=1,正確方向永遠成功;此時一次失敗就足以排除被嘗試的方向,「兩邊都失敗」在封閉模型內不可能同時發生。第二,令兩個方向具有不同的條件成功率,對稱抵銷的似然比不再成立。第三,容許錯向也以很小的概率成功,例如插入異常、意外接觸或使用了其他接頭,則失敗後的更新式亦要重新推導。這些反例用來確定假設的作用範圍,避免將形式美觀的恆等式誤寫為不分產品與工況都成立的物理定律。
4. 理論框架與行動—觀察流程
令 H∈{0,1} 為固定但未知的正確方向,其初始機率 P(H=0)=b_0。每次尚未完成插入時,可作四類動作:朝向 0 插入、朝向 1 插入、若尚未使用則支付價格取得一次帶噪聲的方向提示、或者停止並承擔未完成損失。成功即流程終止;失敗則剩餘嘗試數減一,信念按貝氏規則更新,上一個朝向記錄為本次的操作方向。觀察提示本身不扣減插入預算,但只允許使用一次,以避免無限觀察造成難以解釋的迴圈。停止既可在預算用盡時強制發生,亦可在已知未來不合算時主動選擇。
模型將插入分成方向判斷與實際對準兩個隨機機制。當 action a 等於 H,插入以概率 s 成功、以 1−s 失敗;當 a 不等於 H,成功概率為零。不同嘗試的對準誤差在固定 H 和 s 的條件下假設獨立,故一連串正向插入失敗的似然為 (1−s) 的相應冪次。真實世界中,使用者可能因為修正角度而提高下一次的成功率;本文不假設這種技能學習已不存在,而是特意把它排除以得到清晰基線。若日後量測顯示學習效應顯著,應在模型內增加熟練度或對準狀態,而非把本研究的常數 s 當成萬能參數。
信念 b=P(H=0|歷史) 把過往方向及成敗資訊濃縮成當前對 H 的機率判斷。由於最後一個插入朝向會影響下一次翻轉的操作成本,單有 b 還不足以表達完整成本狀態;模型另外保存上一朝向 l∈{無、0、1}。剩餘嘗試額度 t=0,…,T,以及觀察選項是否尚可使用 o∈{可、不可},共同構成決策狀態 (t,b,l,o)。真實 H 不能被演算法直接使用,只有模擬器在生成合成結果時知道它。這保證計算的「最優策略」沒有偷看隱藏答案。
成本以人工單位定義,每次插入付出 1;當上一朝向存在且新朝向與之相反時,額外付出 c_f;每次啟用唯一的視覺提示付出 c_o;未能插入就停止付出 L。全部成本非負,成功的額外完成獎勵設為零,因此值函數只需最小化期望損失。這個標準化目的避免額外引入金錢與秒數之間的任意換算,但也表示最優政策不能被直接解讀為最短實際耗時。例如如果人能迅速翻手卻需要很長時間辨認端口,實際 c_f 和 c_o 的相對大小可能與本文示例完全相反。
視覺提示 Y∈{0,1} 的準確率定義為 P(Y=H|H)=q,且對兩個 H 都相同。這是對稱的二元噪聲通道;q=0.5 時不比硬幣提供更多方向資訊,q=1 時成為完美方向指示。為了防止隱藏的因果矛盾,我們指定視覺提示只是觀察既有 H,不會直接改變插孔或手的對準成功概率;因此拿到提示後仍須面對 s<1 的對準失敗。這個假設使「看清楚方向」與「把插頭推準」保持為兩個可分辨的問題,也指出一條重要限制:現實中的觀察可能同時幫助修正手部角度,若然如此,觀察便會改變後續 s,超出本文的簡單信號模型。
數學上這是一個有限期 POMDP,隱藏 H 只有兩種值、轉移是保持 H 不變、觀察為成功失敗與一次性的外部提示、行動則具有即時成本和終止規則。因為信念是充分統計量,最優決策可以用 Bellman 遞迴計算。相比直接以「永遠把插頭翻一次」或「永遠在同方向多試幾次」作原則,這個框架提供了統一標尺:不同策略都在相同的概率空間、嘗試上限和損失函數中接受評價,而不是在不同故事設定下各自宣稱有效。
5. 研究方法、參數設定與驗證策略
研究首先直接用條件概率推導兩種方向的成功率與失敗後驗,再由全概率定律求視覺提示的後驗,建立 Bellman 最小化方程。接著在連續的信念區間上用有限層數遞迴求值,分析不同參數與歷史狀態下的最佳下一步。由於最多只有六次嘗試和一個二元提示,沿着任何具體決策樹的分枝有限;程式不需要使用近似強化學習,也沒有需要訓練的神經網絡。信念在快取鍵中保留十二位小數,並額外以不使用相同快取的短期枚舉檢查其數值影響在檢測容許範圍內。
合成基準參數刻意設定為 T=6、初始 b_0=0.56、正向插入成功率 s=0.70、翻轉價格 c_f=0.32、一次提示成本 c_o=0.40、提示準確率 q=0.90,以及停止損失 L=7。這些數值既不是 USB 官方規範,也沒有來源於真實操作影片或人類問卷;它們只作為能展示可靠度、資訊與轉向代價三者競合的自訂情境。讓先驗稍高於二分之一,可以排除每步完全對稱時的任意平手;讓方向正確仍有 30% 對準失敗率,則可以讓後驗變化與逆轉路徑有足夠的計算空間。
評價策略包括五類:可選擇一次觀察的貝氏最優策略;每次失敗就轉到相反方向的機械交替策略;開始選 0 後無論失敗多少次都堅持方向 0 的固定策略;每次僅比較當前兩個方向後驗概率的貪心策略;以及先強制觀察一次、其後只依較高的後驗朝向行動的策略。這些策略不是心理測量所得的人類典型模式,而是研究者提出的演算法基線。機械交替與貪心恰好可能在某些對稱參數下產生同一條路徑,本文會如實報告二者數值相同,而不為增加漂亮的差異而改變定義。
對每個策略,使用精確的二元分枝枚舉計算六項指標:期望總成本、期望嘗試數、期望翻轉數、期望提示數、預算用盡或主動放棄的概率,以及最終成功概率。這裏的「期望」直接相對於設定的先驗與條件成功率,不帶任何估計誤差;與之比較的蒙地卡羅平均才會因偽隨機抽樣而存在標準誤。每個策略另以 35,000 個獨立合成回合、明示整數種子生成 H、提示誤差及對準成功事件。模擬器只讓策略看見觀察結果,隱藏真實 H,故可以檢驗值函數與模擬機制是否對應。
除基準策略外,研究會在 s=0.40 至 0.95 的人工範圍掃描對準成功率,顯示當嘗試可靠度不同時交替與堅持的成本如何分歧;另在四種提示準確率 q∈{0.55,0.70,0.85,0.95} 下掃描提示價格 0 至 1.25,衡量允許觀察所節省的最優期望損失。最後對不同先驗繪製一次方向 0 失敗後、兩種方向各失敗一次後的信念,直接可視化貝氏似然的抵銷現象。五張圖都具有明確數學對象及與正文對應的推論,不使用僅作裝飾的圖片。
驗證採取三種彼此不同的方式。第一,以代數檢查後驗範圍、互補成功概率與觀察概率歸一化,證明失敗似然的連乘恆等式。第二,以沒有快取的遞迴窮舉,對短期 t≤3、若干先驗及上一朝向,和原始 Bellman 求解器比較至 10 的負九次方。第三,用另一套按真實隱藏狀態生成結果的隨機模擬程序,要求模擬均值與精確成本差距可由五倍標準誤加小幅數值容差解釋。短期驗證不能形式上證明六期程式絕無 bug,但多條路徑能共同限制明顯的後驗錯誤、成本重複計算或隱藏狀態洩漏。
6. 數學模型:失敗訊號的似然比與 Bellman 方程
6.1 成功概率和失敗後驗
設在信念 b 下選擇朝向 a∈{0,1}。當 a=0,兩種真實狀態中只有 H=0 可能成功,所以成功概率為 bs;當 a=1,成功概率為 (1−b)s。若選 0 而失敗,H=0 的聯合概率是 b(1−s),H=1 的聯合概率是 1−b,兩者和為 1−bs。由貝氏公式,失敗後的新信念為 b(1−s)/(1−bs)。同理選 1 失敗,H=0 的似然是一,H=1 的似然是 1−s,故新信念為 b/[1−(1−b)s]。這些式子中的分母都是失敗的總機率,若把它們省略,就會得出無法歸一化的假後驗。
對所有 0<b<1 及 0<s<1,選方向 0 失敗會使 b_{0F}b。這符合方向判斷的直覺,但改變的大小取決於 s。當 s 接近零,正確朝向幾乎也會失敗,故一次失敗攜帶的方向資訊很少;當 s 接近一,方向正確卻失敗的機率極低,一次失敗便強烈支持相反方向。因而對「操作失敗」的詮釋不能脫離機械可靠度:同樣一個失敗訊號,在很可靠的插頭與很難對準的插頭上,理應引出不同程度的信念改變。
6.2 似然比、互相抵銷及三次朝向選擇
使用對數勝算可以將連續失敗轉換成簡單的加法。初始方向 0 相對方向 1 的勝算是 O_0=b_0/(1−b_0);方向 0 失敗的似然比為 1−s,方向 1 失敗的似然比則為 1/(1−s)。如果到目前為止分別在方向 0 失敗 n_0 次、在方向 1 失敗 n_1 次,且每次正向成功概率都是同一個 s,根據條件獨立假設,最新勝算便是 O_0(1−s)^{n_0−n_1}。已成功的回合早已終止,不參與這個失敗歷史的計數。
當 n_0=n_1,勝算回到 O_0,所以 b_{n_0,n_1}=b_0。這個結果對任意順序都成立,只要兩種方向分別失敗的次數相同。它解釋了為何嘗試 0 失敗、改試 1 也失敗,並不意味「兩種方向都錯了」;正確解讀是兩個方向各自承受過一次可能由對準造成的失敗,若其噪聲機制相同,證據恰好相抵。更一般地,在先驗 b_0=0.56、s=0.70 的合成例子,方向 0 失敗後 b=0.276316,方向 1 再失敗後 b=0.560000;若轉向成本為 0.04 且視覺提示被禁止,在尚有足夠預算時的最優朝向選擇路徑正是 0→1→0。這是條件在前兩次都失敗的決策路徑,並非每次執行都必經三步。
6.3 觀察提示作為一次性的資訊行動
若尚可使用視覺提示,觀察 Y=0 的機率為 bq+(1−b)(1−q),觀察 Y=1 的機率為 b(1−q)+(1−b)q。接到 Y=0 後,H=0 的後驗是 bq/[bq+(1−b)(1−q)];接到 Y=1 後,後驗是 b(1−q)/[b(1−q)+(1−b)q]。觀察本身不代表成功插入,因此它的價值完全來自改變後續朝向選擇及其成本。q=0.5 時兩種訊號的後驗均等於 b;即使該提示免費,沒有資訊價值的訊號也不能改善最佳期望成本,只可能被策略忽略。
6.4 有限期最小成本遞迴
令 V_t(b,l,o) 為尚餘 t 次插入額度、信念 b、上一朝向 l、觀察資格 o 下能得到的最小期望總損失。當 t=0,未能完成任務時的值固定為 L。若尚可繼續,候選值包含立即停止的 L、朝向 0 或 1 插入的成本、以及若 o 為真就可選擇支付 c_o 取得提示的成本。一次插入立即付出 1 及必要的翻轉價格;若成功,未來成本零;若失敗,就以相應後驗及 t−1 進入下一狀態。觀察提示不消耗 t,但使用後 o 變為假,並以全概率加權其兩個可能後驗。
最後一式的 Q_obs 僅在觀察資格為真時列入;若觀察已用或根本不提供提示,便只比較其餘三類動作。指示函數 I(l≠a,l≠−1) 把初次將插頭拿在手上所選方向排除在翻轉成本之外,防止把首次朝向指定當作從不存在的上一朝向翻轉。因為觀察最多一次,選擇觀察雖保留 t,卻令資格由真轉假,遞迴圖仍然沒有環;因為每次插入使 t 減一,有限步數下可精確求解。這個有限性是本研究能以小型演算法給出可審計結果的關鍵。
用 Bellman 值函數比較動作時,不能只比較本次成功概率 bs 與 (1−b)s,還必須加入後續的資訊價值。例如同一方向再失敗一次會讓人更不相信它是正確方向;但如果翻轉很昂貴,保留當前朝向多試一次可能仍有合理的成本收益。另方面,若 t 快用完且 L 很高,對方向資訊略低的動作仍可能因不同的未來分枝而優於短視行動。將未知方向、嘗試剩餘量與操作成本一併考慮,才可以區分「這面機率較大」和「這步做下去最划算」。
7. 研究結果:策略比較、三步路徑與資訊效益
7.1 基準的有限期最優策略
在六次額度、先驗 0.56、對準成功率 0.70、翻轉價格 0.32、可用提示準確率 0.90 且成本 0.40 的合成基準中,動態規劃給出的初始最優動作是先作一次視覺觀察。其精確期望總成本為 2.327362,精確期望插入次數為 1.762900,期望翻轉次數為 0.157600,期望提示次數為 1.000000。最終未能成功而支付停止損失的機率為 0.016290,成功機率為 0.983710。這些數字可由程式以二元分枝完全列舉重現,不是估計某一群人的成功率,也不是產品實際可靠度指標。小數位表示的是理論計算在指定人工參數下的精度,而非外界可測量的準確度。
為讓「最優」具有可以比較的意義,我們把基準放在同樣六次額度和相同終止損失的四種規則旁邊。強制交替方向的期望成本為 2.819358,期望插入 2.235120 次、翻轉 1.235120 次,且未完成的概率為 0.027000。只選方向 0 的頑固策略的期望成本為 6.522274、未完成概率達 0.440408;這不是說現實中「不翻插頭」會有如此高的失敗率,而是因為在人工模型裏,若 H 恰好等於 1,堅持方向 0 再多次也不可能插入成功。它是刻意設計的差基線,可以檢查模型對方向不確定性是否敏感。
只依當前方向後驗較大者行動的貪心策略,其基準期望成本亦為 2.819358,恰好和機械交替相同。這一相等源自選定先驗與可靠度、成本下兩種規則走出相同的嘗試序列,並不意味貪心政策在所有參數或有限期下都等於最優政策。強制先看方向、再由貪心規則嘗試的策略,期望成本為 2.354873,已非常接近容許後續調整的最優策略,但仍高約 0.027511 單位。這一小差距來自觀察以後的決策仍可考慮翻轉價格與失敗後的繼續成本;只知自己該先往哪一面插,並不保證往後每一次行動都應追逐後驗較大的一面。
以上五種策略的精確成本必須和各自的任務完成率一起看。只比較在成功回合內平均用了幾次,會錯誤地排除最難的失敗情況,令可能放棄大量任務的策略看起來特別有效。因此本文的目標函數對未完成事件固定支付 L=7,並同時報告未完成概率。尤其對於頑固策略,不能把沒成功的回合當作資料缺失,然後宣稱它是省時的方向選擇方法。完整分枝列舉本身就包含那些最難完成的歷史,使不同策略的成本尺度可比。
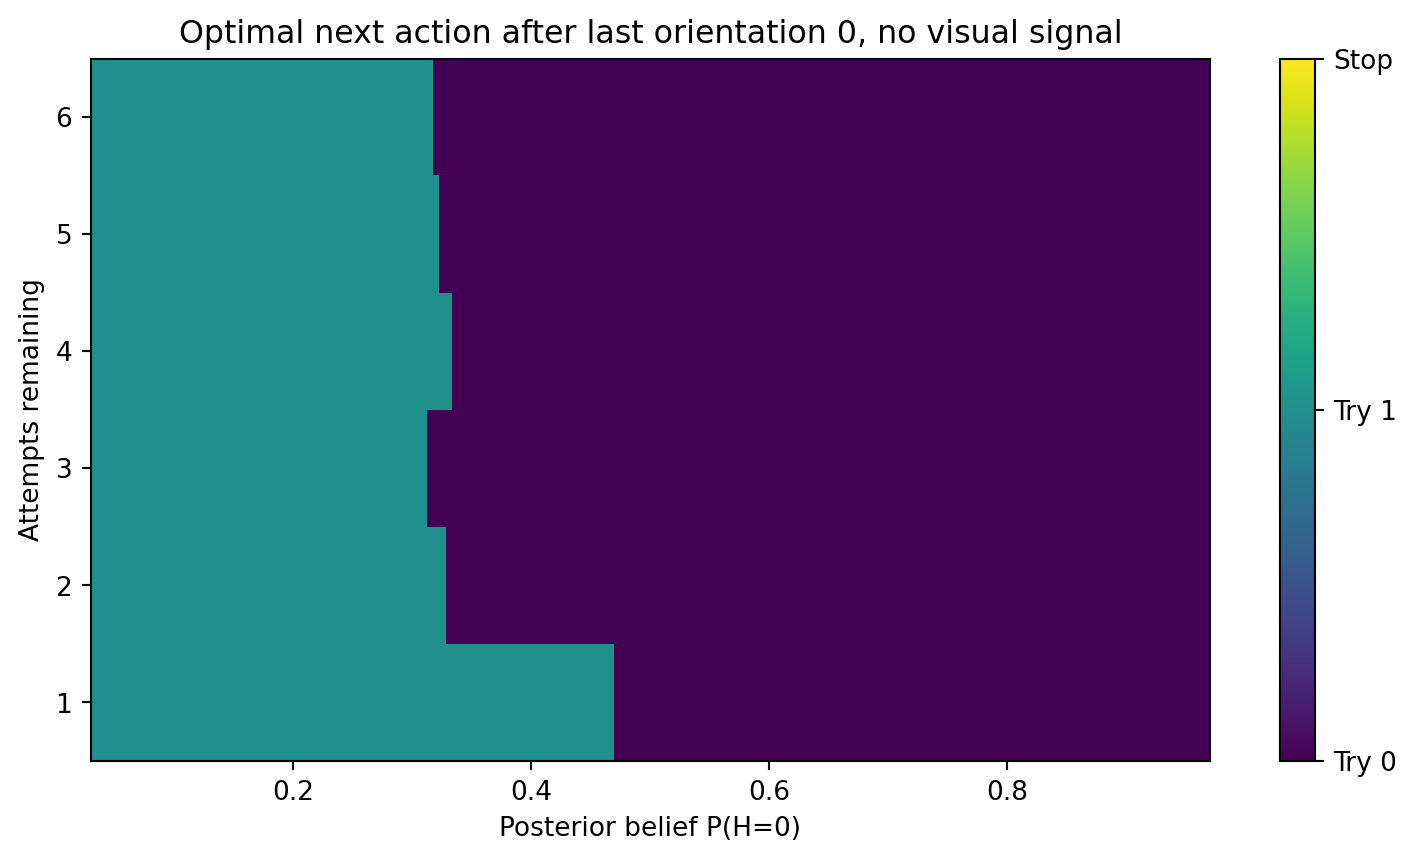
圖 1. 在上一插入朝向為 0、已經沒有視覺提示可用時,依信念及剩餘額度繪製下一步最優朝向或停止區域;使用本研究人工參數及精確 Bellman 計算。不同色塊是決策邊界,不是實地插入成功的樣本散點。數據/圖像來源:本研究 analysis.py。
圖一的橫軸是對 H=0 的後驗信念、縱軸是仍可嘗試的次數。考慮上一朝向尤為重要:在相同 b 下,如果上一朝向是 1,改成 0 必須另付翻轉價格;因此畫出來的政策邊界可能與圖一不同。圖上部分區域可能寧願維持上一方向,即使另一面在瞬間成功率上稍佔優勢,這是因為轉向本身有成本。即使決策圖只顯示有限的離散行動色塊,它背後的值函數對信念仍是連續分枝上的加權期望。圖像證明的是決策對成本敏感,而不是暗示真實人類會精確計算這些邊界。
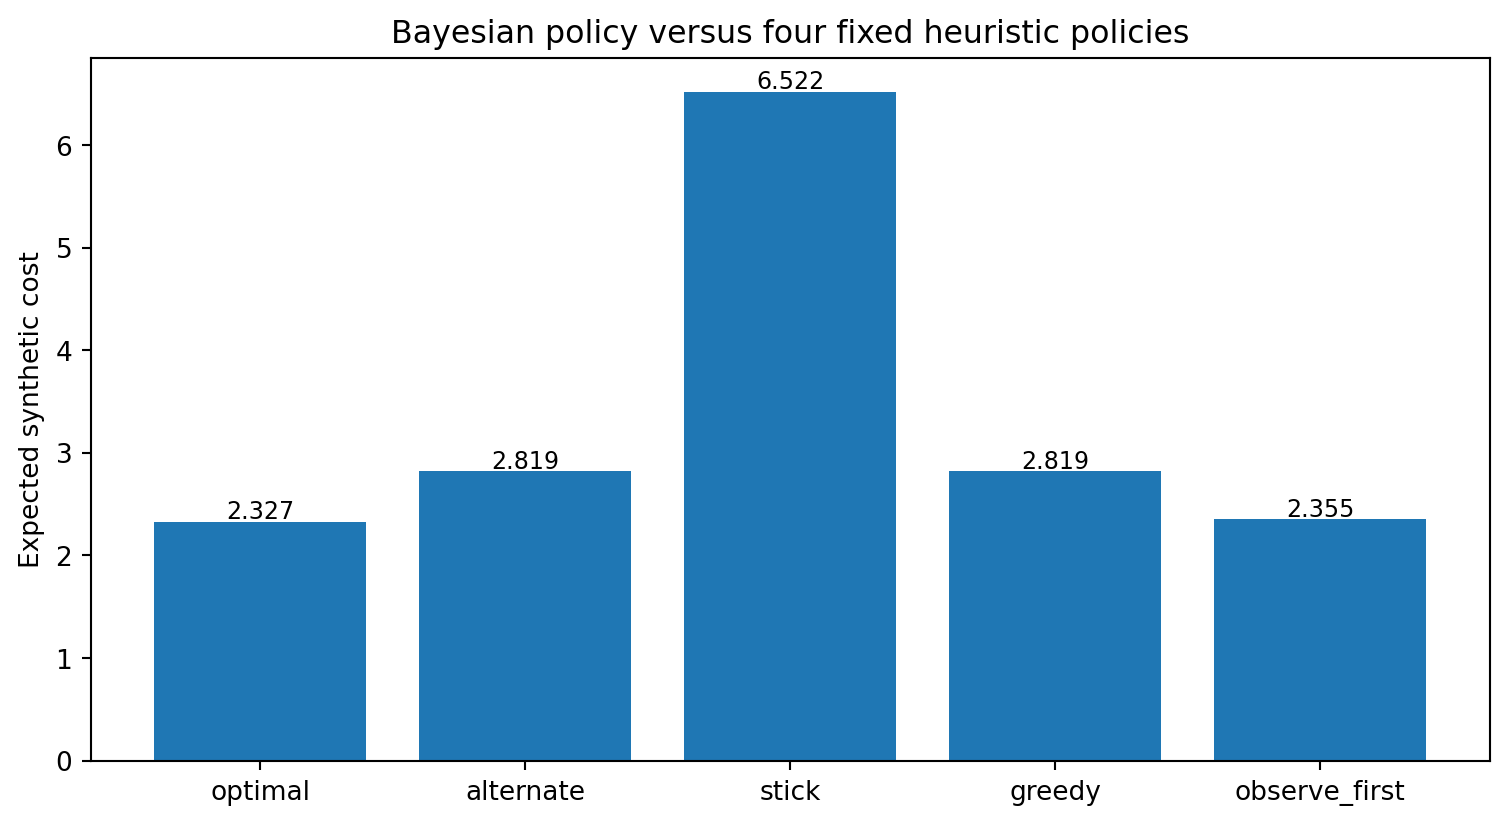
圖 2. 貝氏最優、強制交替、固定朝向、後驗貪心,以及先觀察後貪心五種算法的成本比較。所有策略共享相同模型、停止代價與最多六次嘗試。高度由完全列舉算出,屬理論值而非問卷均值。資料來源:本研究合成模型。
圖二中最佳策略與強制交替策略相差 0.491996 單位,按強制交替成本作分母,約是 17.45% 的減幅。但這個比例必須附帶兩項條件:其一,視覺線索的辨識力確如本研究所假設的 q=0.90;其二,把翻轉的主觀代價定為 0.32,而觀察定為 0.40。若有人操作時根本看不到端口,或方向標誌幾乎無法辨認,這個改善不一定存在。將圖二數字直接寫成「新設計令使用者效率提升百分之十七」會把電腦合成研究偽裝成產品實驗,是本文刻意避免的過度推論。
7.2 為何「0→1→0」不是自我矛盾?
為孤立研究插頭三步笑話本身,我們在第二個反事實情境把視覺提示排除,並把翻轉價格降低至 0.04,其餘採用 b_0=0.56、s=0.70、六次初始額度及同一停止損失。第一次最優選擇為方向 0;如果觀察到失敗,新的後驗 b=0.276316,下一步最優是方向 1;假如第二次又失敗,後驗恰好回到 b=0.560000,於仍有四次額度時的最優朝向再次是方向 0。這個路徑是實際從 analysis.py 的 Bellman 求解器抽出並以斷言固定的結果,並非作者看着公式後自行指定故事情節。
第三次回到 0 不是人突然忘記剛才試過這面,而是前兩次方向不同的失敗把似然比拉回原點。假如事先稍微偏好 0,歷史資訊取消後仍然會稍微偏好 0;在低翻轉價格條件下,回到 0 的即時預期優勢足以抵銷翻轉成本。這個結果說明「我已試過這邊,所以它必定錯」是一種忽略動作不可靠度的推論。它也不代表每次都應來回翻:若先驗是恰好 0.5,兩面各失敗一次後後驗仍是 0.5,正的翻轉價格可能讓保持第二個方向更便宜;若翻轉價格提高,甚至第一次失敗後都未必應立即改變朝向。
從概率上看,一條條件最優路徑不等於該路徑的事件發生機率等於一。第一次嘗試 0 可能已成功並終止;只有失敗才會進入第二步。第二次在方向 1 同樣可能成功;只有兩次都失敗才會看見第三次回到 0。因此要估計「有多少真實人會翻回去」,仍須知道先驗分布、插入可靠度、成本偏好及行為決策規則,再對人或產品作出實際量測。本文證明的只是存在可明確列出的參數情境,使這條看似荒謬的路徑合乎所指定的理性決策標準。
7.3 蒙地卡羅與數學結果交叉核對
除理論值外,合成模擬對每個策略各生成 35,000 個回合,最優策略使用種子 2026101800,交替、固定、貪心及先觀察策略依序使用 2026101801 至 2026101804。每一回合首先依 b_0 抽出一個隱藏正確朝向 H,再根據當時的真實 H、對準概率及觀察器準確率產生結果。決策器只看得到成功失敗或有噪聲的視覺提示,永遠不能直接查看 H。這和單純用理論概率直接生成人工成本的模擬不同,可以檢查後驗推斷是否真的對應模擬器的觀察機制。
最優策略模擬平均成本為 2.343905,理論為 2.327362,差額約 0.016543;模擬標準誤約 0.010690。強制交替模擬平均為 2.843219,理論 2.819358,差額約 0.023861,模擬標準誤約 0.013932。其他三種策略的差額分別約為負 0.000103、負 0.003547 與正 0.009658,均在預先設定的五倍標準誤加微量容差之內。這個檢查表明模擬在有限抽樣噪聲下與公式沒有可見的嚴重衝突;它不構成「模型符合真實 USB 操作」的統計證據,亦不產生可以推及人群的信賴區間。
模型還以獨立、不帶快取的窮舉遞迴在 t=1、2、3 的多種信念、上一朝向及觀察資格下檢查值函數。測試結果在 10 的負九次方內一致,並且對幾個先驗確認連續一次方向 0 失敗、一次方向 1 失敗後重新得到原來的先驗。所有策略的成功和停止概率相加至一,故沒有遺漏一條不成功且已用盡預算的路徑。這一類程序化檢查是數學可重現研究的必要工作;但它只能在指定程式與算式的範圍內支撐可靠性,無法排除理論假設本身選錯或量測世界與模型不同。
8. 參數敏感度:何時值得再試、翻轉或先觀察?
8.1 對準成功率的作用
把方向正確時的插入成功概率 s 從 0.40 漸次增加至 0.95,並保持其餘成本不變,便能看到資訊強度和行動效率同時改變。當 s 較小,正確朝向也經常失敗,一次失敗的 Bayes 因子 1−s 較接近一,對方向辨識的證據弱;就算反覆翻轉,也容易因對準因素繼續遇到失敗。當 s 較大,一次正確朝向的嘗試較可能迅速完成,且不成功時會更明顯降低該朝向的後驗,從而使選擇方向有更高資訊價值。這兩種效應同時存在,所以沒有理由預先假設所有策略成本必然按相同比例下降。
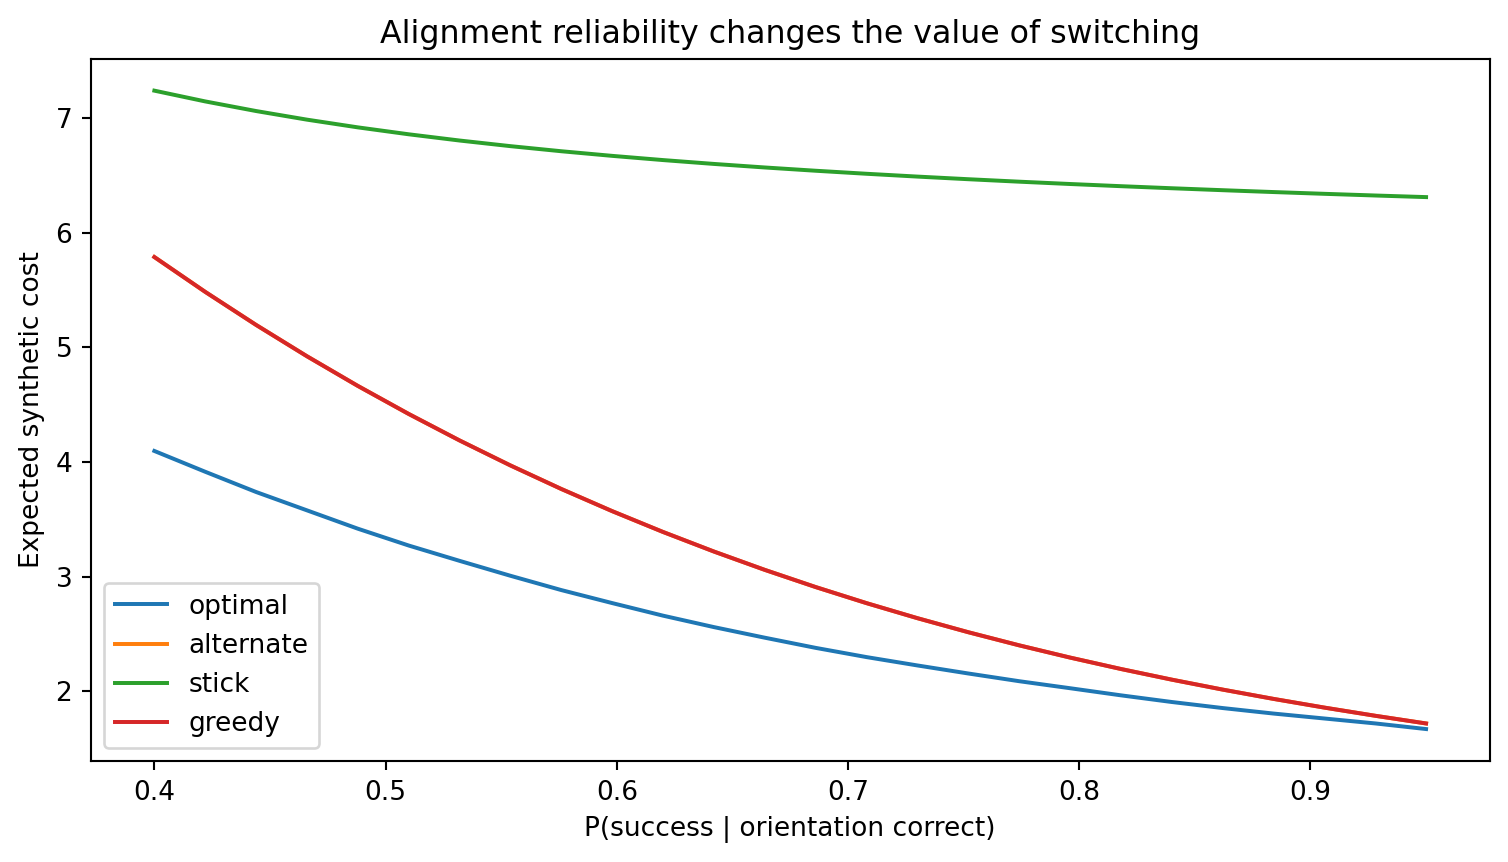
圖 3. 在固定其他假設參數下掃描 s,對最優、交替、固定和貪心策略重算精確期望成本。曲線為假設參數敏感度,不代表不同 USB 品牌的性能量測。來源:analysis.py 的完全列舉計算。
圖三展示了一個操作直覺的邊界:改善對準技巧可以降低所有合理策略的失敗機會,但其對成本的總效果仍取決於是否進行多餘翻轉、能否善用觀察及停止損失。固定方向策略的成本可能在某些先驗下仍偏高,因為若真實 H 恰好在另一面,即使把 s 提到接近一也不能解決方向錯誤。這和「對準不良」是兩個獨立的失敗原因;機械技術的改進只改善前者,不應被誤認為已自動消除方向不確定性。
8.2 一次性線索的資訊價值與成本門檻
把有提示可用時的最優成本記為 V_with,禁止提示時的最優成本記為 V_without。因為第一種策略集合包含第二種策略集合,決策者完全可以選擇不看,必有 V_with≤V_without。因此非負的資訊選擇權價值定義為 V_without−V_with。這是一條不用模擬也能證明的比較不等式;數值分析只是展示它如何依 q 和 c_o 改變。要特別分辨「允許看」與「強制看」:前者不能令最佳成本惡化,後者在提示昂貴時卻可能真的比不看更差。
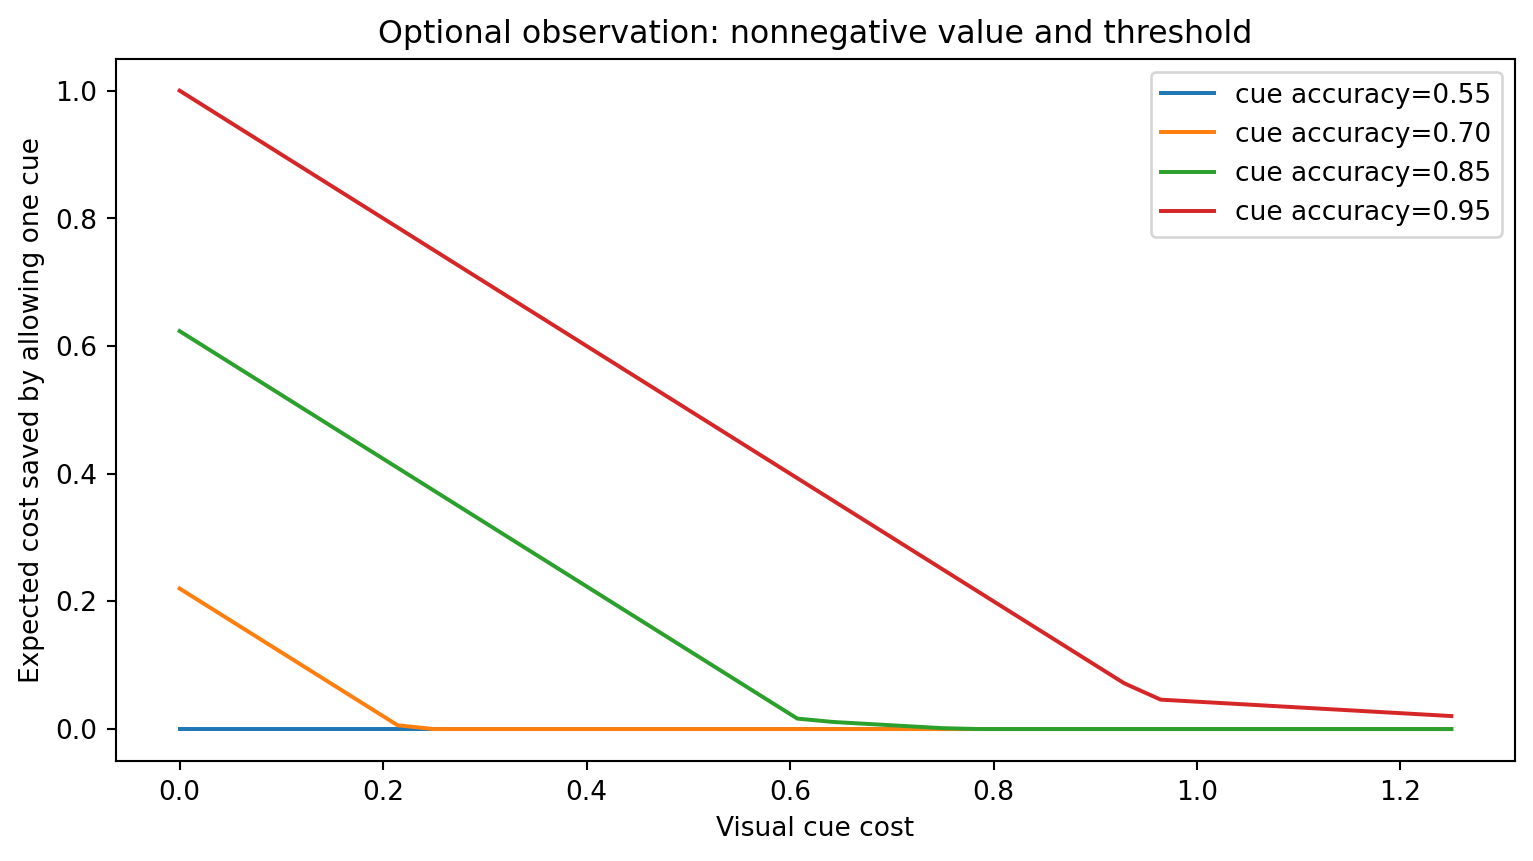
圖 4. 四種提示正確率下,容許一次觀察所減少的最優期望總成本。各條線計算的是同一模型「容許」減「禁止」的成本差,非強制觀察的實驗效果。當提示代價過高時曲線貼近零,代表最優策略直接忽略提示。來源:本研究合成計算。
圖四顯示,當訊號 q 較準、辨認成本較低時,使用提示可能省下較多後續反覆操作的成本;而當辨認成本越來越高,最佳策略總可以退回不觀察,故資訊價值不會變成負數。這種零值區域不是資訊在物理上完全消失,而是在既定價格下不值得購買。若換成必須觀察一次的策略,則多付的成本無法隨意撤銷,故曲線邏輯不同。在工程設計上,可辨識的物理標記只有在使用者能以足夠低成本理解時才有可能帶來價值;標記本身存在不等於實際有用。
8.3 先驗、失敗次數及信念的返回
若把初始先驗 b_0 視為連續變量,第一次在方向 0 失敗後的曲線位於起始 b_0 之下,因為證據支持方向 1;隨後若在方向 1 亦失敗,曲線返回對角線 b=b_0。圖五把這項代數恆等式畫出,讓「回到原來想法」與「沒有思考」的區別在圖像上變得清楚。後者是未處理觀察,前者則是先被一項證據拉走,再被同樣反向強度的另一項證據拉回。即使最終數值相同,信念更新的歷史意義仍然不同。
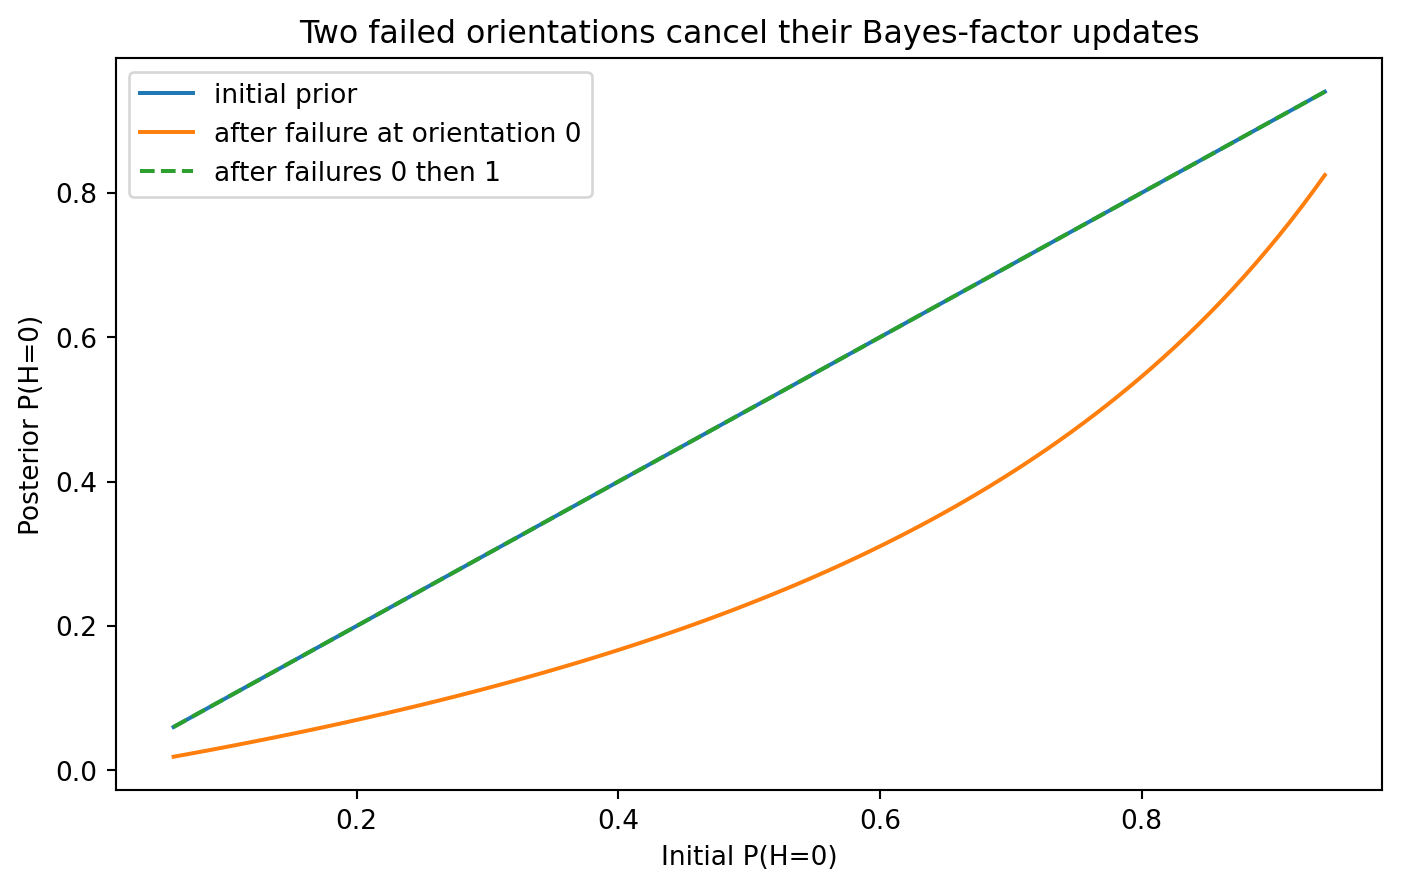
圖 5. 初始先驗、方向 0 失敗後的後驗,以及接續方向 1 失敗後的後驗三條理論關係。兩次失敗曲線與對角線重合,因兩個 Bayes 因子相互抵銷;並非來自真實使用者的心理量表。來源:本研究解析推導及數值繪圖。
若每次正向成功率會因練習而提高,該抵銷關係就不一定成立。假設方向 0 第一次的正向成功率為 s_0,而方向 1 第二次的正向成功率為 s_1,則兩次失敗後的勝算因子是 (1−s_0)/(1−s_1);只有當兩者相等才恢復原來先驗。反過來說,真實過程即使確實呈現 0→1→0 的方向選擇,也不足以證明模型所假設的兩種方向具有相同可靠度。不同心理與機械機制可以生成相似外表行為,這就是不能僅憑笑話或單條操作影片倒推出可靠度參數的原因。
9. 討論:小小一個插頭的決策科學
把 USB 插入問題形式化,首先揭示一種常見的語義陷阱:行動失敗是對整項動作組合的觀察,而非對某一個單獨原因的直接測量。如果成功需要同時滿足「方向正確」與「對準成功」,失敗可能由任一條件造成;除非已知第二條件必然成立,否則失敗不能排除第一條件。這種推理結構可類比於登入失敗不一定是密碼錯誤、門禁刷卡失敗不一定是權限不足、或實驗儀器未讀到訊號不一定是樣本不存在。類比只能說明邏輯形式,不能把本文參數直接搬到那些領域。每個情境的觀察噪聲與損失結構,都需要獨立界定。
第二個教訓是,理性選擇未必是一條沒有重複的序列。若每次行動後世界狀態固定、觀察又有噪聲,重新執行以前失敗的動作可以在新的後驗下再次成為最佳。這不是認知的必然缺陷,而是序貫資訊更新使同一動作的機會成本隨時間改變。當然,在失敗完全可診斷的情境,即 s=1,重複同一方向就沒有理性的必要;因此是否值得重試,最重要的前提是辨明失敗是否具有足夠噪聲。研究者不能不加檢驗便把所有現實重試都歸為「貝氏理性」,也不能把所有重複都歸為「記性差」。
第三個教訓涉及資訊的設計價值。若插頭朝向有清楚的觸覺、色彩或幾何提示,使用者可能在第一步取得更集中、較準確的方向先驗,從而減少錯誤方向的嘗試。然而觀察成本並非一個抽象常數就能完全總結;它可來自需要低頭查看、端口位於機箱背面、照明不足、標記不明顯、或某些人的視覺與動作條件不同。模型把這些異質性壓縮為 c_o 與 q,是讓設計問題可被計算,而非已經證明所有使用者共享同一組成本。若要進行真正的人因研究,應讓參數在個體間變化,並以預先設計的可及性條件比較策略。
策略比較亦提醒我們,不同績效指標可以給出不同排序。某個策略可能用較少的期望插入次數,卻因經常反覆翻轉而成本較高;另一個策略可能很快停止,表面上嘗試數很少,卻把大量未完成損失轉移到其他時間。本文透過統一 L、c_f、c_o 及每次插入成本,避免只根據一項有利的平均值宣布勝利。但此損失函數仍是研究者自訂的:若實務使用者更在意插孔磨損、手指疼痛、公共電腦使用時間或意外損壞,便應加入與那些風險對應的成本。最優性的正確解釋始終是「相對於所寫的目標函數」而言,而不是在所有可能目標下的絕對最好。
模型的一項有趣結果是,基準中的最優策略與強制交替策略在成本上存在明顯差距,但這並不表示所有差距都源於使用者「會不會算貝氏公式」。強制交替策略在每次失敗後都改方向,忽略了翻轉成本、視覺線索及有限額度的情境;最優策略則利用所有這些允許資訊。真正的人類未必追求相同的成本最小化,也可能有其他方便因素,例如握持動作、端口遮擋或經驗學到的快速檢查方法。與其把模型當成對人的貶抑,不如把它作為研究平台:改變可觀察性、動作可靠度和代價後,哪些策略差距仍保留?這些才是值得進一步實測的可否證預測。
與學術文獻的關係亦需要精準理解。Smallwood 與 Sondik(1973)及 Kaelbling 等人(1998)支持部分可觀察決策的理論框架,Ross 等人(2008)則提供對線上規劃方式的相關學術背景;它們並未研究本篇人工 USB 世界的特殊參數。Tversky 與 Kahneman(1974)、Langer(1975)和 Hick(1952)可用來提出對不確定判斷、控制感與資訊處理的問題,但不是我們的實證資料來源。把這六種來源放在同一研究中,目的只是讓形式模型與真實學術問題接軌,絕非聲稱已有文獻以六次插頭實驗驗證本研究的各個小數結果。
10. 限制、可識別性與可能反例
研究最顯著的限制是沒有真實插入資料。先驗 b_0、對準成功率 s、觀察準確率 q、翻轉成本 c_f、觀察成本 c_o、停止損失 L 及六次額度,全部由作者為了展示模型機制而指定,沒有對應任何品牌、產品批次或人群估計。即使合成程式跑上一百萬次,得到極小的蒙地卡羅標準誤,亦只能更精確地描述同一套人工規則,不能因此提升實際 USB-A 插入操作的外部效度。因此本文不報告人類受試者樣本量、社會調查顯著性或所謂產品優化的統計證據。
第二,正向成功率被假設為不隨時間改變,也不依賴連續失敗而改變。實務上對準會隨手腕位置、目標端口角度、插頭與插孔磨耗、光線或使用者逐步修正動作而變動;若首次失敗是因傾斜,第二次即使不翻轉也可能因調整角度而較易成功。本文把所有這些機制合併為每次獨立、同機率的 Bernoulli 對準事件,是一種可計算的基準,而非正確的物理機制完整描述。增加一個連續角度偏差或潛在熟練度狀態會改變後驗公式,也可能推翻某些政策邊界。
第三,錯誤方向的成功率被設為零,與研究對象的方向限制一致,但實際插入「失敗」可能有多種判準。若插頭只是稍微進入端口便被阻擋,使用者可以感覺出與真正對準失敗不同的阻力;這意味着觀察訊號可能具有不止兩個類別,且不同失敗類別對 H 的似然不相同。若使用者能用手指觸覺取得額外資訊,就不應把它簡單合併為本文的單一成功/失敗二元訊號。另一方面,如果外部硬件本身出現故障,兩個方向都可能永遠失敗,隱藏狀態亦應增加「接口損壞」或「插入被障礙物阻擋」等可能性。
第四,方向辨識提示被定為準確率對稱、最多一次、觀察不改變 s。現實中某些插頭的標誌只在一面可見,辨識誤差具有方向不對稱性;反覆觀看或調整燈光也可能逐次提高準確率。若 q 由觀察者熟練度和物件狀態共同決定,簡單的二元獨立提示模型就需要改寫。高準確度提示有可能同時提示端口深度或角度,令往後的對準成功概率提高,這將改變圖四的資訊價值曲線。對於部分使用者,觸覺辨識比視覺更適合,未來研究不應先把某一通道視為唯一合理的觀察方式。
第五,值函數的有限期和固定停止代價與實際使用者的容忍度未必一致。當人必須緊急讀取資料、正在公共場所排隊,或插頭屬於容易損壞的珍貴設備,失敗代價可能遠高於七個人工單位;當任務完全不重要,放棄成本可能接近零。更複雜的目標可能包含時間折現、風險厭惡或對非常多次重複失敗施加非線性心理成本。若不估計這些成本,就無法保證模型排序與真實選擇排序一致。本文刻意只作期望成本最小化,避免把未測量的心理效用寫成無端精確的定理。
第六,觀察到同一條 0→1→0 操作序列,未必能唯一識別隱藏參數。高失敗率、低翻轉成本與不精確提示可以產生這條路徑;但手部肌肉記憶、短暫分心、插頭轉到另一個角度時沒有完全旋轉、接觸面的幾何阻滯等其他機制也可能生成相同外觀。行為序列並非潛在認知過程的透明窗口。若要在觀測資料中區分這些假說,可能需要同步記錄插頭朝向、端口幾何、插入力、時序、是否觀看標記,以及每次失敗的具體種類,而不能只用「最後成功在第幾次」這一項結果推定決策規則。
在文獻方面,六篇正式參考來源的出版資訊已有 Crossref 本次查詢或本研究資料庫既有的期刊書目核對,但未取得全部論文的完整開放文本逐頁複核。本文因此只引用可從書目與公認研究範圍支持的一般理論背景,避免把具體實驗效果、數字或未讀到的結論強加給原作者。這是一項重要的方法限制:可追溯引用確保我們沒有憑空捏造 DOI,卻不能取代對全文論證與研究外推邊界的仔細閱讀。任何正式投稿或實際產品決策都需要進一步文獻審閱與實證工作。
11. 結論與未來研究方向
USB-A 插頭被戲稱為必須反覆翻轉,真正值得研究的不是插頭究竟有幾個物理面,而是「方向不確定」和「即使方向正確仍可能操作失敗」如何結合。本文證明,單次插入失敗應作為似然訊號更新方向信念,而不能自動當成方向錯誤的完全證明。在兩個方向具有相同對準成功率及條件獨立失敗的前提下,分別在兩種方向失敗相同次數,會使似然比回到初始狀態。當先驗稍偏向第一面、翻轉代價較低、仍有足夠嘗試預算時,方向 0→1→0 可以形成一條有數學根據的條件最優序列。它是三次方向選擇及兩次翻轉,不是已證明所有使用者平均翻了三次。
將視覺辨識及翻轉代價加入模型後,有限期 Bellman 計算亦展示先花成本取得資訊可能減少總體操作負擔。在所選擇的純假設基準中,最優期望成本 2.327362 低於交替策略的 2.819358;不過這種改善完全依賴人工設定的提示可靠度、動作成功概率及成本權重。五張圖與 35,000 次每策略的合成模擬只是用來追蹤此結論的數學邊界及程式一致性,不提供任何工廠品質或人類認知的實地因果證據。研究能夠明確聲稱的是:存在一個可驗證的理論機制,讓看似無厘頭的返回動作在帶噪聲的決策系統中變得合理;不能聲稱的則是現實笑話已由一次模擬獲得經驗證實。
未來工作應先透過有重複次數、明確安全流程和受試者同意的插入實驗,分別記錄方向選擇、接觸失敗型態、成功時間、翻轉時間及是否使用辨識提示。可以隨機安排遮蔽或開放可用的方向線索,並以不同插頭種類及不同插孔位置重複測試,估計觀察是否實際減少重試;若研究對象包含可反轉插入的 USB-C,則需要完全不同的物理狀態和錯誤模型,而不是把本文 USB-A 的方向限制直接套用。也可以在階層貝氏模型中容許不同使用者擁有不同先驗與技能,並以留出資料評估預測表現,不把對既有紀錄的擬合成功當作對新個體的保證。
在理論方面,擴展方向包括讓對準成功率隨失敗後的自我修正而提高、加入觸覺訊號與物理傾斜連續狀態、容許端口損傷風險隨嘗試次數增加,以及比較風險敏感效用與平均成本政策。模型亦可將資訊觀察設為多次可用,但需要明確防止無成本無限觀察導致不合理的最佳化;這可以透過正觀察成本、觀察時間或有上限的可用次數處理。若真的取得真實人因資料,還應預先註冊與本模型有關的具體可否證預測,例如兩次不同方向失敗後是否較容易回到原先偏好的方向,而非事後挑選最有趣的笑話版本解釋所有操作。
本研究的荒誕性存在於問題表面,其學術意義存在於把兩種失敗原因、部分可觀察資訊與跨期成本區分清楚。用兩個方向建構一個看似第三面的故事並不困難;困難的是避免把條件最優策略誤作真實世界的頻率定律,或把合成樣本誤作真實使用者。只要保留這條界線,對 USB 插頭的抱怨就可以成為一個容易重現、容易反駁,而且能傳達貝氏決策原理的微型研究問題。
12. 參考文獻(References)
Hick, W. E. (1952). On the rate of gain of information. Quarterly Journal of Experimental Psychology, 4(1), 11–26. https://doi.org/10.1080/17470215208416600
Kaelbling, L. P., Littman, M. L., & Cassandra, A. R. (1998). Planning and acting in partially observable stochastic domains. Artificial Intelligence, 101(1–2), 99–134. https://doi.org/10.1016/S0004-3702(98)00023-X
Langer, E. J. (1975). The illusion of control. Journal of Personality and Social Psychology, 32(2), 311–328. https://doi.org/10.1037/0022-3514.32.2.311
Ross, S., Pineau, J., Paquet, S., & Chaib-draa, B. (2008). Online planning algorithms for POMDPs. Journal of Artificial Intelligence Research, 32, 663–704. https://doi.org/10.1613/jair.2567
Smallwood, R. D., & Sondik, E. J. (1973). The optimal control of partially observable Markov processes over a finite horizon. Operations Research, 21(5), 1071–1088. https://doi.org/10.1287/opre.21.5.1071
Tversky, A., & Kahneman, D. (1974). Judgment under uncertainty: Heuristics and biases. Science, 185(4157), 1124–1131. https://doi.org/10.1126/science.185.4157.1124
附錄 A. 重現與數據類別
python3 Cycle_003/Paper_018/analysis.py 重新計算 Bayesian Bellman 值、有限歷史的概率分枝、短期獨立窮舉、每策略 35,000 次合成模擬,以及全部五張研究圖。結果可從 data/summary.json 讀取;圖像自動生成於 figures/,無外部資料集、用戶資料或私有模型權重。這些資料分屬 E 類純理論推導和 D 類電腦模擬;沒有 A 類實地觀察、B 類真實公開樣本或虛構受訪者。
附錄 B. 政策與成本的獨立重算
在不使用主要求解器快取的 exhaustive_best_cost 中,有限期最小成本由每一步「停止/試 0/試 1/選提示」的全部可能分枝直接列舉,並同 Solver.decision 在 1 至 3 期的多個狀態比較。exact_metrics 使用政策指定動作而非最小化運算,另外計算各策略的成功概率、停止概率、嘗試數與成本。Monte Carlo 模擬器則先抽真實 H,才依動作生成觀察;這與 exact_metrics 的期望權重演算法在結構上不同,有助發現分枝條件或後驗更新的錯置。研究尚未將任何參數聲稱為實測值,亦未採用人類實驗的顯著性檢定。