摘要
在群組通訊中,一項簡單的求助或確認訊息可能同時展示給數十名成員,卻長時間沒有人回答。「人多應該更快有人回答」與「每人都以為別人會回答」之間存在值得精確研究的張力。既有旁觀者效應、志願者困境及電腦中介溝通研究指出群體規模與責任分散的關係,但群聊介面呈現的潛在接收者人數,可能不同於某一時刻真正注意及有能力回覆的人數。本文提出「幽靈聽眾悖論」作為待檢驗的概念框架:成員依可見聽眾數形成他人會回覆的主觀預期,惟其中一部分在相關時段沒有注意訊息,因此集體回覆機率可能顯著低於理性決策者所想像的水平。研究從對稱志願者困境推導個體混合策略,建立主觀人數 m、每輪注意機率 a、成本效益比 q 與首回覆等待輪數 T 的關係,進一步獲得固定實際活躍人數下的單調性命題、回覆可靠度門檻及具明確條件的指派改善準則。以事先指定的示範參數進行三萬次獨立蒙地卡羅抽樣,模擬期望與解析結果在抽樣誤差範圍內吻合。本文的貢獻是識別「可見但不可用」的認知錯配及其可反駁的預測;結果屬條件性理論與合成數據,尚無實地因果證據。
關鍵詞:幽靈聽眾悖論;群組通訊;責任分散;志願者困境;注意力可用性;首回覆時間
1 引言
1.1 人很多,回答卻很少
設想某項課堂小組工作已經接近截止時間。一位成員在二十四人的聊天群組詢問:「明天的投影片,誰可以幫忙核對最後一頁?」訊息可能已成功送達,也可能顯示有多人讀取,但仍沒有明確承擔者。若改為向一名確實有空的成員提出相同請求,回覆反而可能來得更快。這種情境不是要宣稱大型群組必然無效,而是提出一個清楚的因果疑問:介面所顯示的社會對象數,能否使個人低估自己需要出手的程度?
生活中的「群組人數」至少有三種互不等價的意思。第一是名單上存在的帳戶數;第二是成員相信有機會看到並回覆的人數;第三是當下真的有注意力、時間與能力作出有效回覆的人數。若研究把這三者直接視為同一個數,則界面設計、時間差、靜音功能及潛水行為都會被混入一般所謂「群組越大」的比較,形成重要的測量問題。
1.2 研究問題與貢獻邊界
本文研究四個問題。其一,當個體預期的接收者數比真正可以回覆的人數大時,每輪成功回覆機率會如何改變?其二,隨群組規模擴大,注意力可用性會否改變規模效應的方向?其三,如何定義滿足服務水準的注意力門檻?其四,將請求指派給一位具名成員,在哪些條件下能改善結果?論文從極簡模型開始,保留清楚的反證條件,避免把所有群聊沉默簡化為懶惰或冷漠。
此研究並非聲稱發現旁觀者效應,亦沒有首次提出志願者困境。Diekmann(1985)早已形式化至少一人付出成本便可提供公共利益的局面;Markey(2000)已就即時線上群聊研究旁觀者數量、具名求助與回應時間。本文的範圍更窄:在已知那些理論的條件下,明確區分「以為能回答」與「實際有空回答」的人數,並以機率模型展示此一差距會產生甚麼可以觀察、也可能遭反駁的後果。
2 文獻回顧與研究定位
2.1 旁觀者效應及其情境依賴
Darley 與 Latané(1968)研究緊急情境中旁觀者對責任的感受;Latané 與 Darley(1968)亦指出他人的不作為可能改變個體對模糊情況的解讀。這一脈絡同時包含責任分散與情境解釋的相互影響,不能簡化成「人越多必然越冷漠」。Latané 與 Nida(1981)的回顧強調事件模糊性、其他人在場與否及溝通渠道的重要性。Fischer 等人(2011)的後設分析進一步探討危險程度等調節因素;因此,一般幫助行為研究不能直接推導每個群聊、所有任務的固定效應大小。
本文面對的多為非緊急、低至中等風險的協作訊息,故使用旁觀者研究作概念背景,而不把救援實驗的行為機率直接拿來校準聊天模型。相反,將該文獻視為提醒:可見他人在場、他人有無行動、個人能否識別責任等特徵,都可能影響是否主動回覆。這一類比在高風險救援、私人諮詢或強烈義務關係中可能失效。
2.2 志願者困境、成本及時間
在志願者困境中,只要有一位參與者付出成本,所有人便能享受共同利益。Diekmann(1985)研究此類社會困境的混合策略與溝通;Weesie(1993)研究非對稱性及行動時機。Archetti(2009a, 2009b)進一步討論群體大小、公共利益及合作策略。在對稱完全資訊的特定設置下,個體可能隨其他可行動者數量增加而降低自己出手的機率。這並不是本文新發現,本文直接承認它是基礎模型。
本研究的新增假設是,成員用於估計責任的對象數 m,可能大於實際能回覆的人數 n。這不是古典均衡中的理性共同知識,而是存在主觀錯誤的數碼環境。正因如此,後文只把由 m 計算的行動機率稱為「以主觀人數為基礎的條件混合策略」,不將失配情況誤稱為真正的完全資訊納許均衡。
2.3 數碼參與、可辨識性與社會責任
Markey(2000)在電腦中介溝通中觀察到,旁觀者人數與求助反應時間相關,並報告指明某位旁觀者姓名時求助更快獲得回應。此成果是本研究設計指派條件的重要前例,不應被包裝為本文的新實證發現。Preece、Nonnecke 與 Andrews(2004)透過線上社群調查整理不發言者的不同原因,顯示沉默不能全然視為無意識或不負責任;本文所謂沒有注意力,僅為多種不回覆原因中的一種。
Karau 與 Williams(1993)的社會閒散後設分析將共同工作時的努力投入與個人可辨識性等因素聯繫起來。Forsyth、Zyzniewski 與 Giammanco(2002)顯示責任歸屬並非總是均分,也可能集中於部分角色。這兩項研究提醒我們,群聊成員的角色、專業度與被點名狀態並不真的相同。論文選擇先以同質參與者建立基線,再把能力差異、關係強度及可辨識性列為明確的邊界條件。
2.4 待解釋的缺口
現有研究提供個人責任、群體規模及線上參與的概念,但欲測試「顯示很多人、實際只有少數人在場」仍須區分名單長度、主觀可行動人數及實際注意力可用性。既有文獻是否曾使用其他模型描述同一機制,需要系統性文獻回顧才能全面斷言;本文不作世界首創的斷言,只在此選取文獻脈絡內提出可追蹤的數理擴充。
3 原創概念:幽靈聽眾悖論
3.1 現象定義
「幽靈聽眾」是指被某位成員計入可能承擔回覆責任的人,卻在指定時間窗內沒有注意力或能力參與的人。它是一個由主觀信念與實際可用性所界定的關係概念,不是對任何真實群組成員的人格評價。「幽靈聽眾悖論」則指在指定假設下,增加被認為可回覆的人,可能降低同一群實際可用者的出手機率,結果即使看似接觸到更多人,首回覆等待時間仍拉長。
若群組有 m 名被感知為可回覆的人,但只有 n 人在當輪真正可用,則假想差額 m−n 可用作描述錯配強度。此比值在固定時間內可能迅速變動:午飯前所有人忙碌、會議完結後大多數重新上線,皆可改變 n 而不改變 m。當群組名單數與主觀有效對象數不同時,實驗應另外測量參與者的主觀估計,不能逕以畫面顯示的成員總數代替 m。
3.2 機制及明示假設
考慮一項只需要至少一個有效回覆的公共任務,例如確認共用資料的單一版本。若有人回答,全體獲得效益 B;回答者另外負擔私人成本 c,且 0<c<B。每位在場者只能選擇「本輪回答」或「本輪不回答」,不知道同輪其他人的決定,也暫時看不到他人的輸入中狀態。各人最初相信共計 m 人能回應,而且以相同方式行動。現實中只有 n≤m 人有注意力;在可變注意力版本中,每人在每一輪獨立地以機率 a 注意到訊息。
本文不假設閱讀回條等於認知投入,不假設被看到的每名成員都具同等專業,也不假設有回覆就能完全解決問題。它選擇把這些複雜性移到可測量的變項,讓數學命題有明確適用範圍。對於無成本的問候、高度個人化請求、帶有懲罰機制的工作指派及需要多名成員各自回覆的任務,本模型不直接適用。
3.3 理論命題
命題 P1:當真正可回覆的人數 n 固定、成本與效益固定,且所有人按照共同預期的 m 決定出手機率時,增加 m 將降低每輪至少一人回覆的機率。命題 P2:當 m 固定時,提高 n 或改善注意力機率 a 會提升每輪成功機率。命題 P3:在其他條件固定的指定者模型中,具名責任人的可用回覆機率高於普通成員的當輪出手機率時,明確指派能改善首回覆率。以上均為模型內部可證明結果,尚不是對所有現實群聊的普遍定律。
4 數學模型與推導
4.1 符號與效用
| 符號 | 定義與單位 | 取值/角色 |
|---|---|---|
| m | 主觀預期可回覆對象數,人 | 整數,m≥2 |
| n | 當輪實際可回覆對象數,人 | 0≤n≤m |
| a | 每人每輪具注意力的機率 | 0≤a≤1 |
| B、c | 公共回覆效益、私人回覆成本 | 0<c<B |
| q | 成本效益比 c/B | 0<q<1 |
| p(m) | 以主觀 m 決定的回覆機率 | 0<p<1 |
| Q、T | 每輪至少一個回覆機率;首次成功輪數 | 0≤Q≤1;T≥1 |
在一輪互相沒有協調的決策中,個體若主動回答,自己獲得 B−c;若選擇沉默,只有其他至少一人回答時才能得到 B。若其他 m−1 人各自獨立以機率 p 作答,個體選擇沉默的期望效用是 B[1−(1−p)^(m−1)]。若兩種行動都可能以正機率出現,其主觀無差異條件為:
由於 q∈(0,1),m 增大時 p(m) 下降。這一步沿用經典對稱志願者困境的混合均衡邏輯,原本預設 m 人都能出手;當現實 n<m 時,式(3)只是主觀信念條件下的行為規則。若個體知道其他人不在線,理性的更新可能令其改用 n 而非 m,錯配便會減弱甚至消失。因此,此研究真正檢驗的應是主觀人數是否偏高以及是否引發行為調整。
4.2 固定實際可用人數:錯配命題
如果只有 n 人能回覆,且這 n 人採用式(3)的同一回覆機率,各人獨立作答,則當輪完全沒有回覆的機率為 (1−p)^n;至少一個有效回覆的機率為:
令 L=−ln q>0,則 Q=1−exp[−nL/(m−1)]。當 n 固定、m>1,可直接求出:
反過來,在 m 固定時,∂Q/∂n=L exp[−nL/(m−1)]/(m−1)>0。這兩個方向相反的比較靜態構成悖論的核心:增加真正能出手的人會改善回覆;只增加大家以為會出手的人則可能削弱各人的責任感。n=0 時 Q=0,沒有等待時間上的有限期望;n≥1 時仍有正成功機率。
若所有條件在每一個獨立、等長的決策輪重設,首次有人回覆的輪數 T 服從幾何分布。以一輪為基本時間單位,T=1 表示第一輪有人答,得到:
將式(5)代入 E[T] 的導數,∂E[T]/∂m=−(∂Q/∂m)/Q²>0。這一推論依賴每輪行為穩定、決策時間等長、每輪獨立等假設;真實聊天的等待可能包含睡眠、不同時區、事件緊急程度及跨輪學習,並不必然是幾何分布。
4.3 隨機注意力:每輪真正可用的人都可能改變
固定 n 能顯示認知錯配的單調性,但無法反映成員間歇上線。現在假設 m 個名單中各人每輪獨立地以機率 a 可回覆;注意到訊息的人再獨立以 p(m) 參與公共任務。因此某個名單成員當輪實際回覆的機率是 a p(m),而當輪活躍人數 N_r 服從 Binomial(m,a)。邊際化後,群組當輪沒有任何回覆的機率是 [1−a p(m)]^m,故:
當 a=0 時 Q̄=0,等待期望為無限;當 a=1 時,式(8)回到 n=m 的傳統對稱模型。對於固定 m 和 q,因為 ∂Q̄/∂a=m p(m)[1−a p(m)]^(m−1)>0,較多人當輪能注意確實改善服務率。但若同時令 m 增大,不能直接宣稱 Q̄ 總是下降,因為可注意的潛在來源也隨名單增長。更精確的極限為:
式(10)揭示與注意力相關的上限:擴大名單不能任意將回覆機率推近一,除非成本結構或注意力條件同時改變。某些參數區域可出現非單調規模效應,所以本研究的 P1 僅針對固定 n 的比較,而非一概替所有群聊的擴張作方向性預測。
4.4 回覆門檻、冗餘及可辨識的責任
設組織要求至少在某一輪取得回覆的機率不低於 τ,0<τ<1。在固定 n 模型,將式(4)重排,需有 n≥(m−1)[−ln(1−τ)]/L。若需要的 n 超過 m,該服務目標即使全員同輪有空亦不可達,必須調整成本、回覆激勵、可用性或規範,而不能僅再增加「被想像的」對象。
在隨機注意力模型,式(8)給出最低注意力條件:
對固定情境,例如 m=24、q=0.65、τ=0.20,式(12)算得最低每輪注意機率約 0.50;若目前只有 0.30,當輪服務率未達目標。注意「回覆次數」也不是越多越好:若當輪實際回覆人數 K~Binomial(m,a p),則 E[K]=m a p,而超過首位的冗餘答覆期望為 E[(K−1)_+]=m a p−Q̄。當任務只需一個答案,這個量可表示重複勞動;在需要多個獨立意見的任務中,則不能稱為浪費。
4.5 具名責任者的條件式改善準則
另設管理者點名其中一位成員。該成員每輪有空的機率是 a_d;在有空且知悉被指派時,以條件機率 d 回答。為使介入可以被解析比較,暫假設其餘 m−1 人的出手機率仍維持 a p(m)。這是凍結其他人政策的短期反事實,並非指派後重算的全面博弈均衡。至少一人回覆的機率為:
與無指派的式(8)相比,Q_tag>Q̄ 的充要條件是 a_d d>a p(m),也就是被指定者實際當輪回答的機率必須高於他在普通群組機制下的有效答覆機率。若具名者根本無法上線,或被指派而產生強烈反感,改動未必有效。
這個準則提供可供試驗的干預方向:清楚說明「誰負責」或許有用,但效果取決於被指派者的可用性與意願。式(13)並沒有處理指派後其他人全部退後、社會規範轉移、責任轉嫁,故不能從它推出任何實地成效保證。
5 模擬設計、檢查與結果
5.1 參數來源及演算法
本研究沒有收集聊天訊息、個人資料或問卷。所有參數均是為檢查方程與展示情境而自行指定的假設值,絕非文獻估計。設定 q=0.65、m∈{6,12,24,48}、a∈{0.30,0.60,1.00},形成十二種情境。每個情境模擬 30,000 個相互獨立的虛擬對話,固定亂數種子 20261015。每輪先對所有成員抽取注意狀態,再為有空者依 p(m) 抽取是否回答;如果沒有答案就進入下一輪,直到第一個有效回答。蒙地卡羅標準誤以各獨立對話的首次回覆輪數樣本標準差除以樣本數平方根估計。
每輪獨立重抽注意力,是對「每輪有不同時間空檔」的抽象,並不等同同一批人永遠在線或永遠不在線。若注意力在整段研究期間固定,則存在完全無人注意的對話,其無條件等待期望可能無限大;本文的有限平均值只屬於明定的動態重抽情境。詳細程式、全部十二個數值結果及生成圖片檔均附於專案中以供重現。
5.2 核心結果:預期聽眾與真正注意力錯配
在固定 n=6 的示例中,若個體正確地相信只有六人可回答(m=6),式(4)得到 Q=0.404,期望約 2.48 輪。若同樣六人卻相信二十四人均可能作答(m=24),Q 下降至約 0.106,期望約 9.41 輪。這不是根據實際聊天統計得來的比例,而是同一組效用假設下的數理反事實;其目的在於隔離「錯估人數」的純效果。
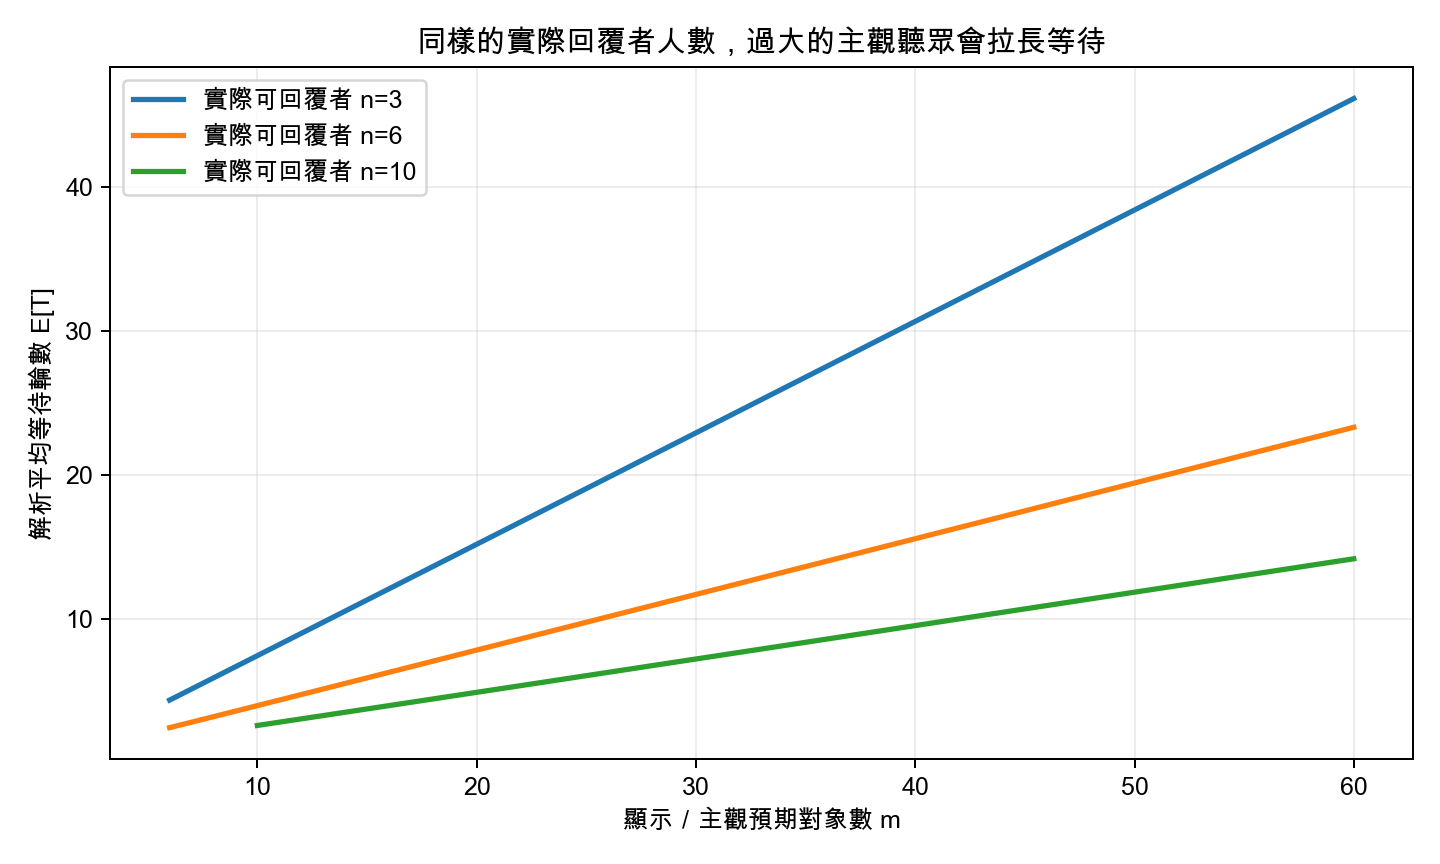
圖 1 固定實際可回覆人數 n 時,主觀對象數 m 增加所造成的解析等待時間變化;所有曲線均為假設 q=0.65 的模型計算。
在隨機注意力版本中,m=24、a=0.30 產生 Q̄=0.1254、解析平均 7.975 輪;同參數蒙地卡羅平均約 8.004 輪。提高注意力至 a=0.60,解析平均縮短至約 4.244 輪;當 a=1.00,則約為 2.762 輪。圖 2 以整個參數平面表達這種敏感度。不同尺寸的群組在低注意力時都可能出現延遲;但圖形只是模型的地形圖,不能據此推斷任一通訊平台的真實參數。
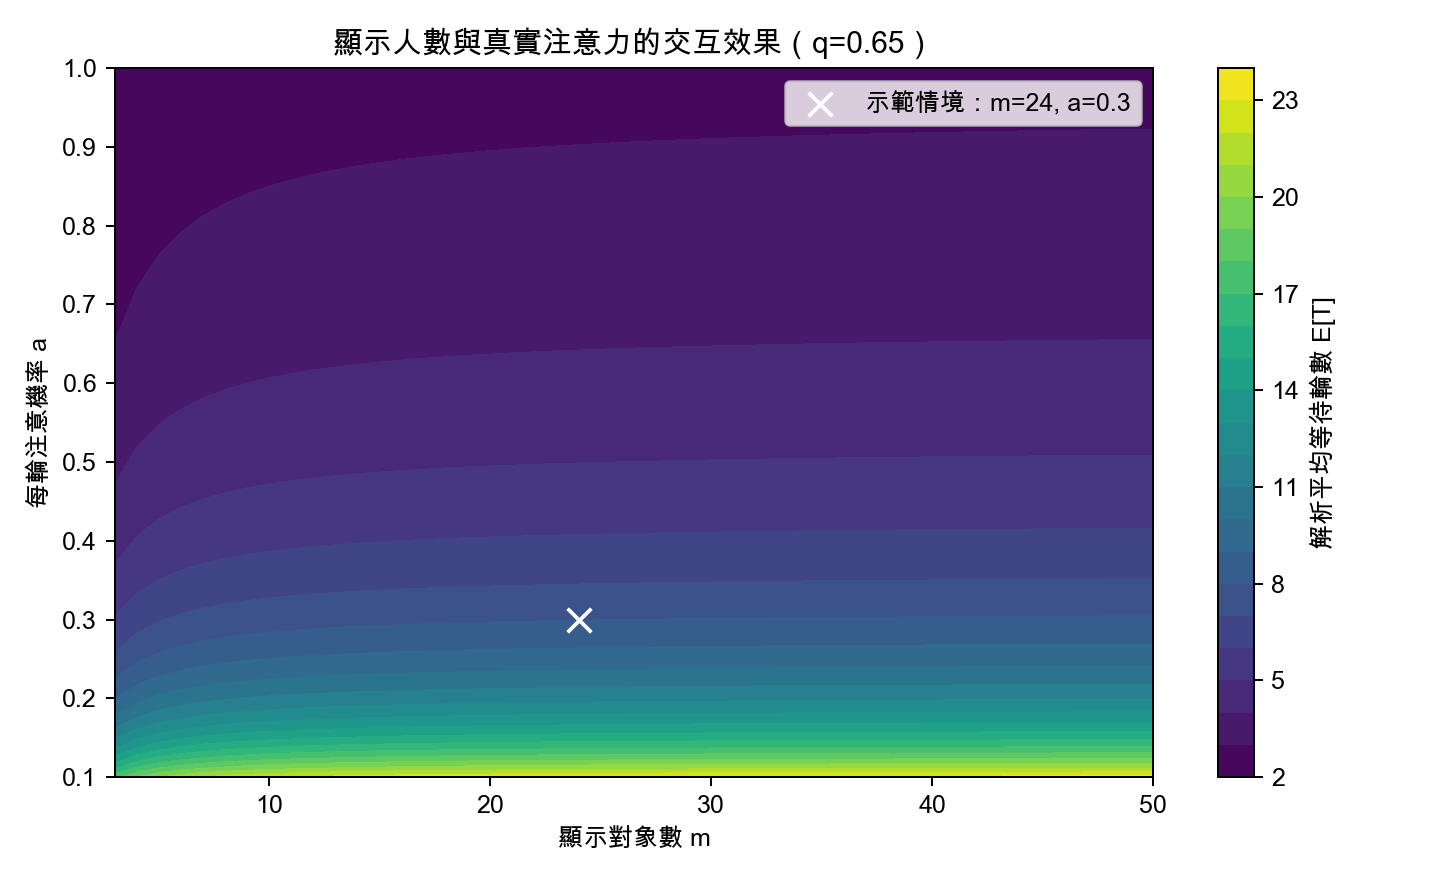
圖 2 當輪注意機率 a 與顯示人數 m 對解析平均等待輪數的聯合影響;白色叉號為示範情境,色階只反映方程(8),不是現場資料。
| 顯示人數 m | 注意機率 a | 解析平均輪數 | 蒙地卡羅平均輪數 |
|---|---|---|---|
| 6 | 0.30 | 7.159 | 7.146 |
| 6 | 1.00 | 2.477 | 2.471 |
| 12 | 0.30 | 7.703 | 7.695 |
| 24 | 0.30 | 7.975 | 8.004 |
| 24 | 0.60 | 4.244 | 4.230 |
| 24 | 1.00 | 2.762 | 2.749 |
| 48 | 0.30 | 8.112 | 8.192 |
表 2 僅擷取完整 CSV 中的七列;每列的模擬次數均為 30,000,標準誤及冗餘回覆亦保存在原始數據檔。樣本均值與解析期望的一致性檢查通過,但這只證明程式實現符合所選隨機過程,不能驗證人的實際心理決策是否遵循式(3)。所有看似精確的小數位均是運算結果,並非量表測量精度。
5.3 條件性指派:提升多少才算有效
以 m=24、a=0.30、q=0.65 作基線,假定特定責任者每輪可用機率 a_d=0.70,而可用時回答機率 d=0.85,式(13)給出 Q_tag≈0.644,平均約 1.55 輪,相對於基線 7.98 輪有顯著的理論改善。這兩個介入參數純屬示範設定;較高的 a_d 可能來自預先查詢是否有空,並非「點名」這個動作本身必然製造了注意力。
為避免誇大,圖 3 額外採取較嚴格的對照:指定者的可用機率與普通成員相同,即 a_d=a,並分別設定 d=0.45 與 0.85。當指定者沒有額外可用性優勢,具名指派是否有用仍取決於可用時的回覆意願。未來實驗應分開操弄「是否被點名」與「是否先確認有空」,才可能辨識這兩種機制。
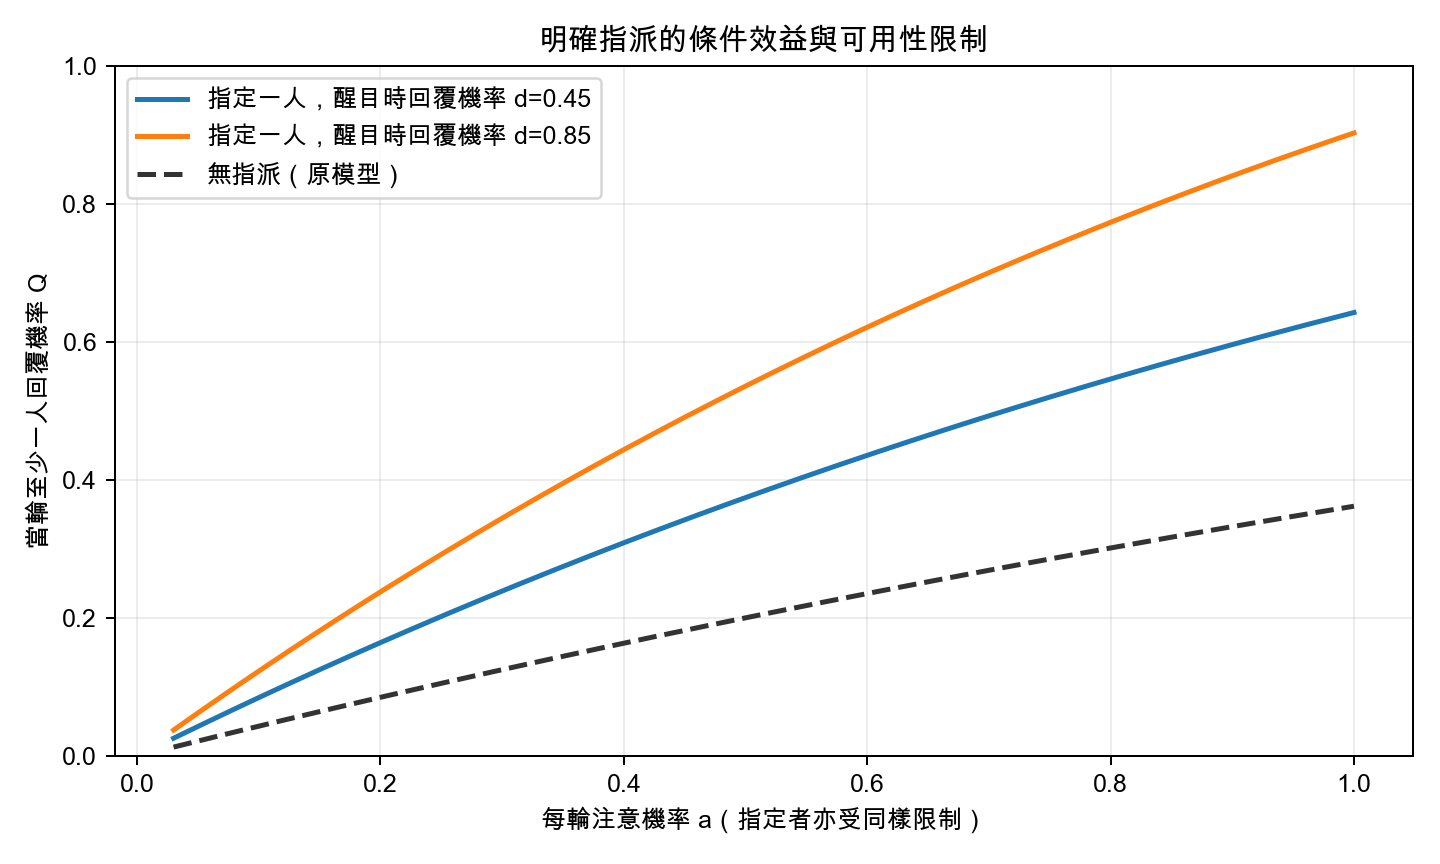
圖 3 有無具名指派的當輪成功機率比較;指定者與一般成員在此圖採相同注意機率,其他參與者政策保持不變,屬條件式反事實。
6 討論:模型能解釋甚麼,不能解釋甚麼
6.1 看似很多人,實際依靠少數人
「幽靈聽眾」對應一項認知與技術之間的錯位。聊天工具可以低成本地把同一個訊息傳送給許多人,但傳送範圍不保證注意力同時存在。若個人把介面顯示的名單直接當作負責任的有效供給,便會在作答前錯估其他人的行動機率。當此判斷同時發生於每個真正有空的人,整體可能出現無人作答的延遲。它尤其適合用於描述需要「至少一人」完成的確認任務、公共求助及輪流值守,而非所有訊息互動。
這個模型也提醒我們,當回答需要準確性或專業資格時,「有空」還應再區分為「有能力」。在實地研究中可把 a 拆成實際看到訊息的機率、看見後具備回答能力的條件機率,以及其主觀成本。唯有這些構成要素被獨立測量,研究才可能判別究竟是人數錯估、訊息時間安排、能力短缺,抑或社交風險造成沉默。
6.2 個體理性與群體結果的分歧
式(3)源於每個人對別人的反應作出個人理性計算,但其集體成功率並不必然達到最高。當其他人數被高估時,個體按照錯誤信念作出的保守回應尤其可能導致集體服務不足。這不是「所有人都是自私」的道德論點:即使成員重視公共利益,只要回覆需要花費私人時間,且主觀相信別人更有可能承擔,個人仍可能採用低機率回覆策略。
然而,混合策略均衡預測的是重複互動中的統計頻率,並非每個人有意識地抽取隨機數。真實人類可能遵守先到先答的規範、基於熟悉程度優先幫助朋友、受到社會身份與個人能力影響,甚至因一名成員先回覆而出現更多跟隨回應。因此,模型應被視為有結構的反事實基線,而不是對每一種群聊沉默的全能解釋。
6.3 為何僅增加名單可能沒有用
直觀管理方案是在沒有回覆時邀請更多人加入群組,但式(8)顯示這會同時增加可用機會及稀釋各人認為自己必須出手的程度。其合成效果依成本比與注意力水準而變,不能用單一口號概括。在本文的示範參數中,m 由 6 增至 48 且 a 維持 0.30,解析平均反而由 7.159 輪升至 8.112 輪;這是特定參數條件下的數值比較,不代表規模必然導致延遲。其他參數或更明確的責任制度可能產生相反結果。
6.4 閱讀回條的曖昧性
把「已讀」當作真正可回答或承擔義務可能產生雙重誤差。首先,已讀只代表系統紀錄的界面事件,不必然等於理解、時間可用性或問題解決能力。其次,已讀顯示也可能創造反向作用:有人知道自己被發現已讀,反而更願意回覆,以維持自我形象。本文的簡化模型沒有估計這些心理效應。因此,標題中的悖論不能被理解為「已讀越多必然越不答」,而是可以利用已讀介面去設計操弄主觀人數的實驗。
7 研究限制與反例
第一,本研究使用相同 B、c、a 及 p 代表所有成員,忽略社交關係、角色、專業能力、權力不對稱與不同消息內容;Weesie(1993)所研究的非對稱志願者困境正說明此限制不容忽視。第二,主觀人數 m 被視為共同信念,但實際上不同成員可能對群組有效人數有不同估計,且會隨時間更新。第三,所有人每輪各自獨立作出回覆,無法表現讀取同一通知時的同步活動、公開打字提示與其他人回覆所造成的策略連動。
第四,每輪完全重設注意力與決定過程是一項有力但嚴格的便利假設;睡眠、工作周期、提醒推送、跨輪記憶及學習都會破壞幾何等待模型。第五,「至少一人」公共任務不適合收集二十份互不相同答案的投票、需要每人簽名的確認或私人情感關懷。第六,文獻檢查以公開書目、出版者頁面及摘要為主,並非完整系統性回顧,更沒有大規模研究追蹤證據。
最重要的反例是小型而高凝聚力的群聊:即使顯示二十個人,每個人都知道只有某位組長會回覆,主觀有效對象數實際接近一,本文的 m 不應機械設為二十。另一個反例是大量成員提供專門服務的緊急互助群;其可用性可能隨規模迅速增加,群組越大回覆越快。第三類反例是責任明確、個人成本接近零的自動工作流程,此時模型的內點混合策略前提消失。只要實驗出現這些結果,應先檢驗假設,而不是將與理論不符的資料剔除。
8 未來實驗、識別策略與倫理考量
8.1 預註冊的因子實驗
可招募同意參與的成年人,讓受試者在實驗平台處理相同難度、只需一個有效回覆的低風險問題。採用二因子隨機設計:其一是界面顯示的潛在讀者數,例如 6、12、24;其二是當輪真正可回覆的協作者比例,例如 0.30、0.60、1.00。真實可用性可由在場協作者的排程控制,而顯示人數需以清楚揭示的模擬群組角色作實驗操弄,並於結束後完整告知參與者情境安排。另設有無具名指定、指定者是否事先確認可用的獨立隨機處理。
主要依變項為從求助開始至首次有效答覆的時間,另記錄每輪回覆比率、同輪重複回答次數及無人回覆比例。中介量應包括受試者對「別人可能有空」的主觀估計、個人責任感及預期回覆成本。為避免把失敗回覆者系統性刪除,須事先設定觀察截止時間,並使用存活分析處理右設限;可使用多層次存活模型處理同一受試者或群組的相關性。
8.2 反事實識別與競爭解釋
一個關鍵假說是:控制真正能回答的人數後,只改變界面所顯示的可回覆者人數,仍可透過主觀有效人數估計影響首回覆率。若控制主觀有效人數後,顯示名單的效果消失,會支持本文的中介機制;但若顯示名單同時改變受試者對訊息重要性或社交規範的推斷,便要使用額外操弄識別原因。單純比較現實中大小不同的群組無法排除熟悉程度、內容難度、群組目的及活躍程度的混雜。
研究亦應測試非單調的規模效應,事先估計交互作用而不只檢驗一個平均主效應。可預註冊失效條件:若認知估計未隨界面顯示改變,模型所提出的「主觀人數錯配」機制便缺乏第一階段支持;若已知可用人數上升卻使服務率下降,則獨立行動與固定成本假設需要重新檢查。所有統計顯著性、效果大小及信賴區間必須待真實實驗完成後才能報告。
8.3 資料倫理與實務應用
未經知情同意不應擷取私人聊天、讀取時間或工作表現作暗中研究。真實平台記錄可包含敏感的社交關係與生活規律,須限制資料最小化、保存期間與個人識別權限。對於機關或團隊的實際工作流程,較溫和的應用是讓成員自願標示目前是否有空、設定輪值責任與明確求助路徑,而不是利用點名公開羞辱長時間沒有回答的人。
9 結論
本文提出「幽靈聽眾悖論」作為可檢驗的數碼群體互動框架:當人們以為很多人能回覆,但實際可用者較少,責任預期和注意力供給之間便可能產生錯配。文章在既有志願者困境的對稱混合策略上加入主觀對象數與每輪注意可用性,證明固定實際回覆者人數時,增大主觀人數會降低首回覆率;並推導隨機注意力情境下的成功機率、等待分布、服務門檻及具名指派的條件準則。十二組合成模擬支持程式與解析式的一致性,但不提供現實因果證據。後續工作的關鍵是測量當事人的主觀有效聽眾、驗證規模與注意力的交互作用,及找出理論失效的社會規範與平台條件。這使「為甚麼一群人都不回答」成為一個可以量化、可以被反駁的研究問題,而不只是對他人的直覺批評。
參考文獻
Archetti, M. (2009a). Cooperation as a volunteer’s dilemma and the strategy of conflict in public goods games. Journal of Evolutionary Biology, 22(11), 2192–2200. https://doi.org/10.1111/j.1420-9101.2009.01835.x
Archetti, M. (2009b). The volunteer’s dilemma and the optimal size of a social group. Journal of Theoretical Biology, 261(3), 475–480. https://doi.org/10.1016/j.jtbi.2009.08.018
Darley, J. M., & Latané, B. (1968). Bystander intervention in emergencies: Diffusion of responsibility. Journal of Personality and Social Psychology, 8(4), 377–383. https://doi.org/10.1037/h0025589
Diekmann, A. (1985). Volunteer’s dilemma. Journal of Conflict Resolution, 29(4), 605–610. https://doi.org/10.1177/0022002785029004003
Fischer, P., Krueger, J. I., Greitemeyer, T., Vogrincic, C., Kastenmüller, A., Frey, D., Heene, M., Wicher, M., & Kainbacher, M. (2011). The bystander-effect: A meta-analytic review on bystander intervention in dangerous and non-dangerous emergencies. Psychological Bulletin, 137(4), 517–537. https://doi.org/10.1037/a0023304
Forsyth, D. R., Zyzniewski, L. E., & Giammanco, C. A. (2002). Responsibility diffusion in cooperative collectives. Personality and Social Psychology Bulletin, 28(1), 54–65. https://doi.org/10.1177/0146167202281005
Karau, S. J., & Williams, K. D. (1993). Social loafing: A meta-analytic review and theoretical integration. Journal of Personality and Social Psychology, 65(4), 681–706. https://doi.org/10.1037/0022-3514.65.4.681
Latané, B., & Darley, J. M. (1968). Group inhibition of bystander intervention in emergencies. Journal of Personality and Social Psychology, 10(3), 215–221. https://doi.org/10.1037/h0026570
Latané, B., & Nida, S. (1981). Ten years of research on group size and helping. Psychological Bulletin, 89(2), 308–324. https://doi.org/10.1037/0033-2909.89.2.308
Markey, P. M. (2000). Bystander intervention in computer-mediated communication. Computers in Human Behavior, 16(2), 183–188. https://doi.org/10.1016/S0747-5632(99)00056-4
Preece, J., Nonnecke, B., & Andrews, D. (2004). The top five reasons for lurking: Improving community experiences for everyone. Computers in Human Behavior, 20(2), 201–223. https://doi.org/10.1016/j.chb.2003.10.015
Weesie, J. (1993). Asymmetry and timing in the volunteer’s dilemma. Journal of Conflict Resolution, 37(3), 569–590. https://doi.org/10.1177/0022002793037003008