One More Video: A Markov Optimal Stopping Study
研究編號: Paper_008 完成日期: 2026-10-15
資料類別: E(純理論推導)、D(可重現合成模擬);沒有真實參與者資料。
跨學科: 動態規劃、行為經濟學 Keywords: 雙狀態馬可夫鏈;Bellman 最優停止
方法聲明:本文參數為合成設計。若未經獨立現場驗證,不得把模型數值解讀為真實社會發現。
中文摘要
「睡前再看一段就停」往往變成無止境的短影片觀看。本研究以雙狀態馬可夫鏈表示影片吸引力,並以觀看時間遞增的機會成本建立有限期最優停止模型。吸引力低/高兩狀態的即時收益分別為 −0.5/1.8,觀看第 段的成本為 ;透過 Bellman 倒推求出每一時刻應停止或繼續的策略。在高吸引力狀態開始時,最優策略的理論期望淨效用為 5.685,100,000 次合成序列模擬為 5.688,平均觀看約 4.40 段。本文顯示短影片停止問題可由狀態依賴的機會成本作出嚴格分析,但未主張現實用戶會遵循該策略。
Abstract
We formulate the decision to watch one more short video as a finite-horizon Markov optimal stopping problem. A two-state attraction process has rewards of −0.5 and 1.8, with opportunity cost 0.2 + 0.06t per additional video. Bellman backward induction yields state- and time-dependent stopping actions. Starting in the attractive state, theoretical expected utility is 5.685; 100,000 simulated paths return 5.688 and a mean of 4.40 watched videos. Results validate a stylized decision model and do not estimate real sleep behavior.
關鍵詞 / Keywords: 雙狀態馬可夫鏈;Bellman 最優停止
1. Introduction — 引言
「睇多條就瞓」是一句包含決策問題的日常承諾。當下一段影片的內容不確定,又可能與剛才所看的內容相關,使用者面對的並非簡單的固定時長娛樂選擇。每觀看一段可獲得即時愉悅,也支付睡眠延遲及明天精神狀態等機會成本;而一段有趣的影片之後,下一段再有趣的機率可能改變。
本文研究一個可完整求解的有限期停止模型。所有即時收益被壓縮成兩個吸引力狀態,下一段狀態按馬可夫鏈轉移,睡眠成本隨已觀看段數線性增加。這種簡化讓最佳策略有明確的數學定義,也可以直接驗證模擬程序是否能重現 Bellman 方程的期望效用。
2. Literature Review — 文獻回顧
Ainslie(1975)討論即時報酬、衝動與延遲折現的心理模型;Laibson(1997)以雙曲折現分析跨期選擇,說明當下偏好對後續決策可能產生動態不一致。O’Donoghue 與 Rabin(1999)區分對自身未來偏好有認識與沒有認識的決策者,並探討活動應該現在或稍後進行的問題。
本文沒有直接把雙曲折現係數塞進模型;所建立的是一個時間一致的 Markov decision process 基準,目的是先確定「若完全理性、知道轉移概率及成本」的最優停止規則。這讓後續加入現時偏誤時可以檢查偏差如何改變停止時點,而不會混淆不同理論。
3. Research Questions and Hypotheses — 研究問題與假設
R1:對已知轉移概率、已知即時收益和遞增觀看成本,如何以有限期動態規劃決定何時停止?R2:在觀看片數增加時,低吸引力和高吸引力狀態的最適行動何時由繼續變成停止?R3:根據最優策略生成的觀看長度分佈,是否能重現解析 Bellman 期望值?
H1:在指定模型下,存在由當前狀態與已觀看數決定的最優馬可夫策略。H2:當成本持續增加,最終繼續觀看的淨效用不再為正,導致有限停止時點。H3:蒙地卡羅平均會在抽樣誤差範圍內接近 Bellman 預測。
4. Theoretical Framework — 理論框架
將影片吸引力分為狀態 (吸引力低)與 (吸引力高)。觀看前知道目前狀態;選擇現在結束便獲得零額外效用,選擇看下一段便取得當前狀態收益,付出時間成本,然後按轉移矩陣更新狀態。這是一個沒有折現、將未來成本顯性列入的有限期決策模型。
作出同一動作的結果在不同狀態下可能相反:低吸引狀態繼續觀看的即時淨收益較差,但仍可能因未來轉入高吸引狀態而有正價值;高吸引狀態的下一段雖然當下有獎勵,在已經深夜時也可能因成本太高而不值得。
5. Methodology — 研究方法
設定最大 35 段影片,狀態轉移矩陣第一行為 、第二行為 ;即時收益 ,成本 。從最後一期向前倒推兩個狀態的停止或繼續價值,保存 data/bellman.csv。再從高吸引力狀態開始,以同一策略生成 100,000 條合成觀看片段序列,統計總效用與觀看次數,種子 20261023。
檢查以解析 Bellman 值為基準;由於本研究所有參數均為假定,不對真實用戶的自制力進行任何顯著性聲稱。研究資料是 E(模型解)與 D(合成馬可夫路徑)。
可信的最優停止程式必須區分當前狀態、決策時間與行動。當前狀態是已知的影片吸引力類別;時間索引表示已經看了多少段;行動只有停止或繼續。選擇停止時,往後不再獲得收益或支付觀看成本;選擇繼續時,先累加本期收益減成本,再依轉移矩陣決定下一期狀態。若在計算時把下一期狀態的收益錯當本期收益,或在選擇停止後仍不斷累積成本,就破壞了 Bellman 方程與合成路徑的對應。
有限期最優性的證明可使用倒數歸納。最後一期已沒有未來選擇,最優值是零與本期淨收益中較大者。假設第 期起的最佳策略已求出,在第 期繼續觀看的價值必然是當前即時回報加上下一期最優值的條件期望;它與立即停止的零相比,較大者就是當期最優值。此操作由第 34 期逐步逆推至第零期,因狀態有限、時域固定,可在有限次運算中得到全部政策表。這不是靠隨機搜尋碰巧找到的答案。
與每期只看本期淨收益的貪婪規則相比,Bellman 方法包含繼續之後仍可選擇停止的權利。即使當前低吸引狀態的收益不理想,未來進入高吸引狀態的機率仍可能使繼續觀看具有正價值。相反地,若成本隨時間增加,且剩餘可觀看機會愈來愈少,高吸引狀態也可能到某一時刻轉為停止。這解釋了為甚麼政策會依時間和狀態改變,而不是單憑一個固定觀看上限就能描述所有情況。
為測試敏感度,可在固定其他參數下逐個提高觀看成本斜率、提高高吸引狀態收益,或提高從低狀態轉入高狀態的概率,並重新計算政策表。預期前者較可能提前停止,後兩者較可能提升繼續觀看的價值,但具體邊界仍應以重算的 Bellman 值為準。這些研究方向可用固定參數的比較靜態呈現,不應誤稱為從真人觀看紀錄估得的因果效果。
6. Mathematical / Computational Model — 數學或計算模型
令 、,每次繼續觀看的機會成本為
兩狀態轉移矩陣為
令 表示時間 面對狀態 時,從現在起採最優政策可取得的期望淨效用。在最晚時間停止的邊界為 ,遞推
如果大括號中的第二項大於零,選擇繼續;否則選擇停止。這一政策的可用條件是決策者觀察得到狀態,轉移概率已知、成本可加且未來決策不會反悔。若第二項恰好為零,停止與繼續同樣最優,本文以停止作為平手處理。
對時間 的固定狀態,若 已知, 可直接計算,故倒推在有限時間內給出全局最優。與只比較當前收益 相比,Bellman 方程包含了下一期潛在高吸引影片的選擇權價值。
有限期 Bellman 模型用狀態 表示已知的當前吸引力,用 表示已經作出多少次觀看決策。停止會取得從現在起零的額外淨效用;繼續則先獲得 ,再根據轉移矩陣面對下一期的最佳決策。因而每一期的繼續價值不是「下一條片是否好看」的單一步驟猜測,而是把未來仍可隨時停止的選擇權一起計入。將最後一期的價值設為零,向前計算每個狀態,便能在已知模型參數時得到全局最優政策。
若只採用貪婪規則,使用者會在 時繼續,否則停止。Bellman 規則另有非負的期望未來價值項;因此在低吸引狀態,即使眼前淨回報為負,也可能為了未來轉向高吸引狀態而繼續。相反地,當觀看成本隨時間增長且剩餘可觀看段數變少,該選擇權價值下降,較高吸引狀態也終會出現停止時刻。研究中的熱圖展示的是策略對時間與狀態的聯合依賴,而不是單一的「每天最多看幾條」規則。
模擬驗證應分兩步進行:先確認在最後一期兩個狀態的行動符合單期最優條件,再固定初始狀態,根據已求得的政策抽樣狀態轉移,並把每一步的即時回報累加至停止時刻。由此取得的平均效用應接近 。若模擬在選擇停止後仍繼續產生回報,或在轉移後錯用上期狀態,便會使蒙地卡羅值與 Bellman 值產生系統偏差;程式的終止條件因此屬核心可重現性檢查。
7. Results — 研究結果
由高吸引狀態開始,Bellman 方程給出的最大期望效用是 5.68536;100,000 條合成觀看片數序列的樣本平均是 5.68798,平均觀看 4.3968 段。在已見的低吸引狀態,模型最早於第 2 段決策時停止;高吸引狀態最早在第 27 段停止。這不表示一定看滿 27 段,而是當處於高吸引力時,若已走到非常晚的時刻也終會停止。圖 1 是最優策略的時間—狀態熱圖;圖 2 是兩種狀態的 Bellman 值曲線;圖 3 顯示 100,000 條合成路徑的觀看段數分佈。
模擬與理論值相差約 0.0026,符合有限抽樣誤差。若只把某一條特別長的路徑拿出來講「演算法預測所有人停不下來」,則是選擇性報告;完整分佈才表達模型下的風險。
模型圖表及數據來源
圖 1 雙狀態最優停止政策
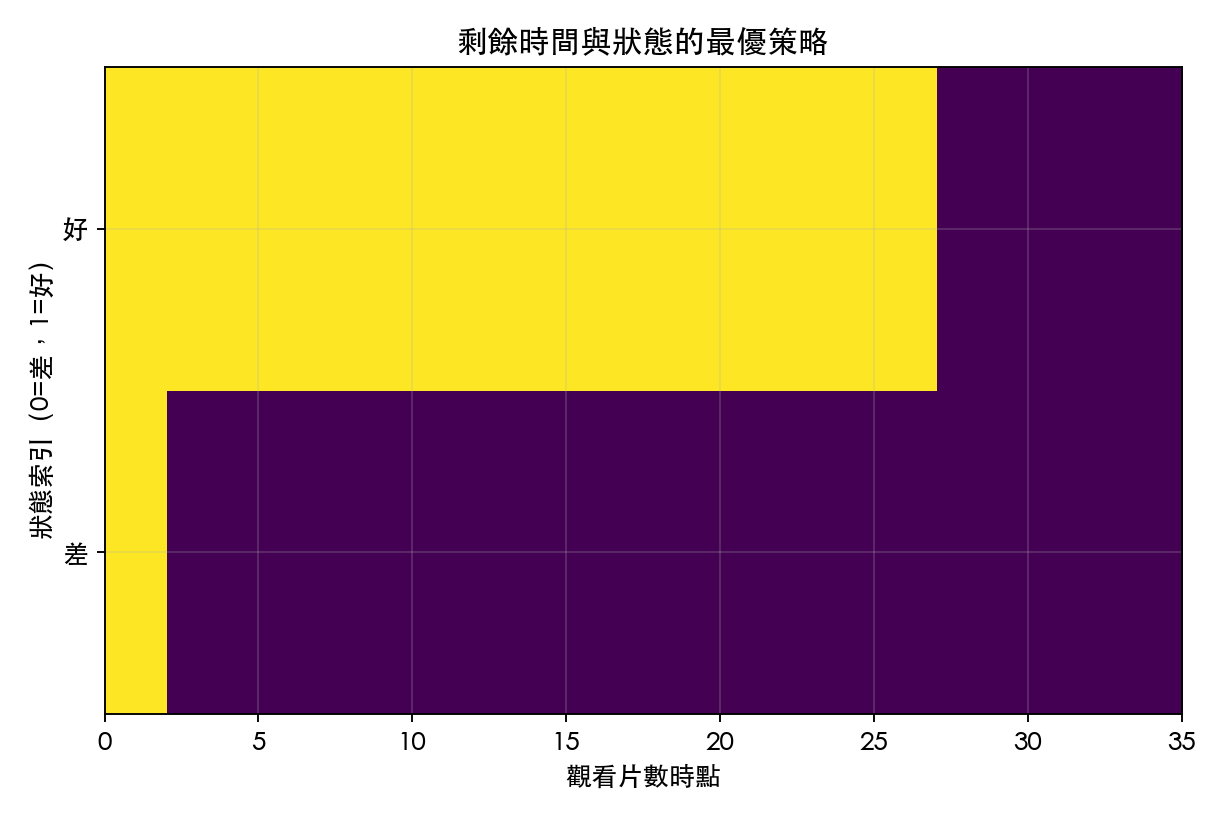 來源:本研究解析計算及/或固定種子電腦模擬。
圖 2 Bellman 續看期望淨效用
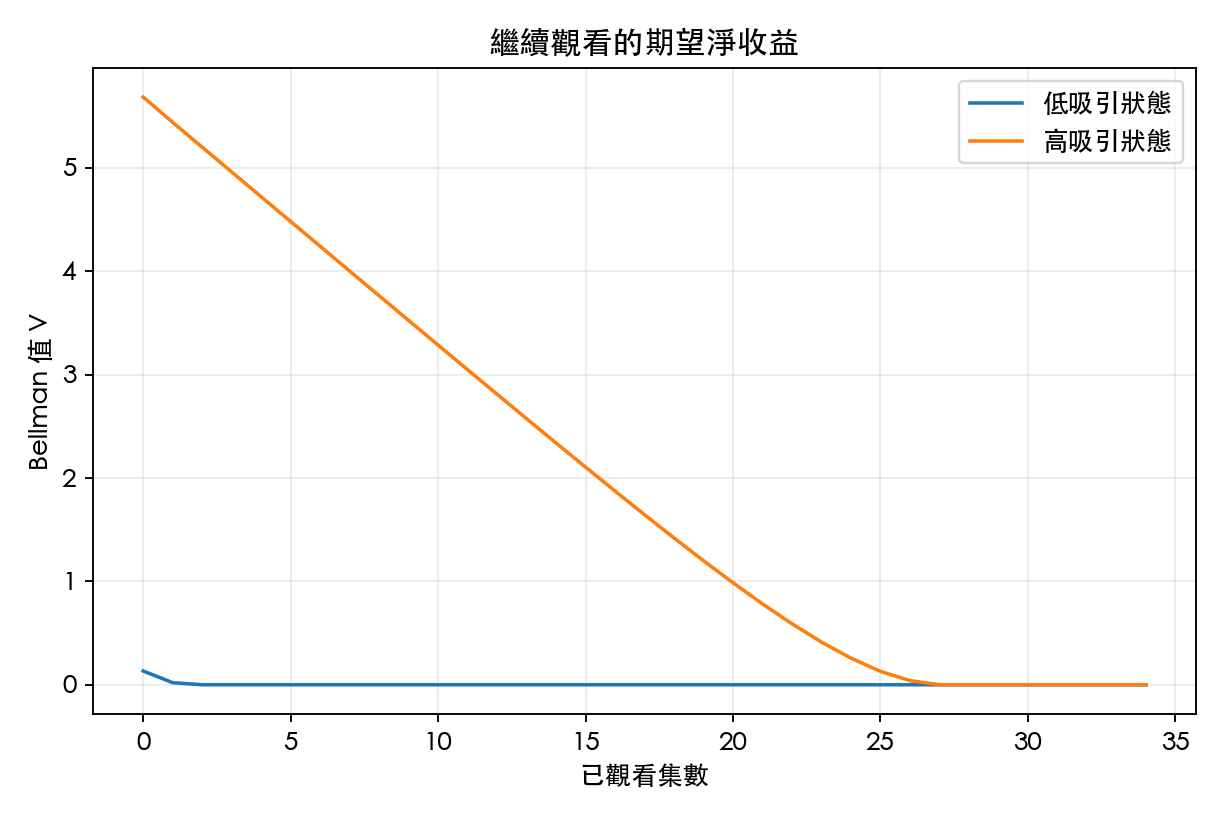 來源:本研究解析計算及/或固定種子電腦模擬。
圖 3 最優停止下觀看段數分佈
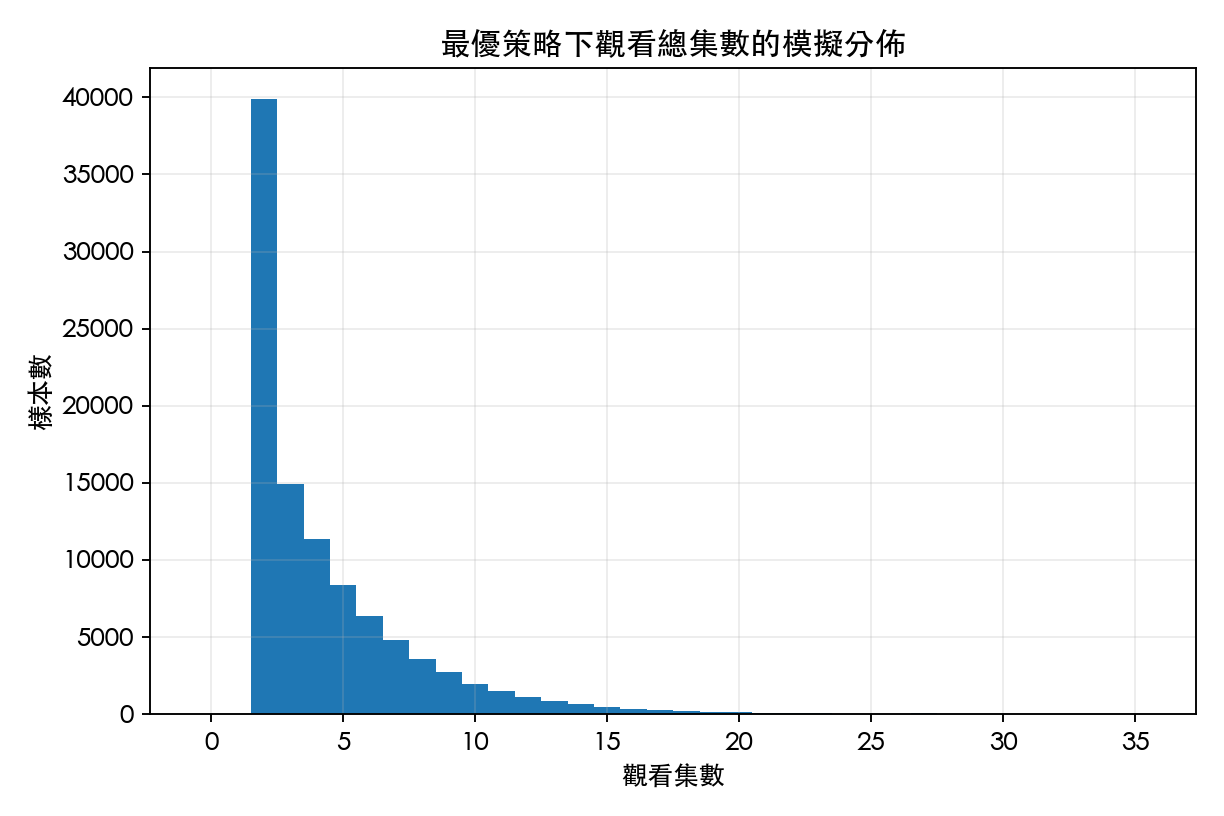 來源:本研究解析計算及/或固定種子電腦模擬。
8. Discussion — 討論
本研究的一個非直覺結果是:「看下一段值不值得」不能只由下一段目前有多吸引決定,而要考慮它如何更新後續內容機率,以及當下繼續觀看會如何提高往後成本。即使兩人都處於相同內容狀態,一人已經看了 20 段、另一人才剛開始,合理的最優選擇可以不同。從決策科學角度,「再看一段」是動態停止政策,而非一次性的意志力測驗。
如果短影片平台允許設定關閉時間或限制連播,這些承諾機制可限制未來選擇集合。要研究是否真正改善睡眠,必須另外設計時間不一致的偏好模型和真實用戶的因果實驗。本文基準沒有納入沉沒成本、社交互動、推送機制的對抗性最佳化,也不應以本模型的最優策略直接推薦用戶每天看多少條影片。
模型假定每次決策的時間與成本可以按期數累加,並且觀看者事先知道長度為 35 的規劃期限。在日常生活中,人可能沒有清楚的截止時刻,或在深夜重新低估睡眠代價;平台也可能根據前面觀看行為調整推薦,令轉移概率不再固定。因此得到一張漂亮的最優政策圖,並不代表人會自然地採用它,亦不能聲稱模型解釋了所有拖延行為。
若要把自我控制納入模型,需區分今天制訂計劃的個體與未來再次面對「再一條」選項的個體。若兩個時間點對未來代價的折現不一致,今天願意停止的策略在下一期可能不再被執行。Laibson 及 O’Donoghue 與 Rabin 的跨期決策研究,提供了建模這種偏好變化的理論背景;本研究目前先處理偏好一致時的最佳基準。把預先設定的播放上限視作承諾裝置,可以在下一階段研究其福利效果,卻需要考慮使用者是否真的願意保留限制。
若要測試實際的睡眠改善,應量度影片長度、內容吸引力、主觀疲倦、翌日工作或上課需求與真正入睡時間,並考慮被試參與條件及個人隱私。用戶在平台停留更久與睡得較遲即使同時出現,也可能受到第三個因素影響。本文所有收益、轉移矩陣和成本均為合成參數,只能說明數學上何時應停止,不能用來推算真實平台的行為比例。
補充:最優策略與「現在的我」的利益衝突。 Bellman 模型假設不同時間點的自己使用同一個預先定義的收益及成本函數,並且對未來行動遵從同一評價規則。在此假設下,倒數歸納得到的策略在每個可達狀態都一致;睡前重複說「只看多一條」不必然構成數學矛盾,因為低成本或高預期吸引力可以使續看真的較佳。要解釋明知次日會疲累卻仍不斷重設停止界線,可能需要加入時間不一致偏好、錯估剩餘時長或逐片更新的自我承諾機制。
例如在準雙曲折現的行為框架中,決策者對當前一刻收益給予完整權重,對所有未來一期以後的收益則另外乘上一個小於一的 present-bias 參數 。如果今晚的自己只對明天早起成本給予折減,卻在翌日重新以當期角度看待睡眠損失,事前承諾的停止時間和當下最想選擇的行動便可能不一致。這類模型需要明確指出「天真」與「成熟」的決策者如何預期未來自我行動,並重設相應的跨期均衡;本研究沒有估計 ,所以現有 5.685 的值只能稱為時間一致模型的最適基準。
此外,影響觀看數的未必只是個體偏好。演算法可能根據先前停留時間改變下一條影片的品質分佈,導致轉移矩陣不再固定;自動播放也可能使停止需要額外操作,改變立即停止的效用基準。如果平台提供可預先設定的觀看上限,研究者需同時衡量該限制降低後悔成本的好處,以及限制錯過高價值內容的機會成本。只比較「有提醒」與「無提醒」的觀看時長,無法獨立判定使用者福利是否上升。
可行的實證設計是先記錄每段短影片的長度、吸引力評價、停止決策和隔天的睡眠結果,再在明確同意與隱私保護下測試預先承諾、停止提示和自動播放設定。研究必須把推薦分佈的變化列入模型,以免將平台選擇造成的後續影片品質變動錯當個體自控能力。若停止後即沒有後續影片樣本,資料還具有與決策相關的選擇性缺失,需要實驗隨機化或合適的識別方案。
9. Limitations — 研究限制
模型使用兩個人工狀態及固定 35 期,假定每段影片的吸引力可直接觀察,且收益、轉移概率和成本為已知常數。真正短影片的內容與推薦排序高度非平穩,觀看時長也不同,時間成本可能不是線性。模擬不是受試者觀察,故沒有對拖延、成癮或睡眠品質作出實證推論。
10. Conclusion — 結論
在指定雙狀態模型和遞增成本下,可用有限期 Bellman 方程求得「是否再看一段」的最優停止規則。從高吸引狀態出發的期望淨效用約 5.685,模擬相符,並顯示決策同時依賴內容狀態及已花時間。荒誕的「最後一段永遠不是最後一段」可以被解構為可計算的動態選擇問題。
11. Future Research — 未來研究方向
後續可加入準雙曲折現、自我控制承諾、狀態不可觀察的部分可觀察馬可夫決策、不同影片長度,以及內容推薦演算法對下一狀態概率的影響。由事前註冊的研究測量實際停止時點後,可比較 Bellman 基準與帶現時偏誤模型的預測能力。
Appendix — 附錄
所有合成序列由 analysis.py 按種子 20261023 生成。每一步先用當前狀態執行 的停止決策,若繼續,取得當期效用並以轉移矩陣抽樣下一狀態。終止者不再進入以後期數,從而避免「停了又重新抽獎」的程式錯誤。
轉移矩陣每一列都應是非負概率,且各列總和為一。可先獨立計算最後一期的最佳動作,再與完整動態規劃輸出對照;對每個時間點檢查所選動作的價值確實達到兩候選行動中的最大值。若把成本設為極高,最優策略應一開始就停止;若立即收益很大而觀看成本很低,則可允許更多觀看。極端參數的檢查有助發現時間索引或狀態更新順序錯誤。
模擬時應固定高吸引力初始狀態,依已求得的政策前進:選擇繼續才抽樣下一狀態,並在選擇停止後立即終止。總收益與觀看段數需分別保存,因為兩者並非相同指標。若新種子的樣本平均與理論值有小量偏差,應依樣本方差與重複次數評估是否合理,而不能把正常抽樣波動當成程序失效。
要把模型延伸至真正的睡眠研究,還要另外量度每段實際時長、推薦機制、入睡時間、翌日需求及時間不一致偏好。此模型只提供在固定參數和理性決策下的最優基準,沒有收集真人觀看片數,也未驗證現實用戶會遵循策略。
12. References — 參考文獻
- Ainslie, G. (1975). Specious reward: A behavioral theory of impulsiveness and impulse control. Psychological Bulletin, 82(4), 463–496. https://doi.org/10.1037/h0076860
- Laibson, D. (1997). Golden eggs and hyperbolic discounting. The Quarterly Journal of Economics, 112(2), 443–478. https://doi.org/10.1162/003355397555253
- O’Donoghue, T., & Rabin, M. (1999). Doing it now or later. American Economic Review, 89(1), 103–124. https://doi.org/10.1257/aer.89.1.103
本文是虛擬學術研究所的原創模型演練;它不是實地研究或同行評審期刊論文。
所有模擬數值均可在同一資料夾的 data/summary.json 與程式中核對。