摘要
打字時最荒謬的瞬間,可能不是按錯一個字,而是輸入一整段後才發現首句錯字,於是連續按退格鍵,彷彿整段文字從未存在。本文將這種經驗轉化為延遲發現缺陷的隨機可靠度問題,考慮長度為 的打字區塊、每字錯誤概率、固定校對成本、修復啟動成本,以及從區塊內最早被發現錯字回退至末尾的補救規則。獨立錯誤情況下,本文推導區塊須修復的精確概率、回退長度的分布及期望、單位潔淨文字的時間成本,並以整數枚舉求最優檢查間隔。以完全人工設定的每秒五字、錯誤率 1.5%、每次校對三秒、修復啟動 0.8 秒及每字回退重建 0.18 秒為例,最佳檢查間隔為 68 字,期望每潔淨字需 0.32005 秒;九萬區塊合成模擬與精確公式相符。本文進一步分析假設的速度—錯誤平方律、不完整錯誤檢出,以及具有持續性的馬可夫錯誤群聚。結果指出固定區塊內長退格事件會隨錯誤概率提高而增多;但最佳檢查間隔未必永遠變短,且模型不能直接推論真實人類的最佳打字速度。本文以可重現且可反駁的設定解釋,為何「更快打完」和「更快得到正確全文」是兩種不同的績效指標。
關鍵詞: 打字錯誤;退格連擊;延遲偵錯;檢查點;更新報酬;隨機最佳化;錯誤群聚。
Abstract
Long bursts of backspaces may result from a late discovery of an early typing error rather than an unusually large number of independent mistakes. We introduce a deliberately stylized blockwise text-entry model in which errors arise during initial typing, inspection occurs every characters, and successful detection triggers a rollback from the earliest discovered error to the end of the block. We derive exact expressions for the probability of repair, the distribution and expectation of rollback length, and expected completion time per accepted clean character. The integer checkpoint interval is optimized under explicitly hypothetical inspection and repair costs. In an illustrative scenario with five raw characters per second, an independent error probability of 0.015, a three-second inspection cost, a 0.8-second repair setup cost, and a 0.18-second rollback cost per character, the optimal interval is 68 characters, costing 0.32005 seconds per clean character. Synthetic simulations of 90,000 blocks agree with the exact predictions. We extend the model to imperfect detection and a stationary two-state Markov error process, distinguishing observed corrections from silent residual errors. Our speed–error power law is a scenario assumption rather than an empirical claim, and reliable one-pass retyping is a substantial limitation. The results demonstrate how delayed inspection can create long correction runs and how optimal proofreading depends on the repair mechanism.
Keywords: text entry; backspace run; delayed error detection; inspection interval; rollback; renewal reward; reliability engineering.
1. 引言
1.1 把一場退格災難變成研究問題
大多數人不會因為輸入一個錯字而懷疑鍵盤存在時間悖論;真正令人沮喪的是,在靈感最順暢的時候,一口氣把一句話寫到尾,才發現開頭的主詞有錯。如果修正方式剛好是把游標停在句末,連續刪除、回到錯字、再重新輸入,主觀上便產生一種反諷:打得越快,畫面消失得越快。只統計每秒可以敲出多少字,會把重打時間與校對時間留在分母以外;只看最後一份正確文章,又會把曾經出現過的錯字與退格操作從資料裏抹掉。本研究關心的正是這兩種度量的不一致。
在正式人機互動研究中,文字輸入並非單純的手指擊鍵速度。Card、Moran 與 Newell(1980)的擊鍵層級模型將互動動作分拆為可估計的操作步驟,Salthouse(1986)討論轉錄打字涉及感知、認知、轉換及動作的不同成分。兩者支持「打字任務包含多種時間成本」這種建模方向,但不會自動給出任何特定鍵盤上的錯誤概率。本文另外引入一個極簡化的編輯工作流程:把文字分成固定大小的區塊,每段寫完才仔細校對,若發現錯字,則從段內最早的錯字刪到末尾,再作可靠重建。這不是建議使用者應該如此低效率地改字,而是一個可精確求解的反例製造器。
研究題目的幽默在於,退格鍵既代表錯誤修復,又代表早前投入的輸入工作遭到撤銷。要理解這件事,需要分清至少三個量:原始輸入速度、錯字發生過程,以及錯字被發現之後的編輯策略。即使兩人打字時的錯字率完全相同,採用即時修正的一方可能每次只退一格,採用長段落校對的一方卻可能一次刪掉五十格;原因來自發現延遲和修復政策,而不是錯字本身具有神奇的連鎖效應。同樣地,打字更快是否必然導致更多錯誤,本研究並不假定為普世心理定律,只在指定的假設速度曲線下作條件比較。
1.2 研究範圍與可接受的結論
本文的基本實驗單位不是人,而是人工參數下的區塊。每個區塊有確定的目標字數;發生錯字的機率由程式的亂數產生器決定;校對是否發現錯字由另一個指定機率控制。從來沒有真人被招募、被拍攝或被要求按退格鍵。本研究不能計算人群中尷尬事件的盛行率,不能比較某種鍵盤品牌是否較差,更不能指稱某些人「太急躁」才會改錯。研究的有效性限於公式、假設的內部一致性與程式是否能重現結果。
本文把「長退格」嚴格定義為同一次校對引發的連續後綴回退長度,與真正輸入法的 Backspace 實體按鍵紀錄並不等同。有些編輯器可利用游標移動、選取、Ctrl+Z 或自動改錯代替逐字退格;有些人只修改錯字而不刪除整段。本文的連續退格只描述一種最直接、最容易量化的操作政策。如果使用者用滑鼠直接選中錯字,回退機制便不適用;如果改正一個錯字後重打仍會再錯,也需使用額外的修復循環。這些限制會在後文作實質分析,而不是把模型寫成實測結論。
1.3 論文的貢獻及論述安排
研究首先以輸入串流的概念說明為何最終文字的零錯誤率不能保證沒有修正成本,再建立獨立伯努利錯字模型,推導首次錯字位置和回退長度的封閉式期望;接著把檢查頻率納入時間成本函數,對整數 做精確搜尋,並比較小錯誤率近似。第二部分用合成數值研究打字速度、校對能力與群聚錯誤如何改變結果,讓直觀的「越快越糟」接受模型本身的反證檢驗。最後討論何種資料才能把模型轉化為可驗證的人機互動假說,以及在哪些情況下使用者不應按本文的最優檢查間隔行事。
2. 文獻回顧
2.1 文字輸入績效不能只用最後一份文本衡量
MacKenzie 與 Soukoreff(2002)綜述行動文字輸入的模型、方法和評估問題,特別涉及速度與準確率的取捨。這段學術背景重要,因為研究者若只看某位使用者最後成功提交的文字,可能認為他達到百分百準確率;然而在輸入過程中,該使用者可能刪除、重新輸入並花了相當時間。Soukoreff 與 MacKenzie(2003)提出結合呈現文本、鍵擊串流及完成文本的統一錯誤度量觀點,說明最小字串距離與每字鍵擊次數分別有不同缺陷。本文採用這個區分:結果文本的潔淨字數是一個產出,回退長度是另一個編輯負擔,時間成本又是第三個量,三者必須同時報告。
Wobbrock 與 Myers(2006)針對容許使用者自由更正錯誤的輸入任務,提出從完整輸入串流作字符級錯誤分析的算法與指標。該研究的核心提醒是,刪除過的輸入仍對體驗及績效有意義。本文的回退過程刻意保留「曾輸入、後刪除」的長度,因此不會由最終文本與目標文本相同就推斷沒有錯誤。但是本文沒有採用 Wobbrock 與 Myers 的完整字串對齊演算法,也沒有沿用其實驗資料;我們處理的是嚴格二元的正誤字標記,並將修復政策固定為單次後綴重建。
2.2 打字認知與修正成本的拆解
Salthouse(1986)對熟練轉錄打字的討論顯示,輸入過程可以分成理解原文、字符分解、動作轉換與動作執行,因而不能簡單用一個常數「每鍵耗時」概括全部任務。卡住後重新看前文、尋找錯字、選取內容及決定如何改正,可能牽涉不同認知活動。本文不試圖量度這些活動,而是用固定的校對時間 和固定的修復啟動時間 作為已明言的近似。正因為這些成本可以變動,本文亦不聲稱三秒檢查或 0.8 秒思考是人類的典型值。參數若日後從鍵盤紀錄和認知研究取得,模型才有機會估計個體差異。
Card 等(1980)提出的操作層級分析,可以協助研究者避免把擊鍵、等待回應和心理準備合成一個缺乏解釋的速度值。本文的時間拆分為原始輸入、定期檢查、啟動修復及後綴重建四項,各有不同可觀測的代理量。但這種分解亦帶來風險:真正的使用者可能一邊打字一邊視覺監控,同時完成部分檢查;那些時間不一定可以簡單相加。本文刻意採用依序且互斥的操作,以得到透明的上層決策模型,不應被解讀為人腦多任務處理已被證實是序列的。
2.3 從電腦檢查點借來的數學,不能偷換成實驗
Young(1974)研究電腦作業失敗時的最佳存檔間隔;Daly(2006)進一步探討重啟與儲存負擔下的較高階最佳間隔近似。其一般結構可以寫成「檢查太勤會增加固定支出,檢查太疏又會增加失敗後重做的工作」,與打字分段校對有可用的數學類比。不同之處是電腦故障一般描述整個作業遭到中斷,而錯字只有在某種編輯政策下才要求大量刪除;電腦存檔可以儲存無錯狀態,文章校對卻可能漏字。本文自行推導首次錯字後綴修正的分布,沒有直接把電腦故障的最佳間隔公式當成打字研究的實證結果。
在低錯誤率和小區塊極限,本文將得到類似平方根律的近似形式;不過此式來自本文的具體成本設定及錯字機制,係數與電腦檢查點研究並不相同。在較高錯誤率時,兩者的差異尤其重要:後綴重做長度最多只有 ,不能無限制地按多個錯字次數累加。因此簡單以「平均錯誤數乘平均後綴長度」代替精確式會高估成本,也會在區塊很長時產生錯誤的極端預測。採用真正的首次錯字分布,正是本文對此玩具問題的主要解析工作。
2.4 尚未解決的聯繫
已有文獻分別提供文字輸入的評估方法、人類打字處理的構成要素,以及故障修復的最優檢查頻率框架;本文提出的連結是一個限定且自足的問題:在固定的後綴重建規則中,哪一個錯字決定退格長度,如何從其分布算出最合理的定期檢查頻率?本研究的目的並非聲稱發現人類從未研究過退格鍵,而是建立一個容許精確推導、可逐項修改成本與錯誤過程、能由讀者獨立推翻其不合理假設的最小模型。即使現實的合理政策通常是移動游標局部修正,這個極端模型仍能清晰展示發現時間與實際錯誤總數是不同機制。
3. 問題與假設
3.1 可檢驗的研究問題
第一個研究問題 RQ1:在一個長度為 的區塊內,只要最早的錯字要求全後綴重建,連續退格長度 的精確概率分布與期望是多少?這個問題具有封閉式數學答案,並容許用電腦模擬核對。第二個研究問題 RQ2:校對有固定時間支出、修復需要啟動成本,而且退格長度會影響重建成本時,最佳檢查間隔是否位於「逐字校對」和「永不校對」之間?如存在,如何以整數搜尋確定其位置?第三個問題 RQ3:假設較快原始輸入使每字錯誤率增高,固定區塊和自適應區塊的長退格事件是否增加同樣多?第四個問題 RQ4:如果檢查會漏字,或錯字呈群聚而非獨立,結論哪些部分不變,哪些部分需要重新推導?
3.2 四組條件式命題
H1 是一個解析命題:對固定 ,獨立錯字率上升時,至少需要回退 字的概率不會下降,條件是 。H2 是最適化命題:對某些合理的正成本和中等錯誤率設定,區塊檢查存在有限的離散最小時間成本。H3 是可能被反例推翻的直覺:較快輸入時,最佳校對間隔必定變短;本文故意不預先相信這個說法,而讓完整數值掃描判斷。H4 是測量及可靠度命題:未被檢出的錯字會令最終正確率與可見修復次數脫鉤;即使表面上退格較少,也可能是校對不夠可靠。
本研究不作真人統計假設檢定,也不報告由模擬「證明」人類行為的 p 值。H1 和部分 H4 可以以數學形式證明;H2 和 H3 在明示成本及掃描範圍內成立或不成立,不能被外推至所有人的打字方式。表述上,這些是假設模型內的可驗算命題,不等同一般人群的實證假說已獲支持。
4. 理論框架
4.1 從鍵盤輸入到可接受產出
假設編輯目標是一段確定字數的正確文本。操作者按順序輸入 個字符後暫停進行一次檢查,並在檢查完成前不進行其他修正。輸入過程中的字符有兩個抽象狀態:本次輸入正確,或本次輸入含錯。錯字可能包括替代字符、遺漏及插入,但為維持字數一致,主模型暫以一個位置上的二元失誤代表,不處理輸入法候選詞帶來的多字對齊差異。一旦檢查找出至少一處錯字,整段內位置最前的已發現錯字至段尾的內容全部被刪除,然後重輸該後綴。
在基本情境中,重輸是可靠的:修復後內容立即正確,且不再產生第二輪錯字;修復耗時以每回退一個字符 秒計。此假設顯然較真實電腦操作理想化,目的在於把首次錯字、後綴長度與檢查成本單獨識別。由於每個區塊最後都交付 個正確字符,在獨立同分布區塊之間,單位成品的長期期望時間可以用單區塊期望時間除以 ,不需要捏造真實使用者或假設常態分布的輸入速度。
4.2 把「快」拆成物理與品質兩條軸
記 為初次輸入時的原始速度,單位是每秒字符;若沒有錯誤及校對,輸入 字需要 秒。記 為初次輸入中每一字錯誤的邊際概率;前兩個變數並非必然相關,而是需要另外設定函數才可以把速度與錯誤連接。主要人工情境使用 ,只在本文列明的速度範圍內評估,最大值限制在 0.3 以下。這是方便考察敏感度的任意平方律,沒有任何文獻被用來宣稱它是人類固有的速度—準確率定律。
記 為每次區塊校對時間, 為至少找到一處錯字時的修復啟動時間, 為每個須回退且重建字符的等效時間。假設校對與輸入及重建沒有重疊;回退每字成本相同;在不同區塊之間沒有學習及疲勞;每次校對的成本與區塊長度無關。後一項尤其理想化,因為校對較長段落通常需要更多閱讀時間。若 實際上與 成正比,最適解可能大幅改變;因此模型輸出必須與假設一併報告。
4.3 可見退格不等於錯誤事件數
設 是區塊中發生的錯字數,而 是為了修復而刪掉的後綴字數。當 時 ;當 時,即使只錯一個字, 也可能接近 。反過來說,雖然 可能超過一個,但全段只需要一次從最早錯字開始的回退,所以 不應逐字錯誤累加。這一區分令退格長度的分布依賴第一處錯字,而不是只依賴錯誤總數的期望。所謂「一次刪掉半段」的尷尬,其實是檢查機制將早期的單個失誤轉化成較長的重新工作量。
檢查機制還涉及可見性。若文字本身有錯但使用者未檢出,畫面上可能沒有退格,然而完成文本仍然不合格。若一個評估只報告使用者平均按了多少次退格,漏檢越嚴重的系統甚至可能得到看似更好的數字。本文因而同時測量修復概率、退格長度、潔淨字符平均時間及漏檢錯字期望,防止把省下操作錯解為可靠度提升。
5. 研究方法
5.1 人工參數與可重現設計
主基準設定:原始速度 字/秒,單字符獨立錯誤率 ,每次區塊校對 秒,發現錯誤時的固定啟動成本 秒,每個後綴字符的回退及可靠重建成本 秒。所有數值是作者設計的測試條件,絕不是調查所得的人類平均數。因為四項成本的時間單位一致,期望時間與成品每字速度可以直接換算;研究將所有數值寫入固定參數的 Python 腳本,避免在不同圖表中暗中更換假設。
主實驗的檢查間隔 是正整數,最初搜尋一至四百字。對同一個 ,先用封閉式計算檢查成本與後綴重建成本,再用蒙地卡羅產生九萬個獨立區塊,以樣本平均與精確值比較。每個區塊的錯字位置由獨立均勻亂數與指定錯誤率比較得到;當至少一處被檢出時,取最小索引,計算從該位置至段尾的長度。整個模擬使用固定種子 2026101513,保存資料及數值摘要,九萬並非真實人的數目,而是合成區塊的重複次數。
5.2 實驗對比與穩健性試驗
首先繪出不同輸入速度下,每潔淨字平均時間對 的曲線,觀察固定成本與修復成本是否互相平衡。其次掃描每秒三至十一字的速度網格,每個速度都重新選擇其指定搜尋上限內的最佳 ,再與固定六十字校對一次的政策比較。第三,保留六十字的相同檢查間隔,計算不同速度下至少退格 字的精確尾部概率;這一步可獨立檢驗 H1,毋須引入人類心理資料。
為檢查現實中常見的例外,研究加入兩組替代機制:其一,每個初次輸入錯字只以機率 在校對時被發現;其二,錯誤指標形成具有固定轉移概率的二狀態馬可夫鏈,容許連續錯字群聚。每組替代機制都另行推導其所需分布,不會把獨立錯誤公式照抄到不適用的情況。圖一至圖五分別展示成本曲線、有效速度、退格尾部分布、成本地形及相關錯誤的敏感度;所有圖都從可追溯的程式參數直接產生。
5.3 分析與模擬的不同證據功能
精確式決定在給定假設下的理論結果;合成模擬的功能,是發現推導、程式索引或實作上的不一致。即使九萬次合成結果與解析值很接近,也不能支持其參數適合香港大學生、上班族或某款手機輸入法。蒙地卡羅標準誤只衡量偽隨機生成的數值波動;若校對成本或錯誤率在真實世界具有異質性,這些不確定性需要另一套資料估計。為免混淆,本文每次稱「平均」「比例」時,均標明是理論期望還是合成樣本統計。
為確保可重現,腳本使用 Python、NumPy 與 Matplotlib,不讀取任何私有鍵盤紀錄;結果 JSON 儲存所有成本、模擬次數及種子。程式中的斷言將多個模擬均值與理論預測比較,超出指定的數值容差會停止執行。這個自動檢查只是計算可靠性的一道閘門;後續仍需要圖表及 PDF 的排版目視檢查,以及由不同審查角色提出模型適用性的反對意見。
6. 數學與計算模型
6.1 最早錯字的分布
令 表示初次輸入第 個字符出錯, 表示正確。在獨立模型中,, 互相獨立。記 為首次錯字的索引;若沒有錯字,令 。對 ,首次錯字出現在 必須在前面 個位置全部正確,並在第 個位置失敗;後方如何出錯並不影響首次索引。因此有
同理,整個區塊沒有錯誤的概率為 ,故至少要修正一次的概率是
在確實發現錯誤且由最早錯字開始回退的規則下,若 ,需回退 個字符;若 ,則 。注意 的定義包括出錯的字符本身,而非只計錯字後方的字符。這個端點定義令 時 ,是容易檢查的基本測試,亦能避免刪除長度常見的差一錯誤。
6.2 退格長度的精確尾部
對任意整數 ,事件 等價於「第 至第 個字符中至少存在一個錯字」。因為只要最早錯字位於此前綴,後綴回退便至少有 字;前綴若完全正確,再後方的錯字最多只能退少於 字。直接取補集得到精確尾部式:
由離散非負隨機變數的尾部求和恒等式 ,把求和索引改為前綴長度 ,即可得到
此式在 適用。當 逐步趨近零時,以級數展開可驗證 ,與「低錯誤概率時,一個錯字出現在各位置的機會近似相同」的直觀一致。在電腦計算中,極小 時直接作大數相減可能失去有效位數;腳本使用對數與 expm1 類數值函數提高穩定性,但並不宣稱任意浮點極限皆可精確處理。
這個分布給出一個很實用但容易誤解的結果:固定 和 ,尾部機率對 的導數等於 ,在正確的參數範圍內非負。故在其他條件完全相同時,錯字率提高不會令某個退格長度以上的事件變少。命題只關於指定修復規則;若實際使用者在打得較快時改為局部選取錯字,該結果未必適用,更不能把「錯字率上升」本身當作已經觀測到的事實。
6.3 每潔淨字符的期望時間
對每個區塊,初次輸入時間恰為 ,檢查時間恰為 。只要錯誤存在,修復會額外需要固定 ,並按回退字符數付出 。因此單區塊的隨機總耗時可寫成
取期望並除以最終交付的正確字數 ,得到本文主要目標函數
單位是每個正確成品字符所需的秒數,而不是每次原始鍵擊的秒數。若任務包含很多長度相同且互不依賴的區塊,從大數法則或更新報酬的觀點,總時間除以交付文字長度會趨近 。本文將有效輸出速度定義為 ;它既包含校對,又包含後綴重做,所以一般低於原始輸入速度 。由於修復在模型內必然成功,最終交付字符確實是潔淨的;若放寬校對可靠度,這個命名必須更嚴格地附加品質條件。
6.4 最佳整數間隔與小錯誤率近似
真正的檢查點長度不能是 68.37 個字符,因此最佳決策應在正整數集合上求 ,而不是僅求連續導數的根。程式在明示的一至四百字範圍枚舉所有候選值,再回報最小者及其成本;如最優解位於上邊界,會特別標示該結論只對此有限搜尋範圍成立,不把它稱為無限制全域最佳。離散枚舉的優勢是透明:任何讀者均可取相同 逐格重算。
若 足夠小,、,則
其中與 關係最強的兩項是 和 。將 暫視為正實數、忽略與 無關的項並令導數為零,可得到近似檢查間隔
此式與電腦檢查點文獻中的平方根型平衡有家族相似性,但本研究的 代表刪除與重建後綴的成本,不是機器存檔與重啟的實測值。最重要的是,上式只在區塊很少出現多個錯字時近似可靠;當 不再很小,後綴最多只能刪掉整段一次,近似式可能顯著高估成本或給出錯誤的最佳位置。
6.5 長區塊極限與模型邊界
當 趨近無限大,若 固定,至少有一個錯字的概率趨近一,首次錯字通常相對靠近區塊開頭。因此 趨近一, 會趨近 。這個結論非常值得警惕:在本文假設「只需一次、且完全可靠地重建後綴」的成本制度下,極長的段落可以把固定檢查成本平均化,最後等價於幾乎整段重打一次。當原始速度極高時,模型甚至可能偏好近乎整段重建,而非頻繁修補。數學並沒有出錯;出錯的是把這種理想化的修復機制當作真實人類無成本的能力。
因此,本研究不預先斷言「最佳間隔一定隨錯誤率下降」,也不聲稱提高打字速度必然令有效速度跌落。真實的重新輸入可能繼續出錯,長文檢查時間會變長,或單次超長退格會引起不可接受的風險。那些延伸約束可以重新帶回有限的最適區間。本論文把模型的這個反常極限當作一個批判性檢查點:凡是看見漂亮的最佳化數字,都先問數字背後是否假定了過分完美的補救操作。
6.6 校對不完整時的可見修復與隱藏錯字
完全發現所有錯字的假設在真實文字工作中經常過分理想。為把「沒有退格」與「沒有錯誤」分開,設每個初次錯字各自以概率 被檢出,而且檢出事件與其他位置獨立。在這個限定情境下,「被發現的錯字」本身是概率 的獨立伯努利事件;相應的首次已發現錯字位置與回退長度,可以將前述精確公式中的 換成 。但是換元只適用於可見修復成本,並不代表所有未被檢出的錯字都神奇地消失。
考慮第 個位置存在一個沒有被檢出的原始錯字。如果在第 個位置之前有任何其他錯字被檢出,修復政策會從那個較早位置開始重建,於是原本第 字也會被順道覆蓋。相反,如果第 字之前並無已發現錯字,則其錯字將保留;即使後方發現錯字,後綴重建也不會觸碰更早的第 字。對此事件逐項相乘,可得「第 字仍有未修正錯誤」的機率為 。以線性期望求和,整個區塊剩餘錯字的平均數是
當 時此式適用; 趨向零的極限為 ,而 時剩餘字數為零。每個交付字的預期殘留錯字比例為 。這個量與前面可見退格的概率並非同一分母,也不等於「一整段內容完全正確」的概率。本文在 的圖表與結果中,只把時間量稱為每個提交字符的耗時,除非另行加上品質門檻,否則不能稱為每個正確字符耗時。
此推導揭示一個非平凡的編輯取捨:降低檢出率可使畫面上的退格動作變少,並令計算得出的提交速度提高,但其中可能留下錯誤。若編輯系統只以每分鐘提交字數獎勵使用者,模型甚至可能偏好完全不檢查,因為未修正的內容會被當成同等產出。合理的品質管理必須另加如 的限制,或令殘留錯字承受可量化的懲罰。這裏沒有為錯字隨意指定港幣價值,因為日常閒聊、合約、臨床紀錄或程式碼中的一個錯字,後果可以相差極大。
6.7 錯字群聚的平穩二狀態馬可夫模型
獨立錯字假設對真實輸入有明顯不足:一次鍵位偏移、輸入法候選詞選擇錯誤、雙手放錯位置,都可能令後面多個字連續出錯。為了不把這些現象錯寫成已觀測到的人類分布,本文只引入抽象的兩狀態馬可夫鏈。設 ,以及 。強制每個位置的平穩邊際錯字概率仍是 ,便必須滿足 ,即
程式只採用令 的參數。每個合成區塊的第一個狀態由平穩分布抽出,其後按上述轉移規則產生。當 ,前後狀態獨立;當 ,若本字錯誤,下字也錯的條件概率高於邊際錯誤率,即形成群聚。但是這個數學群聚未必等同實際的輸入法錯詞串,因為本文沒有處理同一候選詞一次轉換多個漢字的事件結構。
馬可夫鏈下,一段長 的前綴完全沒有錯誤,必須起始時為正確狀態,且往後每一步都維持正確。故概率不是 ,而是 。將此式放入後綴尾部與尾部求和,可得到
以及
此處的 是在所有錯字均可被發現時的後綴長度。期望時間仍由同一成本式計算,但修復概率要換成 。這組公式可以還原獨立模型,是必要的代數交叉檢查。至於群聚究竟會增加或減少期望退格長度,須在固定的邊際錯誤率下連同轉移條件一起比較;單純說「連續錯字比較多,所以退格一定比較多」是不正確的,因為群聚同時改變了完全沒有錯字的區塊比例。
6.8 誤差控制、可辨識性與模型檢查
本研究有兩種不同的「誤差」。其一是文本內的錯字,屬模型中的隨機機制;其二是用九萬合成區塊估計解析期望時的蒙地卡羅誤差,屬有限數值抽樣。程式為每個獨立情境計算樣本時間平均的標準誤,並以多倍標準誤的容差檢查解析值。兩者都不應與參數估計誤差混淆:如果真實打字者的 不明,就算把模擬增加至十億次,也不能令 自動成為現實。
另外,單憑最終字數與總耗時,未必能唯一辨識 、 和 。例如較長校對時間與較高修復成本可能給出相似的平均時間,但它們對最優 的敏感度不同。要在真實資料中分辨它們,需要同時記錄校對開始、結束時刻,錯字的原始位置,修復啟動延遲,以及後綴重建的實際動作。若只觀察到最後一段文字,連錯字是否曾存在也無從得知。這項不可識別性說明,模型可以被數學求解,並不意味所有參數都可以被一般鍵擊資料直接識別。
7. 研究結果
7.1 有限校對間隔中的成本谷底
在基準人工設定 、、、、 下,逐一枚舉一至四百字的整數校對間隔,得到最低期望耗時位於 ,每提交一個正確字符需 0.3200465866 秒,換算每秒約 3.124545 個正確字符。對照未計檢查與修正的原始速度每秒五字,實際成品吞吐因額外工作而明顯較低。這個差距是人工假設下的成本帳本結果,不能被解讀為現實打字者平均會流失多少百分比的效率。
若改為每二十字檢查,理論每字耗時為 0.386264 秒;每四十字檢查降至 0.330012 秒;六十字時為 0.320499 秒;最佳六十八字時為 0.320047 秒;到每一百字檢查則回升至 0.324111 秒,每二百字檢查上升至 0.342582 秒。短區塊的主要問題是三秒校對成本過於頻繁;長區塊的主要問題則是早期錯字一旦被發現,須回退相當長的後綴。有限最優由兩種支出相互牽制造成,而非由任何神秘的六十八字生理節奏決定。
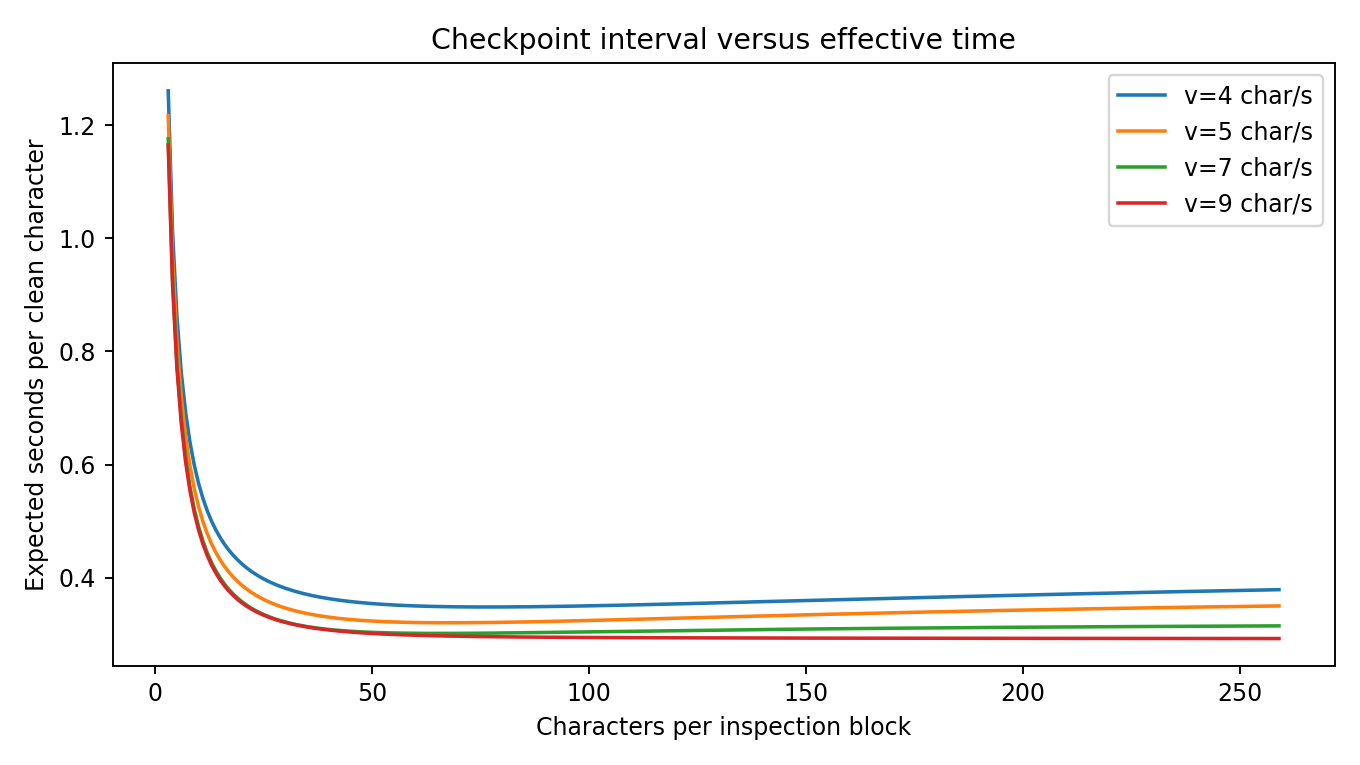
圖 1. 橫軸是每次校對前的輸入字符數,縱軸是理論每正確字符秒數。不同曲線以相同檢查、修復成本配合人工平方錯誤率 計算。圖中最小值反映有限的檢查成本與後綴重做成本的平衡;來源為 analysis.py 精確式,非真人測量。
在 時,單區塊至少須修復一次的精確概率為 0.6421808,無條件期望回退 25.8301 字。這兩個數字不能混為一談:大約三成五的區塊完全不需修復,於是把所有區塊放在一起計算的平均回退長度會小於「發現錯誤後」的條件平均。九萬個獨立合成區塊得到每字耗時 0.31997479 秒,其模擬標準誤約 0.00023227 秒;平均回退 25.8042 字,需要修復的比例為 0.641922。上述差異屬模擬抽樣誤差的正常量級,未揭示精確式與程式實作有系統性矛盾。
7.2 原始速度與最終完成速度並非同一條曲線
固定每六十字檢查時,在本文指定的速度平方律下,每秒四字的人工錯字率是 0.0096,每秒五字是 0.015,每秒六字是 0.0216,每秒八字是 0.0384,每秒九字則是 0.0486。這組數值本身就不能作為人類速率統計,因為它只是由一個事前選定的函數代入速度而得。它的用途是控制相同修復政策下,輸入速度與錯字風險兩個因素如何共同進入時間成本。
在固定六十字的策略下,每秒五字的期望每字耗時為 0.320499 秒,升至每秒八字後是 0.299105 秒。原始速度增加了,平均回退長度也由 20.850 字 增至 37.348 字;結果卻沒有出現總耗時必然升高。原因是更快完成原始輸入的時間收益,在本參數範圍內仍超過增加的平均修復成本。這一結果否定了最簡單的危言聳聽式說法:「打快必然降低最終產出」。模型可以證明長退格更常見,卻不能在沒有比較全部成本前自動判定產出更低。
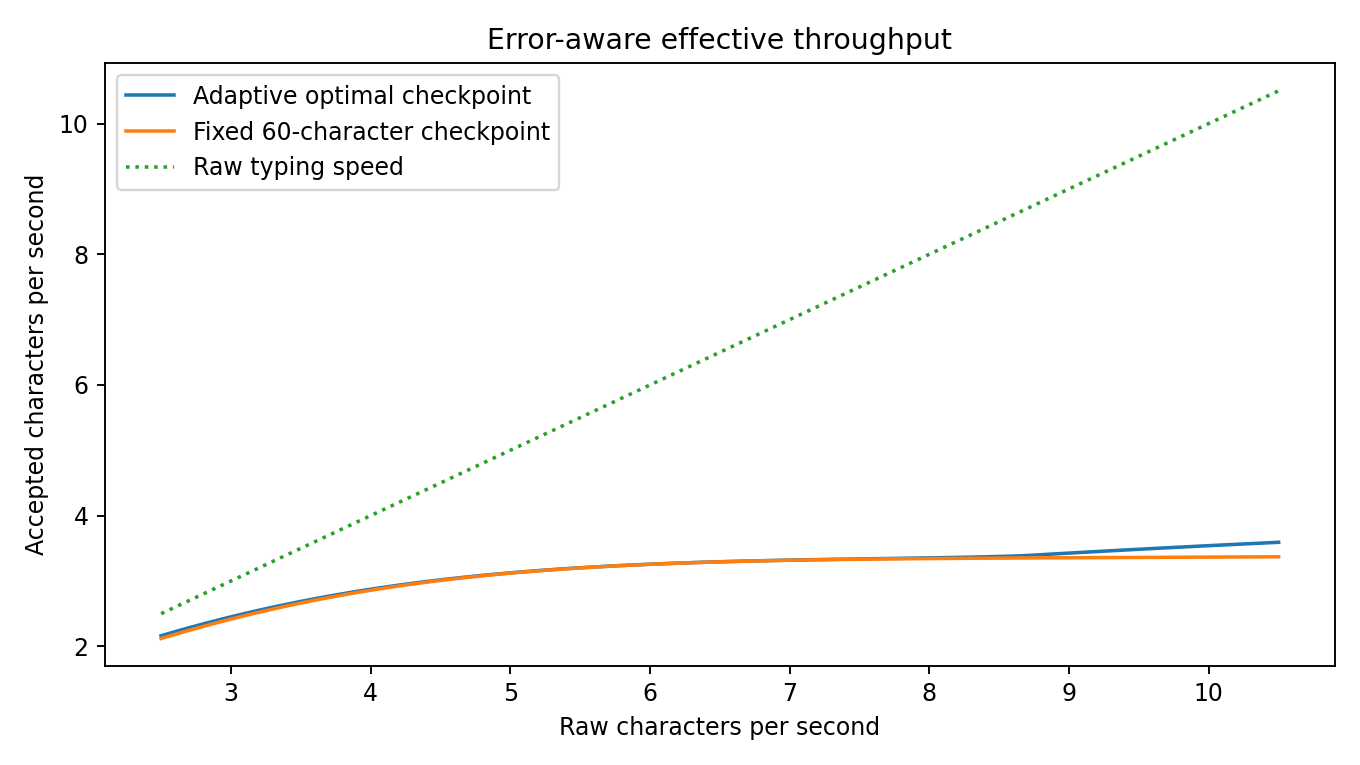
圖 2. 橫軸為假設的原始輸入速度,縱軸為理論每秒提交的正確字符。點線代表沒有任何校對或修復時的原始速度,兩條成本曲線分別代表固定六十字與每個速度重新枚舉一至四百字候選校對間隔的方案。自適應曲線是此有限整數網格內的最小時間成本,不代表在無界速度及無界間隔下存在全域最優。
最佳間隔本身顯示更微妙的反常現象:速度每秒四、五、六、七、八字時,在一至四百的網格內,最佳間隔依次為 76、68、64、66、78 字。由四字加速至六字,錯字率升高,檢查宜更頻密;但再加速時,最佳間隔竟重新拉長。至每秒九字,最佳點碰到程式搜尋上限四百字,這表示該人工條件下的成本極限效應開始支配演算,不能宣稱「四百字就是人類最佳習慣」。因此 H3「越快就永遠越頻繁校對」在這個完整模型內被反例推翻。
7.3 長退格尾部如何隨速度上升
若固定 ,每秒五字時至少包含一個錯字的概率為 0.596193,每秒八字時則達 0.904574。相同區塊內,回退至少 字的機率直接由 給出;對每一個從一至六十的合法門檻,當 由 0.015 升至 0.0384,該概率均會上升或保持極端端點的數學限制。這是 H1 在固定編輯政策下的解析支持,不依賴模擬或統計顯著性檢定。
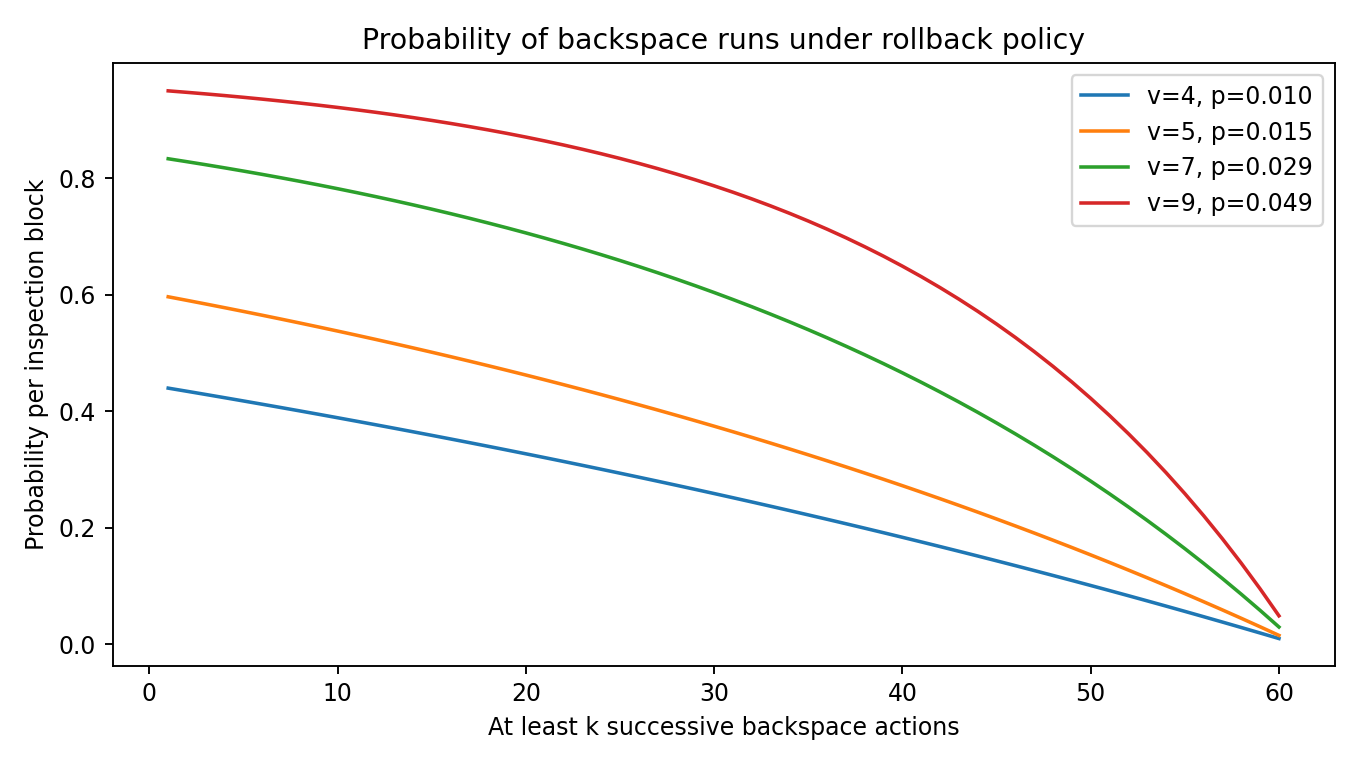
圖 3. 橫軸是回退至少 字的門檻,縱軸是單區塊出現該事件的精確概率。四條速度曲線只改變人工指定的字符錯誤率,校對間隔及修復政策完全相同。圖形展示「一次發現錯字,就可能連續退格很長」的分布機制;不應將概率稱為社會調查所得的受訪者比例。
以速度五字、六十字校對一次作例子,精確無條件回退期望是 20.84999 字,九萬個合成區塊得到 20.92299 字;當中真正需要修正的區塊,其條件平均回退為 35.08476 字。若只在實際出現退格時才回憶這件事,使用者觀察到的可能更接近後者,而不是包括大量零回退段落後的平均。這種條件化差異可以協助解釋主觀上覺得「每次一按退格就刪很多」的印象,但本文並沒有收集記憶偏誤資料,所以只能提出未來可測量的推論,不能宣稱已證實認知偏差。
7.4 最佳解附近與整個成本地形
單看圖一容易錯覺所有速度都只有一個平滑的校對間隔最低點。圖四以速度與校對間隔構成的平面展示,每個點有自己的每字耗時;高錯字率、長區塊附近的顏色如何變化,取決於「最多只需要一次後綴重建」這項設定。白色虛線沿不同速度尋找在圖示間隔範圍內的成本最低點,可觀察到先向短區塊移動,之後轉向長區塊的結構。
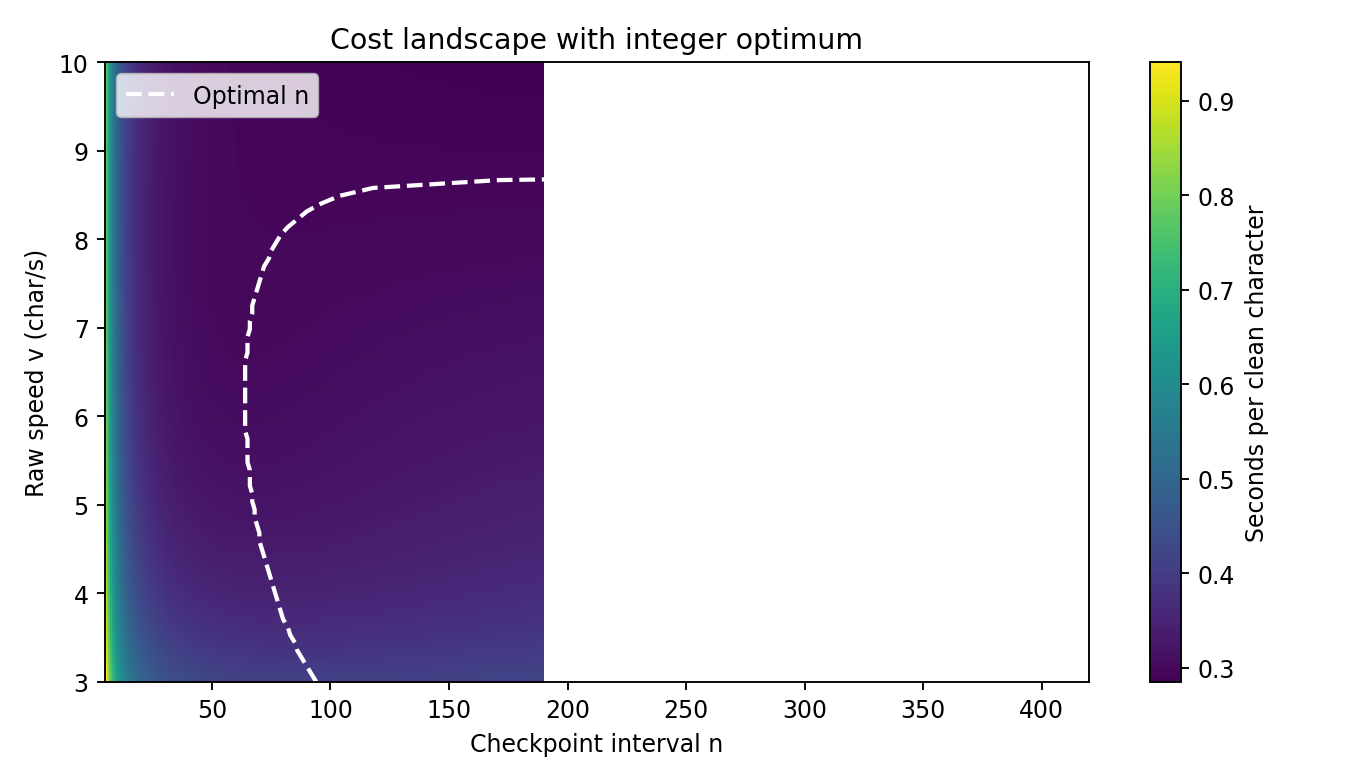
圖 4. 橫軸是每段字符數,縱軸是原始速度,色階代表每提交一個正確字符的理論耗時。虛線標示在程式一至四百字搜尋中的最優 ,因此部分位置可能超出本圖顯示的一百九十字範圍;圖像應只用於理解成本形狀,不宜以曲線畫面邊界推斷搜尋的限制。
這個形狀也說明只用平方根近似存在風險。基準 時,小錯誤率近似給出 字,但真正完整式的最佳值是 68 字,相差超過二十字。為甚麼會有差距?因為 68 字對應的預期初次錯字數已超過一個,而精確政策把多個錯字合併到從最早錯字的一次修復;把每個錯字都當成獨立需要整段退格,必然過度懲罰較長段落。這個例子提醒我們,使用近似公式之前要檢查其成立條件,而不是因為式子含平方根就覺得更精確。
7.5 漏檢讓工作看似更快,卻可能變得不可靠
令原始速度維持每秒五字,校對間隔維持六十字。若每個錯字的檢出率由完全可靠的 降至人工假設的 ,精確模型中至少發現一個錯字並啟動修復的概率由 0.596193 降至 0.557590,無條件平均回退由 20.850 降至 19.255 字。每提交一字的平均耗時也從 0.320499 秒縮短至 0.315199 秒。若有人只展示輸入速度及退格次數,就可能把這種操作縮減誤認為工作品質更好。
實際上,該假設下每個提交字符的預期殘留錯字比例是 0.00103257,即平均每一千個提交字符約留下一個錯字;這個比例的解釋仍然完全限於人工模型。九萬區塊模擬得到每字符時間 0.315229 秒、殘留錯字比例 0.00100537,與公式相符。這項結果不表示九成檢出率對任何工作都足夠;一千字一錯在聊天、程式碼、病歷或密碼輸入中的後果並不等價。
7.6 群聚錯字反而可能減少含錯區塊數
在固定邊際錯字率 、長度六十字下,完全獨立情況的每區塊修復概率是 0.596193,平均回退 20.850 字。若令錯字的自我持續概率 ,並調整 以保持相同的邊際錯字率,修復概率降為 0.499851,平均回退降為 17.0485 字;九萬個馬可夫合成區塊得到修復概率 0.499089、平均回退 17.0878 字。群聚不是讓錯字消失,而是將它們集中到較少的一部分區塊,因此在「有錯便從最早錯字回退一次」的成本制度下,竟可能節省啟動與回退操作。
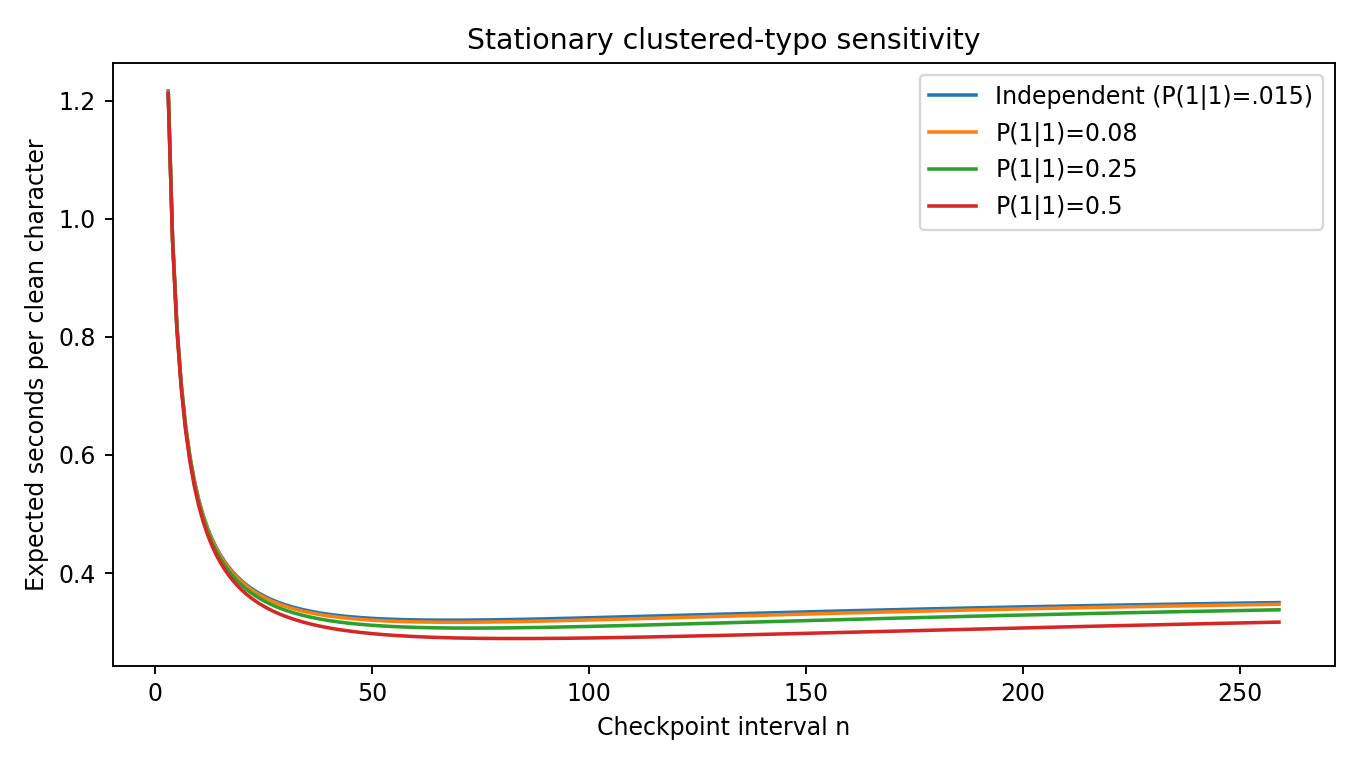
圖 5. 橫軸為區塊長度,縱軸為理論每正確字秒數;不同曲線代表獨立錯字及數種 的馬可夫情境。每條曲線保留相同的錯字邊際概率 0.015,差異只來自錯字的時間依賴結構;圖示不能用來判斷真人打字一定具有某一轉移概率。
把四種模型各自在一至四百字內重新最佳化,獨立情境最佳為 68 字、每字 0.32005 秒;當 時最佳為 69 字、每字 0.31657 秒;當 時最佳為 73 字、每字 0.30662 秒;當 時最佳為 83 字、每字 0.28892 秒。這些數字看起來像是在鼓勵錯字成串,其實不應如此理解:人工政策把多個相鄰錯字視為同一輪修復,並假定重新輸入完全可靠,而現實的一連串輸入法錯字可能擴散成語意問題或多輪修訂。這項計算能顯示依賴結構不可忽略,不能用來鼓勵製造更多錯誤。
8. 討論
8.1 為何一個錯字能製造多個退格動作
在日常語言中,「打錯一字」和「刪掉三十字」似乎是兩個大小不合比例的事件。本文指出,它們之間缺少的變數是錯字的發現位置及修改政策。先前發生的失誤如果要到區塊尾才被找出,後面原本正確的字符也可能因為回退規則而被刪除。回退長度因此不是當期失誤數的簡單倍數,而是編輯者如何追溯早前操作的結果。相同概率模型可以用來討論填寫表格後才發現第一格資料錯誤,或編程後才發現最先前的錯誤設定;但這些類比只成立於同樣需要重做後續工作的流程。
從系統工程角度,最早錯字是決定最大重做範圍的故障位置,定期校對則是限制故障影響範圍的一種檢查點。校對太勤會增加不斷停下來的固定成本,校對太疏則會令早期一個細小錯誤影響更多後續工作。這個權衡在硬件定期維修、程式分階段驗證、文書資料檢核和學習中的錯誤回饋都具有形式上的共同點。然而不同領域的故障可能有自動恢復、持續傳播或與時間成比例的檢查成本,不能直接將本文的六十八字代入其他工作單位。
8.2 「只看結果」與「只看操作」各有陷阱
如果作者最後交出一篇完全沒有錯字的短文,最終文字的字串距離或許是零,但過程可能包含大量刪除;如果作者完全不校對,打字串流可能很乾淨、退格次數很低,卻在文本中留下錯誤。Soukoreff 與 MacKenzie(2003)及 Wobbrock 與 Myers(2006)的評估觀點提醒,研究者需要區分完成文本、輸入過程及修正操作。本文將三者對應到接受字符數、錯字機制與回退長度,使任何單一指標都無法偷換成整體品質。
尤其在使用輸入法的中文環境中,一次錯誤選詞可能涉及兩個以上字符,還可能改變前後語境;輸入法也可能自動替換候選詞而無須 Backspace。本文把每個初次輸入位置抽象成獨立的二元字符錯誤,因此只適合研究方法示範,不足以量化不同中文輸入法。未來若蒐集真實逐鍵資料,必須保護私人文字內容,處理自動更正與游標跳躍,以及確定中文字符、英文字符和候選詞選擇如何對齊。未釐清這些問題之前,不應把本模型的每字數值稱為香港粵語打字績效。
8.3 最適化結果對管理規則的含義
一個看似合理的管理建議是要求員工每五十字檢查一次,防止錯誤累積。模型能在指定成本下計算各種間隔的優劣,但不能憑人工成本直接頒布工作指引。如果真正的校對需要逐字閱讀,校對成本可能是 ;若存在節奏切換損失,還可能對每次停筆有額外成本;如編輯器支援快速局部修正,修復成本便未必與後綴長度成正比。這些替代參數會令六十八字最適點移動,甚至使分段檢查的目的由提升時間效率轉為保障文件的錯誤上限。
因此,最值得保留的不是某個特定字數,而是決策流程:先確定能接受的錯誤品質,再估計各類工作時間成本,依據修復政策計算檢查間隔,最後用實際任務驗證。不論管理者是否採用自動檢查提示,都應區分「提示使人感覺安心」「提示令平均編輯時間縮短」和「提示令錯字減少」三個不同效果。只有真實隨機分派或適當控制下的觀察資料,才能支持這類因果結論。
8.4 不連續的最佳策略並非算錯
H3 的失敗讓這個研究題目變得比「錯得越多就要越勤檢查」更有啟發性:當錯誤密度較高時,多個錯字通常被一次後綴重建合併處理,單次校對能避免的邊際重做成本可能飽和。由於模型允許區塊末尾必定成功重建,極長的區塊會接近「全部先試打一次,之後再重打一次」的成本制度。若原始輸入非常快、重建成本又有上限,延長區塊有時成為數學上的有利策略。這件事在機械化高效率重算系統可能不是荒謬,在真人操作卻強烈依賴不真實的完美重打假設。
報告有限網格的最優值時應坦白標明上界,特別是當搜尋結果碰到 。數值最佳化程式總會回傳某個數字,但邊界上的數字不代表模型在無界空間存在同一個最佳點。倘若讀者忘記這點,便會把一個演算法的搜尋限制錯寫成人類行為律。相反,如果日後模型將校對時間與區塊長度關聯,或讓重新輸入帶有持續錯誤概率,長區塊政策可能被大幅懲罰;那時最優間隔的速度方向需要重新推導,而不是作小幅參數微調便自稱已解決。
8.5 退格長度的風險分布比平均數更可解釋
期望回退二十個字符不代表所有段落都退二十字。由式子可知有一批段落完全沒有退格,一批段落卻可能接近整段全退。對需要保留連續思路的工作,極長回退事件可能有超出時間的心理或資訊成本;例如人們未必記得剛才輸入的完整表述,重新輸入之後也可能改變語意。本文沒有量度這些影響,因此不把它們折算成任意的「心情損失值」。但就方法而言,監督者可以選擇限制 ,而非只減少 ,這會將決策變成有尾部風險限制的最佳化問題。
如果編輯任務具有高後果錯誤,還可以先指定最大的殘留錯字率,再在符合約束的方案中減少耗時。尤其當檢出率不是一時一刻就能提升時,縮短檢查段落與提升校對工具的敏感度可能是兩種可選方法;它們對可見退格與殘留錯字有不同作用。把品質當成一個獨立限制,可以避免「因為完全不檢查所以看起來零退格」的荒誕績效指標,亦更接近工程可靠度研究的思路。
9. 研究限制
9.1 人類行為、速度與錯字率均未被實測
本文所有速度、檢查時間、錯誤率及修復時間都是人工選定,沒有使用人類鍵盤、視線追蹤、輸入法紀錄或問卷。所謂「原始速度升高使錯誤率按平方增加」是一條便於產生比較情境的數學函數,不是 Card、Salthouse 或 MacKenzie 等文獻的實證結果。實際速度與錯誤率可能受到疲勞、熟練度、任務難度、語言、鍵盤與學習效應共同影響,甚至存在某些熟練使用者速度較快而錯誤率也較低的選擇偏差。沒有實測資料,無法建立對香港使用者或其他人口的外部有效性。
更根本的問題是,若發現早前錯字,許多使用者可以移動游標只替換一個字符,根本不會把整段文字刪光。本文選擇後綴回退,是為了研究一個可解釋而清楚的極端操作策略;它不是效率最高的文本編輯方法,也沒有證據表明大多數人習慣如此處理。由此產生的長退格概率,是一個策略條件機率,不是現實使用者出現長退格的無條件概率。若使用者採用混合策略,必須另外量度不同策略的選擇概率及其與錯字位置的關係。
9.2 可靠重建與固定檢查成本限制模型實用性
基本模式假設後綴重建一定正確,且費用與重建字數成正比;但重輸過程可能引入新錯字,需再次校對,甚至使疲勞逐輪增加。若引入這些錯誤,恢復流程會是一個具有重複嘗試的隨機過程,成本可能需要以吸收馬可夫鏈或動態規劃計算。基本模型中非常長的區塊具有有限重建成本,正是此簡化假設的直接後果;若不處理,不能用其高速度端的最佳值制定工作政策。
同時,每次校對三秒且與段長無關的假設非常脆弱。十字與三百字的校對認知時間不可能先驗視為相同。若改用 ,其中 本身按字數增加,模型的常數項及最優條件會改變。更精細模型可讓超長段落的注意力衰退提高漏檢概率;但那需要真人數據或具明確來源的情境參數。目前圖一至圖五只是在固定規則下比較不同決策,不是對人類感知負荷的估計。
9.3 錯誤種類與模型統計指標簡化
獨立伯努利錯字忽略中文輸入法中的字詞候選、漏字插字、語音辨識結果、選取範圍、自動完成及跨句語意錯誤。馬可夫鏈雖容許連續錯字,仍只有一階記憶、固定平穩邊際率,無法表示錯字與字母鍵距離、詞語長度或手指動作的複雜關係。所謂修復率、殘留字錯率和回退長度,與正式文本輸入研究中的 MSD、KSPC 或字符對齊指標有可比較的問題意識,但其分母與事件定義不同,不能把數字當成既有指標值。
對未完全檢出的情境,本文計算殘留錯字期望,但沒有計算整段語意是否正確,亦沒有建立重複校對及外部審核。期望錯字數可以用線性期望直接求得,卻不能只靠此數字推算文件被使用者理解錯誤的概率。任何涉及高風險文書的品質要求,都需要根據實際錯誤後果與真實資料建立,而不能直接以本文人工選擇的百分比作安全門檻。
9.4 內部模擬核查與外部驗證之間的界線
九萬區塊的電腦模擬屬合成數據;程式斷言、圖片與數值總表可以幫助重現理論計算,但並非用另一份真實資料作外部驗證。四位 reviewer 的意見也只是研究所內部的角色模擬,沒有正式期刊的獨立同行評審。引用文獻已核對出版資料及可讀摘要/頁面,但非所有全文皆經逐頁細讀;正文沒有將那些文獻說成支持本文人為指定的係數。因此本論文宜被視為可重現、可討論的理論研究,而非已確認的人機互動介入成效研究。
10. 結論
本文把「打字打得飛快,最後卻一路退格回到起點」的笑話轉化成一個首次失誤及定期檢查的可靠度模型。對獨立錯字,回退長度 由最早錯字位置決定,精確尾部概率為 ;當修復必須刪除整個後綴時,即使只有一個早期錯字,也可以製造非常長的退格序列。當每次校對有固定成本而退格會增加工作量時,可以利用期望時間函數在正整數區塊長度上求最適解。此處的精確公式與獨立合成模擬一致,構成研究最可驗證的部分。
在完全人工的基準情境下,最適校對間隔是六十八字,每潔淨字期望耗時 0.320047 秒;九萬個合成區塊給出幾乎相同的時間平均。提高人工錯字率會在固定區塊內增加長退格尾部事件,但經重新最佳化的校對間隔未必單調縮短:模型在較高速度下顯現修復成本飽和及極長區塊極限。校對不完整時可見退格雖然減少,仍可能留下錯字;在相同邊際錯字率下,錯字群聚也可能令含錯區塊較少。這些看似反直覺的結果是規則與分布的數學後果,沒有被宣稱為一般人類打字者的實證特徵。
研究的真正提示是:輸入速度、可見修正次數、殘留錯字和完成正確文字的耗時,應分別定義、分別測量。任何鍵盤效率結論如果只拿其中一個指標代表全部績效,都可能因忽略校對與重做而得出荒謬的排行榜。令人好笑的退格操作,在數學上並不神秘;難題是現實使用者究竟在何時發現錯誤、如何選擇修復,以及重新輸入會否再次出錯。對這些問題,本文已提供可供下一階段資料研究檢驗的模型結構,但沒有冒稱獲得最終答案。
11. 未來研究方向
第一個延伸是建立知情同意的真實輸入研究,在不保存敏感文字內容的前提下,記錄按鍵事件時間、校對停頓、回退長度及錯誤對齊;受試者可以使用任務專用的非私人短句,減少隱私負擔。應預先指定主要輸出,包括已修正錯誤率、未修正錯誤率、時間吞吐及長退格尾部,而不是只比較總字數。若有足夠樣本,可以階層模型估計個體速度與錯誤率的差異,再檢驗本文人為平方律是否與資料相容;不相容時應拒絕它,而不是微調圖表使其看起來合理。
第二個延伸是讓修復流程本身具有錯誤率,並容許使用者在局部替換、後綴重建及整段撤銷之間選擇。若修正會再次失敗,研究可使用更新過程或吸收馬可夫決策模型,處理在不同失誤位置及剩餘字數下的最優操作。若校對速度與段落長度相關,則須建立具有時間成本和漏檢風險的雙重限制,並以實際閱讀任務估計。這些延伸將對目前較高速度下出現的「最適間隔反而擴大」提供強而有力的理論壓力測試。
第三個延伸是研究智能文字輸入系統的提示設計。系統可在長段文字存在高概率錯誤時提醒校對,也可以只標出可疑位置而不要求全段後退。若使用者可以保持正常書寫流,改正單一錯字的操作成本會降低,最佳策略可能由固定間隔轉為按不確定度觸發的檢查。未來應在獨立真實資料上比較提示造成的中斷成本、修正後的真正錯字率及接受程度;模型的作用是產生可測假說,而不是決定使用者必須服從哪一種文字輸入習慣。
最後,可把同一方法推廣至其他「先做很多,才發現前面一處錯誤」的荒誕日常經驗:填完二十欄表單才發現第一欄名稱錯誤、錄完長語音才發現最先一句講錯、做完一頁計算才發現抄錯初值。只有當這些任務具有清楚的故障位置、修復範圍與成本時,概率模型才可合法轉用。否則,更值得被推翻的可能是研究者愛把所有尷尬事情都寫成同一條公式的習慣。
參考文獻
Card, S. K., Moran, T. P., & Newell, A. (1980). The keystroke-level model for user performance time with interactive systems. Communications of the ACM, 23(7), 396–410. https://doi.org/10.1145/358886.358895
Daly, J. T. (2006). A higher order estimate of the optimum checkpoint interval for restart dumps. Future Generation Computer Systems, 22(3), 303–312. https://doi.org/10.1016/j.future.2004.11.016
MacKenzie, I. S., & Soukoreff, R. W. (2002). Text entry for mobile computing: Models and methods, theory and practice. Human-Computer Interaction, 17, 147–198. https://doi.org/10.1080/07370024.2002.9667313
Salthouse, T. A. (1986). Perceptual, cognitive, and motoric aspects of transcription typing. Psychological Bulletin, 99(3), 303–319. https://doi.org/10.1037/0033-2909.99.3.303
Soukoreff, R. W., & MacKenzie, I. S. (2003). Metrics for text entry research: An evaluation of MSD and KSPC, and a new unified error metric. Proceedings of the SIGCHI Conference on Human Factors in Computing Systems, 113–120. https://doi.org/10.1145/642611.642632
Wobbrock, J. O., & Myers, B. A. (2006). Analyzing the input stream for character-level errors in unconstrained text entry evaluations. ACM Transactions on Computer-Human Interaction, 13(4), 458–489. https://doi.org/10.1145/1188816.1188819
Young, J. W. (1974). A first order approximation to the optimum checkpoint interval. Communications of the ACM, 17(9), 530–531. https://doi.org/10.1145/361147.361115