摘要
當使用者刪除一封未讀郵件後,介面的未讀數字理應下降一,但某些想像中的異步介面可能在刷新後反而顯示更大的數字。本文以此日常悖論研究分散式系統中不同版本的資料如何被先後展示。建立兩條更新通道的混合快照模型:既有郵件由未讀轉為已讀的事件以泊松過程發生,較新的副本 A 最初提供未讀統計;刷新時,副本 B 提供更舊的已讀狀態快照,而剛發出的刪除事件可獨立經另一通道抵達並覆寫一筆未讀計數。本文推導顯示未讀數增加的精確概率,並用 120,000 次固定種子合成試驗驗證。於讀取事件率 0.8 次/秒、兩副本滯後 0.3 與 2.0 秒、刷新時間 0.15 秒、刪除傳遞平均延遲 1.5 秒的情境下,解析概率為 0.676468,模擬頻率為 0.674983,蒙地卡羅標準誤為 0.001352。五張研究圖討論快照年齡、事件頻率、刪除傳遞延遲及介面修正的代價。特別指出:強制計數單調下降可以在無新信件的假設下消除這類上升,但一旦真有新郵件抵達,該方法又可能壓抑正確更新。結論在於顯示順序和事件因果順序不同,數字反彈不必意味著資料庫真的新增了一封郵件;同時,本文不能證明任何真實郵件服務存在相同機制。
Abstract
An unread-mail counter may appear to rise just after a user deletes one unread message. We examine this paradox through a deliberately simplified, synthetic model of replica snapshot divergence. Previously unread messages are marked read according to a Poisson process. The interface initially shows a relatively recent read-state snapshot from replica A, then refreshes from an older read-state snapshot from replica B. A separate deletion-update channel may reach B before the refresh. We derive an exact expression for the probability that the refreshed counter exceeds the initial counter. At a prior read-event rate of 0.8 per second, snapshot lags of 0.3 and 2 seconds, a refresh delay of 0.15 seconds, and a mean deletion propagation delay of 1.5 seconds, the exact probability is 0.676468. A seeded simulation of 120,000 synthetic trials yields 0.674983 with Monte Carlo standard error 0.001352. Five figures examine lag, read intensity, delivery delay, the change distribution, and the cost of enforcing a monotonic display when genuine new mail arrives. The counterexample does not establish how any particular email service operates. It illustrates how a UI may present causally incomparable or differently aged derived views, and why simplistic visual guards exchange one anomaly for another.
關鍵詞: 未讀郵件;最終一致性;分散式快照;事件偏序;泊松過程;蒙地卡羅;可觀察性;顯示單調性;合成模擬
1. 引言:刪除鍵竟然有加法功能
一般人理解郵件收件匣時,會把畫面頂部的未讀數視為當下資料的可靠總結。若目前有十二封未讀信,刪除其中一封仍未閱讀的信,新的數字應當是十一。這項算術很普通,因此若數字短暫顯示十三,使用者便容易認為自己按錯、系統故障,甚至懷疑有新信在看不到的地方冒出來。日常描述偏重操作與畫面的相鄰時間:我按下刪除,下一個畫面顯示增加,所以「刪除導致未讀增加」。然而,時間上的先後不等於資料事件的因果關係,下一個畫面亦未必比上一個畫面代表更新的世界狀態。
本研究首先限制題目的範圍。我們無法獲得任何郵件服務的真實副本拓樸、快取策略、同步隊列或未讀計數器演算法;因此不以此論文解釋 Gmail、Outlook 或任何特定軟件的實際行為。本文問的是一道可證明的存在性問題:若介面允許新舊資料快照在前後刷新時交錯,且刪除操作獨立傳遞,是否可以在沒有任何新郵件抵達的前提下,製造正數的可見計數變化?只要答案為是,便足以推翻「畫面數字上升必有一封新郵件抵達」這個絕對判斷,但仍遠不足以推斷某一真實服務正是如此實作。
同一個數字至少有三種不同語義。第一是權威資料狀態內的真實未讀數,亦即某個明確序列化時刻所有現存、未讀郵件的計數。第二是後端派生統計,可能在不同資料副本上計算,具有某一資料版本或快照時間。第三是顯示於使用者裝置的計數,它可能來自客戶端快取、伺服器回覆或增量事件。研究的異常定義只涉及第三個數字相對前一次可見數字的差值,不聲稱第一個數字曾違反算術。把這三層拆開,是避免將分散式傳播延遲簡化為「資料庫亂數」的必要步驟。
題目具荒誕感,因為刪除通常象徵減法;其學術價值則來自讀取副本、事件順序、資料新鮮度與介面設計之間的張力。使用者所見是一條按顯示時刻排列的時間線,分散式系統實際處理的則可能是許多不同的資料線。本文以能夠解析求解的最小模型探索這項張力,再以電腦實驗確認數值,最後評估一項看似簡單的補救:不准刪除後的未讀數向上跳。若這項規則會吞掉真正的新郵件,那麼「讓數字看起來合理」便不是無成本的系統正確性。
本文組織如下:先回顧分散式事件排序、弱一致性及複製資料的文獻,繼而界定研究問題與模型中各條事件通道;接着推導計數反彈概率,提供完整參數、模擬與圖表檢查;最後討論修正方案、敏感度、外部效度與研究限制。整個實驗不涉及用戶私隱資料,亦沒有真實人類參與者,故所有機率應理解為人工設定生成機制的條件機率。
2. 文獻回顧:時鐘次序、複製狀態與顯示語義
Lamport(1978)以事件間的 happens-before 關係指出,分散式系統的因果次序是一個偏序:同一程序內的操作,以及訊息發送與接收之間可有確定因果關係,但不同程序上的事件並非全部能按單一物理時鐘毫無歧義地排列。本文借用這個基本觀點分辨「刪除指令先於畫面刷新」與「畫面刷新取得了所有先前已讀操作」兩件事。若刷新回覆取自另一份較舊資料版本,刷新時間較晚也不足以保證其內容較新。Lamport 的論文沒有研究本文的郵件題目,也未提供本文所用泊松強度。
Vogels(2009)討論最終一致性系統在更新傳播和讀取回覆方面的取捨。對最終一致性的直覺理解是:只要後續沒有新寫入、更新終能傳播而副本終將收斂;它並不保證任何中間時刻的讀取都看到最即時狀態。本文的舊快照重現與該觀念相容,但有意不把它當成最終一致性必然產生可見反彈的證明。即使後端允許陳舊讀取,客戶端仍可維護會話版本、要求單調讀取或以權威版本整合回覆,令使用者不看到數值倒退。換言之,儲存層容許甚麼與使用者體驗實際暴露甚麼,是兩個不同設計決定。
Gilbert 與 Lynch(2002)研究有網絡分區時一致性、可用性和容忍分區之間的可行性限制。CAP 定理常在大眾討論中被當作所有同步問題的萬用解釋,這是容易越界的用法。本文未假設發生網絡分區,也沒有證明某系統同時追求哪些特定的一致性與可用性保證。因此本文只以其工作提醒讀者:討論「一致性」必須指出一致性的定義和系統環境;不會聲稱 CAP 定理必然令郵件數字跳升,亦不會把任何非零同步延遲都稱為 CAP 事件。
Shapiro、Preguiça、Baquero 與 Zawirski(2011)提出和整理衝突自由複製資料類型的概念,展示在具適當代數結構和合併規則時,分散式資料可透過交換與收斂取得一致結果。這為研究提供反例:多副本不代表介面必然出錯,計數統計也不必純粹依賴最後收到的整數。若可以把每封郵件的存在與已讀狀態保留為具有身份的事件,便有機會利用明確版本或合併語義重算計數。不過,刪除與已讀都牽涉集合成員資格及衝突政策,簡單加減一的整數並非完整 CRDT;本文既沒有實作該文提出的完整資料結構,也沒有聲稱能從這五張統計圖證明收斂性。
Terry 等人(1995)介紹弱連接複製資料系統中的更新衝突管理。本文借用的研究啟示是,一項更新可以在不同複製節點上以不同方式和時間被觀察,系統必須說明操作、合併及可見版本的語義。該篇研究不包含現代郵件服務的未讀計數實驗;本研究與其聯繫限於方法論。綜合上述文獻,我們能可靠地指出「事件次序、資料複製和一致性契約值得分別建模」,卻不能由文獻直接推出任何實際郵件計數反彈發生率。
現有文獻還揭示方法上的一個重要空白:理論可以解釋因果、收斂和讀取保證,但畫面上一個看似微不足道的紅色數字,依然需要具體產品級語義才能分析。「刪除後應下降多少」牽涉所刪郵件是否原本未讀、是否被其他裝置標記已讀、是否有新信、篩選條件與資料夾定義,甚至標記數字代表對話串還是郵件封數。因為這些細節不足,本文特意固定「刪除一封確定未讀且未被重複計算的郵件」作為事件,從中隔離快照新鮮度差異本身的作用。學術引用提供概念地基,數字結果完全來自本文另行提出的可重現模型。
3. 研究問題、假設與可檢驗的命題
研究問題一(RQ1)是,在沒有新郵件到達、真實未讀集合只會縮小的情況下,先後顯示不同版本的快照是否仍可讓計數增加?相應假設 H1 是:當刷新取得的已讀狀態快照比最初快照更舊,兩者時間差範圍內若曾有足夠數量的已讀事件,舊快照就可能使那些在 A 已讀的郵件重新被計入 B 的未讀統計。因此畫面計數變化可能為正,雖然在權威事件次序中每一項事件都不會令真正未讀數增加。這是一個構造性存在命題,不是對常見性作出經驗推斷。
研究問題二(RQ2)是,這種反彈概率如何取決於快照時間差、此前將未讀標記為已讀的事件頻率,以及刪除操作的傳遞速度?假設 H2 指出,固定其他參數後,較大的快照時間差及較高的已讀事件率通常會令反彈更易發生;刪除成功抵達 B 則可抵消一筆重新出現的未讀計數,因而降低反彈概率。上述單調性可由精確公式微分或比較泊松隨機變數得到。值得強調,「通常」指模型的條件單調性,並非量度真實環境後發現的相關性。
研究問題三(RQ3)是,能否以一項客戶端單調顯示規則完全消除此視覺悖論?H3 將驗證在完全沒有新郵件的基準制度下,強制刷新後數字至少減一必定令反彈機率為零。但研究問題四(RQ4)同時要求檢查該規則的副作用:在真正有新郵件到達的另一情境中,隨意禁止正向變化是否會隱藏合理的增長?H4 的預測是,當真實變化不等於負一時,強行把顯示差值截斷至至多負一必然可能抹去資訊,並且在新信流量增加時愈來愈常見。
本研究不檢驗不同產品之間誰較易發生異常,不評估使用者是否真的會誤會,不聲稱所有採用複製架構的系統都會有此畫面行為。觀察單位是一次獨立人工試驗,而「概率」指在指定參數下反覆生成事件序列的相對頻率。研究設計包括一項解析公式、一項直接隨機抽樣驗證、若干敏感度曲線和一項獨立的新信抵達反例。若將來拿到已匿名化並有時戳的系統追蹤記錄,方可把研究由可行性證明轉成產品行為的經驗檢驗。
4. 操作時間線:兩個副本並不是兩個平行宇宙
令使用者發出刪除操作的物理時刻為零。最初畫面所展示的數字從副本 A 的已讀狀態快照計得,而 A 的截止時刻為負的 L_A 秒;待時刻 t_r 大於零刷新時,畫面採用 B 的已讀狀態快照,B 的截止時刻為 t_r 減 L_B 秒。L_A 與 L_B 均為非負的資料年齡,t_r 是刪除發生至刷新的等待秒數。所謂「時間差」並非兩部裝置鐘錶不準,而是兩個資料快照代表的不同事件截止時刻。即使同一部手機按順序展示 A 和 B,較晚展示的 B 仍可能代表較早的系統狀態。
本文另設「刪除更新通道」。B 顯示的計數是其較舊的已讀狀態快照,外加一項可能已送達的刪除事件扣減。因此它不是單一完整資料庫在某個物理時刻的純快照,而是不同更新通道合成的一個派生視圖。這項混合快照假設十分關鍵:若宣稱 B 在刪除前的純快照能直接包含刪除後的操作,便會自相矛盾。為避免此問題,我們明確設計 B 的已讀狀態與刪除覆寫為兩條可非同步抵達的資料流,更新組合只在介面計數層發生。現實系統是否存在此架構,需要獨立測量才能回答。
研究選定被刪除的那封信起初確定屬於未讀集合,而且不包括在其餘可能被標為已讀的事件流之內。這避免同一封信先被標記已讀又被刪除而出現雙重扣數。其餘舊信可能在兩個快照截止時刻之間由未讀轉為已讀,每個事件均會令正確的新版本未讀數減一。假設未讀郵件庫存足夠大,這些事件不會因為庫存用盡而被截斷。模型不處理郵件串合併、取消刪除、其他資料夾計數、標籤繼承或客戶端樂觀更新;每一項排除均旨在單獨辨認由版本差造成的效應。
若 B 的已讀狀態截止時刻早於 A,則一組在 A 已看見、在 B 尚未看見的標記已讀事件可令後者多算未讀。設這組被 B 遺漏的事件數為 K;另設 I 為刪除覆寫是否已在刷新前到達 B 的指示變數。當 B 的已讀狀態更舊時,顯示差值便是 K 減 I;若 B 同樣新或更新,額外已讀事件只會使刷新後數字降低,不會產生正向反彈。本研究不需要宣稱每個副本的完整訊息內容也跟計數同步,恰恰相反,這個不一致是研究對象。
5. 概率生成機制及變數定義
在刪除時刻以前及快照差距之內,其他現存未讀信被標記為已讀的事件遵循強度為 λ_r 的齊次泊松過程,單位為每秒事件數。模型假設各不重疊時間區間的事件數獨立,平均事件數與區間長度成正比,且沒有連鎖批次標記已讀、工作日週期或使用者注意力群聚。泊松過程並非對人類讀信心理的客觀描述,而是一條簡潔、能被分析與模擬驗證的代理生成規則。只要生成規則改變,本文的具體數值亦可能改變。
定義 g 為舊 B 快照與較新 A 快照截止時刻的距離:
當 g 大於零,兩個截止時刻之間的已讀事件數 K 服從參數 m 的泊松分布;當 g 不大於零,B 不會遺漏 A 已見到的較新已讀事件,正向異常概率在這個沒有新增信件的模型中為零。另一條刪除通道的傳遞延遲 T_d 假設服從平均值 τ_d 的指數分布,並獨立於已讀事件流。若 T_d 不超過 t_r,刪除已到達 B,令 I 等於一;否則 I 等於零。相應機率為 d。
在 g 大於零時,定義刷新前後的顯示未讀計數為 C_A 與 C_B,ΔC 等於 C_B 減 C_A,則有 ΔC=K−I。刪除送達並不令其他郵件的已讀事件倒流,而是把另一筆仍未讀的目標信從 B 的派生計數中扣除。K 與 I 之間的獨立性是一項可被日後實測推翻的研究假設:真實後端的已讀事件及刪除往往共享網絡、隊列與負載,不一定獨立。本文只有在明確假定此獨立性下才可使用簡單乘積機率。
本研究的「反彈」定義為 ΔC 大於零,而「剛好加一」另定義為 ΔC 等於一。兩者不能互換:模型可能一下子多出兩封、三封或更多,看似比日常一句「加一」更離奇。由於泊松分布在所有非負整數上都有正概率,g 大於零且 λ_r 大於零時,任何有限次數的向上跳都有非零理論概率;但其尾部急速下降,較大跳幅不代表在有限樣本中常見。研究同時關注平均變化、概率分布和敏感度,而不只挑選最戲劇性的某一條樣本軌跡。
6. 核心定理:刪除後的加法如何成立
考慮 B 的已讀快照比 A 舊,即 g>0。若刪除事件仍未到達 B,I=0,刷新計數上升當且僅當 K 至少為一;若事件已到達,I=1,上升需要 K 至少為二。將兩種互斥事件的概率相加,就得到反彈的解析結果。因為泊松變數的零次概率是 exp(−m),一次概率是 m exp(−m),故 K 至少為二的概率是 1−(1+m)exp(−m)。
此結果可以化簡成一個特別容易分析的形式:全部可能的「舊已讀狀態令未讀反彈」先貢獻 1−exp(−m),成功傳遞刪除才從中扣去剛好只有一筆遺漏已讀事件的情況,扣除量為 d m exp(−m)。因此同一條概率曲線既受到快照時間差帶來的泊松尾部控制,也受到刪除通道的到達概率調節。當 g≤0,本文明確定義概率為零;此分段不可隨便把負的 m 代入泊松概率,因為泊松強度不能為負。
上述式子還揭示「刪除操作加大反彈」並不是數學模型的結論。相反,刪除事件若真的送達 B,會令畫面計數減一,降低反彈概率。造成上升的是版本倒退使已讀狀態回到舊值,刪除只是使用者注意到異常的觸發時刻。因此從因果推斷角度,僅觀察刪除前後兩張截圖不足以判定刪除本身對未讀狀態有正向效果;必須知道顯示數字背後的資料來源及版本才可以識別原因。
對固定 d 的情況,把概率對 m 求導,可得 exp(−m)[1−d+dm]。由於 0≤d≤1 且 m≥0,此導數非負;只要不是特殊零邊界便嚴格為正。再對 d 求偏導,得到 −m exp(−m),表明增加刪除送達概率會降低反彈機會。在 τ_d>0 與固定 t_r 時,d 隨 τ_d 增大而減少;因此刪除平均傳遞時間越長,反彈概率越接近「刪除未送達」的上界。然而當 m 很大時,兩條曲線都接近一,單靠加快刪除不可能完全抵銷大量被遺漏的已讀事件。
當 g>0 時,ΔC 的期望與變異也有封閉形式。利用泊松分布均值與變異都等於 m,伯努利分布均值為 d、變異為 d(1−d),且兩者獨立,得出 E[ΔC]=m−d 及 Var(ΔC)=m+d(1−d)。值得注意,正的平均差值不能被直接解讀為一次刷新上升的概率;例如少數很大的正跳與大量負一樣本可能使平均大於零,而反彈比例仍低於一半。研究因此同時呈報事件概率及平均幅度。對高等統計建模而言,將事件機率與幅度分布分開是一項基本的檢驗程序。
若要直接研究「恰好加一」,將未送達且 K=1,以及送達且 K=2 的情況相加便可得 (1−d)m exp(−m)+d m² exp(−m)/2。這個細節說明原題的措辭只是一個引子:刷新後未讀數增加兩個或以上,並不違反模型內的狀態更新假設。要研究具體的加一概率,可以用同樣的總概率技巧,不需要創造另一個機制。若以實際資料檢查,亦應按跳幅分層,而不是把所有正值合併後便結束。
7. 邊界條件與定理的正確解讀
第一個邊界是資料次序。若 B 快照沒有比較舊,即 g≤0,而且期間只會有已讀事件及對未讀郵件的刪除,則計數不應上升。這是本模型的結構性零概率,而不是從有限合成試驗中碰巧看不到上升。即使把刷新做得更慢,只要新的 B 快照截止時刻一直前移並追過 A,版本反彈就不會由已讀狀態倒退造成。相反,若固定 B 的資料年齡 L_B 不變而增加刷新時間 t_r,B 的截止時刻也會前移,使 g 減少;此時刷新等待同時改變資料差距與刪除送達概率,兩個方向都可能有利於降低反彈。
第二個邊界是事件稀疏性。當讀信率 λ_r 為零,或者 g 恰好趨近零,m 就趨近零,反彈概率也趨近零;最初幾項近似展開為 (1−d)m 加上與 m² 有關的項。若刪除通道保證在刷新前已送達,即 d=1,公式化為 1−(1+m)exp(−m),在小 m 下主要呈二次量級。其意義是:只有一筆被 B 遺漏的已讀事件會被已送達的刪除抵消,需要兩筆才能真正上升。這是一種清楚的系統防禦效果,但它依賴目標刪除恰好扣一的假設;若刪除的是已讀信,此項抵消便不存在。
第三個邊界是事件庫存。泊松生成器在任何有限長度區間都有可能產生比郵箱實際未讀存量更多的「標記已讀」事件,這在有限郵箱內並不合理。本文將事件視為抽象流,假設背景未讀庫存足夠大,而不模擬有限上限。因此推導適用於尚未接近庫存耗盡的局部時間窗;如果研究一個只有兩封未讀信的郵箱,K 必須受到可讀郵件數限制,分布將不是無界泊松。這也提醒我們,為何一個能嚴格解出的模型仍然不應直接用來估計真實小型郵箱的故障率。
第四個邊界是刪除事件的意義。本研究中的 I 是刪除更新是否已在刷新前抵達 B 的事件指示,並非某個瀏覽器已畫出刪除動畫、伺服器收到 API 請求或資料庫完成交易的通用同義詞。實際產品可以先讓畫面立即減一,稍後再經後端確認;也可以等待一致回覆才改畫面。不同時序會改變 C_A、C_B 和使用者所感知的前後差值,必須另外建模。本文選擇沒有預先樂觀減一的版本作為基準,故其結果與另一種先行減一的介面沒有直接數值可比性。
第五個邊界是整體一致性契約。模型能描述舊已讀快照與新刪除覆寫被合併的派生數字,但沒有定義完整的信件列表、副本之間如何交換原始事件、故障恢復時如何去重或所有讀取何時最終收斂。精確概率公式並沒有使這項簡化變成對完整分散式資料庫的正確性證明。嚴謹研究應在摘要及結果使用「指定混合快照模型中」一語,避免讀者誤以為任何最終一致服務都有六成多機會在刪除後反彈。
8. 計算研究設計與可重現程序
為了獨立驗證解析式,我們使用 NumPy 的固定種子偽隨機生成器,種子為 2026102601,主要試驗數 N=120,000。每次試驗先依泊松分布抽取兩個快照截止時刻之間的標記已讀事件數 K,再依平均 τ_d 的指數分布抽取刪除傳遞時間 T_d;若延遲不超過刷新時刻,設 I=1。以 K−I 計算可見差值,記錄差值是否大於零,並把指示事件的平均值作為蒙地卡羅概率估計。模擬使用的是泊松過程在固定區間內事件數的邊際分布,而不是逐封生成真實郵件和閱讀行為,兩者在本模型假設下完全等價。
| 參數 | 符號 | 基準設定 | 操作定義 |
|---|---|---|---|
| 其他郵件被標記已讀事件率 | λ_r | 0.8 次/秒 | 泊松事件率,人工設定 |
| 最初副本 A 已讀快照年齡 | L_A | 0.3 秒 | 刪除時刻以前 |
| 刷新副本 B 已讀快照年齡 | L_B | 2.0 秒 | 以刷新時刻計算 |
| 刪除至刷新時間 | t_r | 0.15 秒 | 兩次畫面讀取的間隔 |
| 刪除傳遞平均延遲 | τ_d | 1.5 秒 | 指數分布的平均值 |
| 模擬試驗數 | N | 120,000 | 獨立合成試驗 |
| 隨機種子 | seed | 2026102601 | 可重現亂數初始化 |
代入表中數值,已讀快照截止時間之差 g=2.0−0.15−0.3=1.55 秒,故 m=0.8×1.55=1.24。刪除在刷新前送達 B 的理論概率為 1−exp(−0.15/1.5)=1−exp(−0.1),約 0.095163。將兩個值帶入第六節的定理,得到約 0.676468。這個運算不需數值積分,也不需由隨機試驗擬合任何參數;因此若模擬與解析數字相差很大,應先檢查程式、亂數生成與事件定義,而不是把差距解釋為真實世界的複雜性。
蒙地卡羅估計量等於 N 個是否反彈的指示變數平均。因每次合成試驗按預先固定的機制獨立生成,在模型內可使用二項抽樣的標準誤近似 sqrt[p(1−p)/N];計算時以模擬比例代入 p。這個標準誤衡量同一模型再抽樣的變化,不包括參數選錯、事件獨立性失效、實際用戶行為異質、資料架構不符等模型誤差。本研究沒有實測母體,因此不能把 95% 蒙地卡羅區間宣稱為「真實郵件服務反彈率」的信賴區間。
程式還進行三類檢查。第一,斷言解析與模擬比例差距低於以標準誤衡量的預定門檻;第二,檢查不存在正時間差時的解析反彈概率為零;第三,以明確的資料輸出讓圖表、均值和合成樣本可被交叉核對。主要輸出為 data/summary.json、每十二次試驗抽一筆的 data/sampled_trials.csv、以及 figures 資料夾的五張研究圖。CSV 只提供代表性可核對樣本;完整統計來自腳本每次重新生成的全部 120,000 筆試驗,並非聲稱 CSV 是完整事件檔。
為避免後見之明調參,我們把基準參數視為事先選定的示範情境,而不是通過比較數值後選擇「最容易得到趣味結論」的一組真實估計值。圖一至圖四的其他值是參數敏感度探索:只改變橫軸或曲線標示的一個因素,其餘保持基準;圖五則有意使用獨立的真實新信抵達生成機制,以構造違反「刪除後絕不可增加」假設的反例。由於後一情境的事件設計與基準不同,不把兩者的概率直接當成同一批個案的政策勝負。
9. 基準研究結果:分析與抽樣彼此對照
重新執行程式得到精確概率 0.6764679808561309,合成頻率 0.6749833333333334;兩者相差約 0.001485,約為本次模擬標準誤 0.001352 的 1.10 倍。這個幅度符合固定模型下常見的抽樣波動,無需額外發明隱藏參數。其對應的正態近似蒙地卡羅 95% 區間約為 [0.672333, 0.677633],包含解析值。區間並非獨立的實測證據,只是一個確認程式與概率演算相互匹配的內部一致性檢查。
| 結果指標 | 本次計算 | 解讀界限 |
|---|---|---|
| 精確反彈概率 | 0.676468 | 指定人工模型下的理論值 |
| 蒙地卡羅反彈比例 | 0.674983 | N=120,000 的合成試驗 |
| 蒙地卡羅標準誤 | 0.001352 | 僅包括抽樣隨機性 |
| 蒙地卡羅 95% 近似區間下限 | 0.672333 | 不代表真實產品不確定性 |
| 蒙地卡羅 95% 近似區間上限 | 0.677633 | 同上 |
| 合成差值平均 | 1.140717 | 刷新減初始顯示數 |
| 合成差值至少為二的比例 | 0.329108 | 正跳幅不只有加一 |
| 合成刪除成功送達比例 | 0.095642 | 與 0.095163 理論機率相近 |
基準平均差值約 1.1407,與 m−d=1.24−0.095163≈1.14484 的理論平均接近;平均量與反彈概率反映不同統計對象,不應混寫。樣本中最大正跳幅為十,但這只是一個固定樣本的極端值,不是模型上界,也不能聲稱真實用戶可能在一次刷新後無緣無故多十封未讀信。由於「目前未讀數」的絕對初值未在模擬中指定,模擬直接研究前後計數差;只要背景庫存足夠大,絕對初值會在相減時消去。
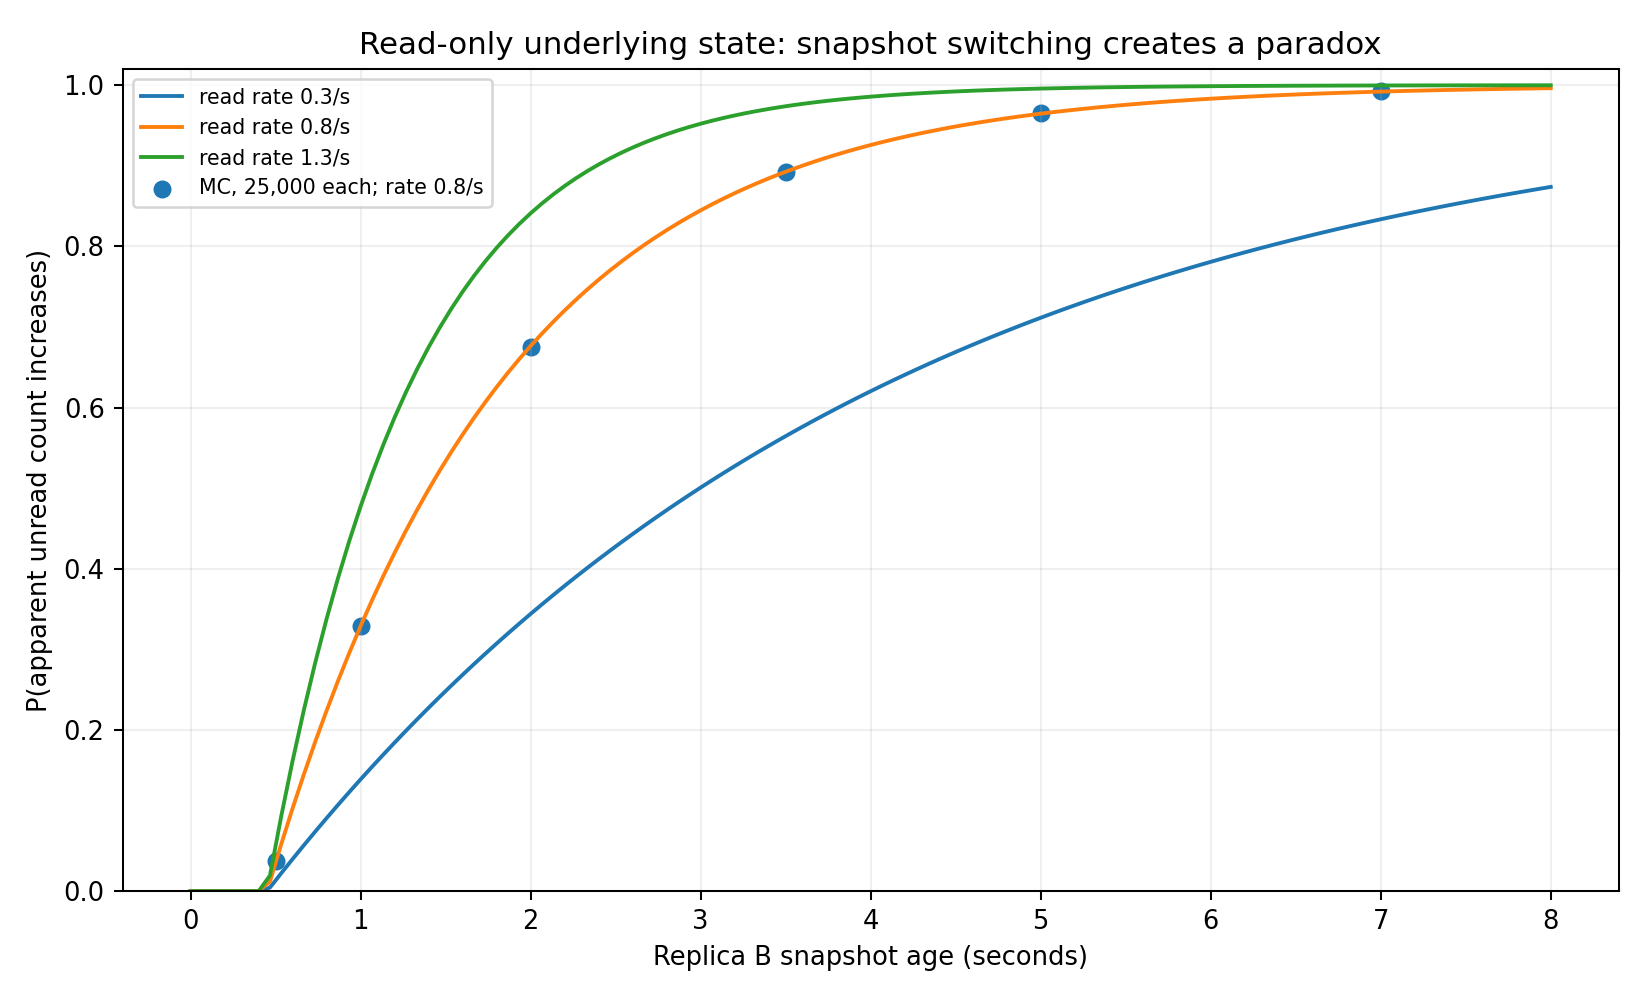
圖 1. 舊快照年齡對反彈概率的影響。實線為三種假想已讀事件率的解析預測,散點為已讀率 0.8 次/秒下每組 25,000 筆合成抽樣;圖中沒有真實郵件服務紀錄。
圖一展示 g 的分段作用。當 B 的資料年齡尚未大到令其截止時刻早於 A,解析曲線留在零;超過臨界快照年齡後,概率才隨可遺漏的事件窗口擴大而上升。固定 B 年齡為 0.5 秒時,解析概率約 0.03555;提高到 1 秒約 0.32900;到 2 秒約 0.67647;到 3.5 秒約 0.89260。這些不是「0.5 秒同步誤差必令某種產品有 3.6% 故障」的經驗結論,而是把不同假設代入同一條公式所得的反事實計算。
當資料年齡 B 提高至五秒,解析反彈概率約 0.96465,七秒約 0.99206。極高值的來源是持續高頻的其他郵件已讀事件在較長時間差內累積,泊松分布逐步把 K=0 或 K=1 的質量擠向很小。實際上,一個人未必可以長時間以每秒 0.8 封的頻率把大量不同未讀郵件標為已讀,也可能批次點擊或暫停;因此高年齡區的接近百分百概率特別依賴抽象的穩定事件率。這個現象提供研究假說,但不提供產品故障率推估。
10. 差值分布與介面補丁:消失的異常可能只是被遮住
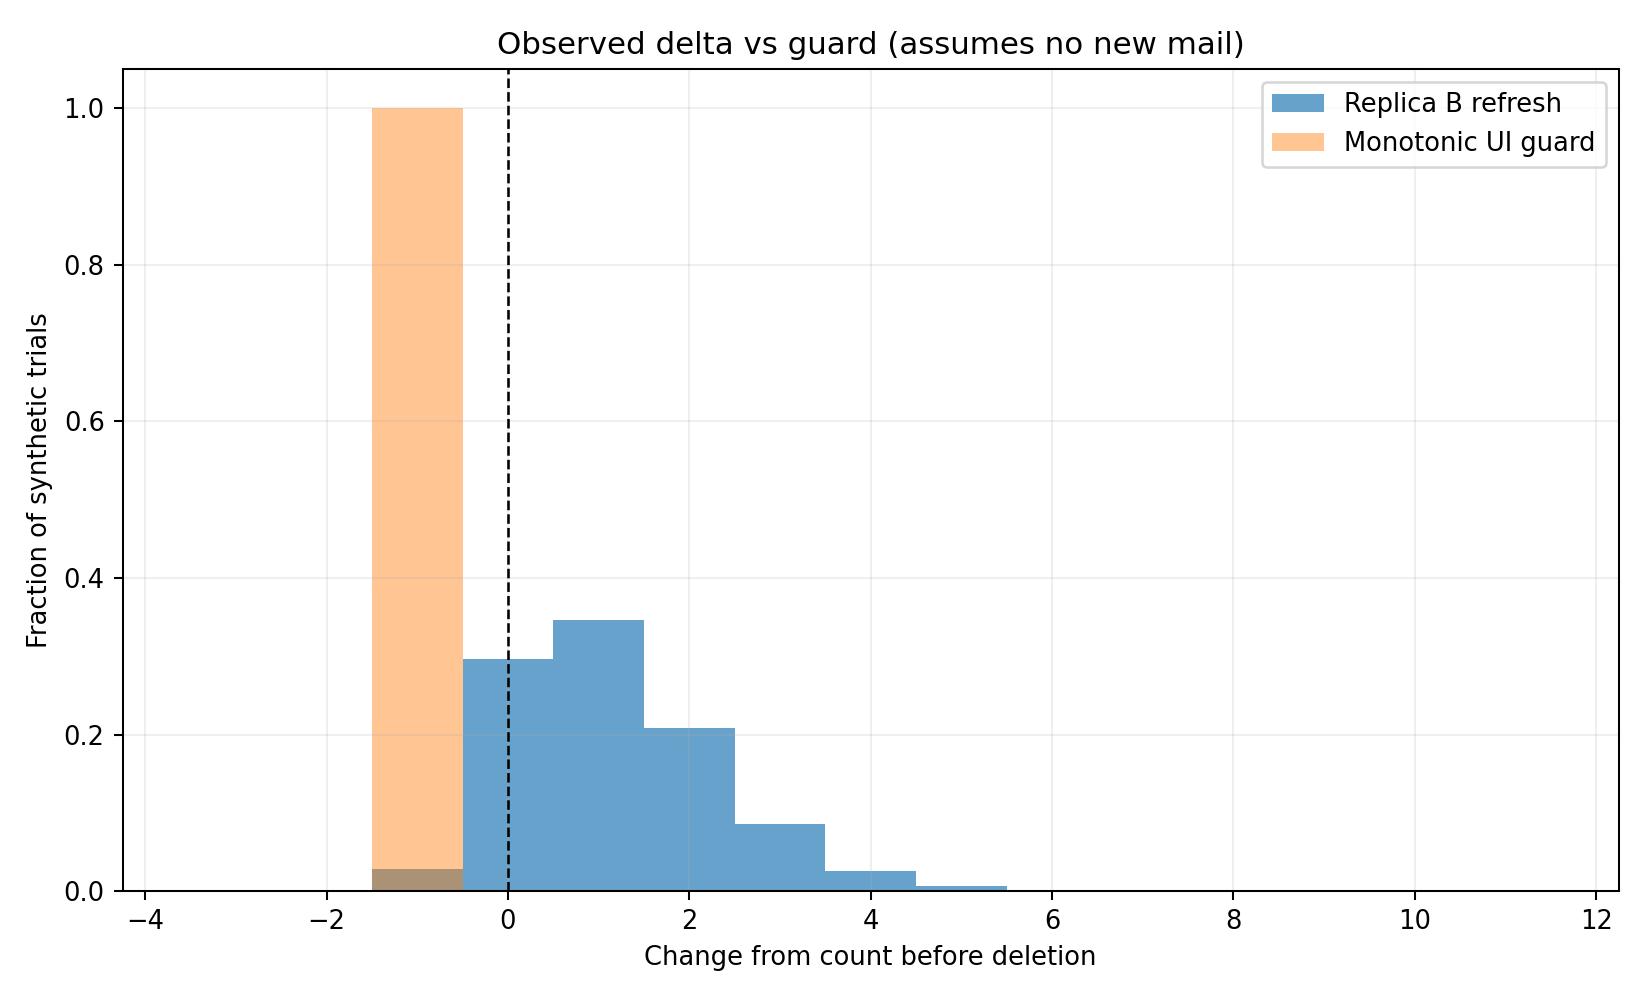
圖 2. 120,000 次合成試驗的刷新差值相對頻數;另一組為把差值截斷至最多負一之後的畫面結果。兩組由相同原始樣本導出,故不是兩個互相獨立的實驗。
在基準模型中,K 可為零、一、二甚至更高,而刪除送達指示 I 只會扣去零或一,故 ΔC 的下界是負一,沒有正的有限上界。概率分布在低正整數上相當集中,這與平均正值及三分之二左右的反彈比例相呼應。圖二的意義並非展示哪一個數字最引人發笑,而是讓讀者直接看到「正常刪除效果」和「舊快照恢復」如何在同一批樣本中競爭,形成負一、零和正整數各種結果。
考慮一條極簡的介面規則:當使用者明確刪除了一封原本未讀的郵件,將刷新後顯示的差值強制設為原始差值與負一的較小者。程式直接以 guard=min(ΔC,−1) 實作。因為任何輸入都被限制到不大於負一,此規則自然令 P(guard>0)=0,並且在沒有新信抵達的基準裏表面上符合「刪掉一封應下降」。這是一項演算法定義帶來的恆等式,並非透過模擬發現具普遍效力的補救辦法;即使換一個亂數種子仍為零,因為它是按規則不允許正值。
這項規則有意設計成容易質疑的反例。若刪除指令失敗,顯示卻被強制扣一,畫面就會撒謊;若有其他裝置在同一時間標記未讀、恢復郵件或收到新信,嚴格負一也未必等於正確狀態。更根本的是,這個 guard 並沒有修復後端的不一致,只在前端把資訊修改成符合使用者直覺的外觀。若產品在下一次刷新時解除限制,數字可能突然反跳;若永遠不解除,畫面又可能持續落後。因此圖二只證明「可以把反彈藏起來」,並沒有證明「可以令未讀數正確」。
此外,單調下降和單調讀取不是同一種保證。單調讀取通常涉及會話持續看到同一或更新的資料版本;其單調性描述的是版本或資訊進展,不是說未讀整數永遠不得增加。在真正有新郵件抵達時,正確的未讀數本來就應上升。若把系統的版本單調性錯譯成介面數值只許向下,便會犯概念層面的錯誤;本研究設計 guard 的目的正是揭露這個看似自然、實際上危險的混淆。
11. 敏感度分析:真正危險的是「看見更舊的現在」
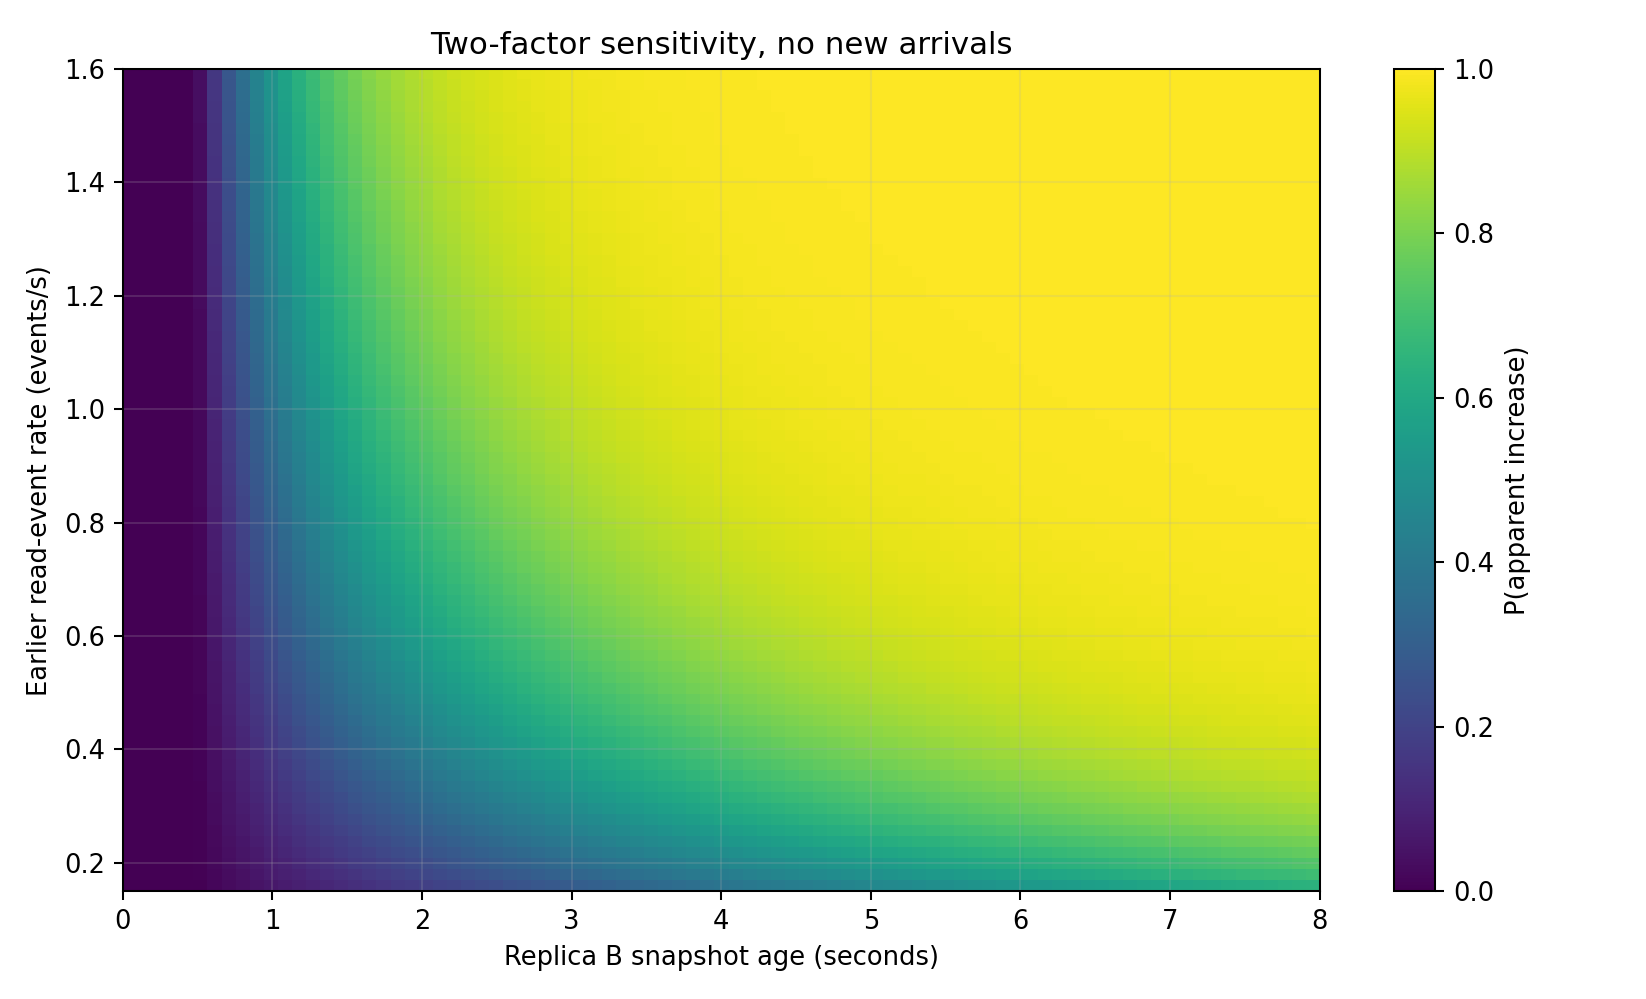
圖 3. 反彈精確概率相對 B 快照年齡及舊郵件已讀率的雙參數敏感度圖。顏色代表解析概率,並非外部實測密度。
圖三在橫軸連續改變 B 的資料年齡,在縱軸改變其他未讀信被讀取的頻率。若 B 年齡沒有跨過 A 與刷新時間形成的臨界值,即使提升讀信率也不會由快照倒退製造正跳;這是左側零概率帶的原因。臨界值以右,兩種參數在泊松均值 m=λ_r(L_B−t_r−L_A) 中相乘:相同的時間差在高事件率下對應更多舊快照遺漏事件,而相同事件率在更長的快照間隔內亦會累積更多差異。圖像右上角接近飽和,是泊松尾部的自然結果,並不表示工程上存在一個突然崩潰的硬閾值。
敏感度圖的一項實用啟示是,比起僅檢查刷新發生多快,設計者更應關心刷新資料是否保持不早於使用者剛看過的版本。在這個模型下,即使畫面於刪除後 0.15 秒便有新的網絡回覆,如果回覆其實代表兩秒前的已讀狀態,視覺更新依然可能比原來的顯示更落後。相反,若一次刷新等待稍長但能取得不比原畫面更舊的已讀狀態,則反彈機制被結構性切斷。當然,讓使用者等待一個足夠新版本存在代價,本文未給出真實的延遲分布,故不聲稱存在普遍最優等待秒數。
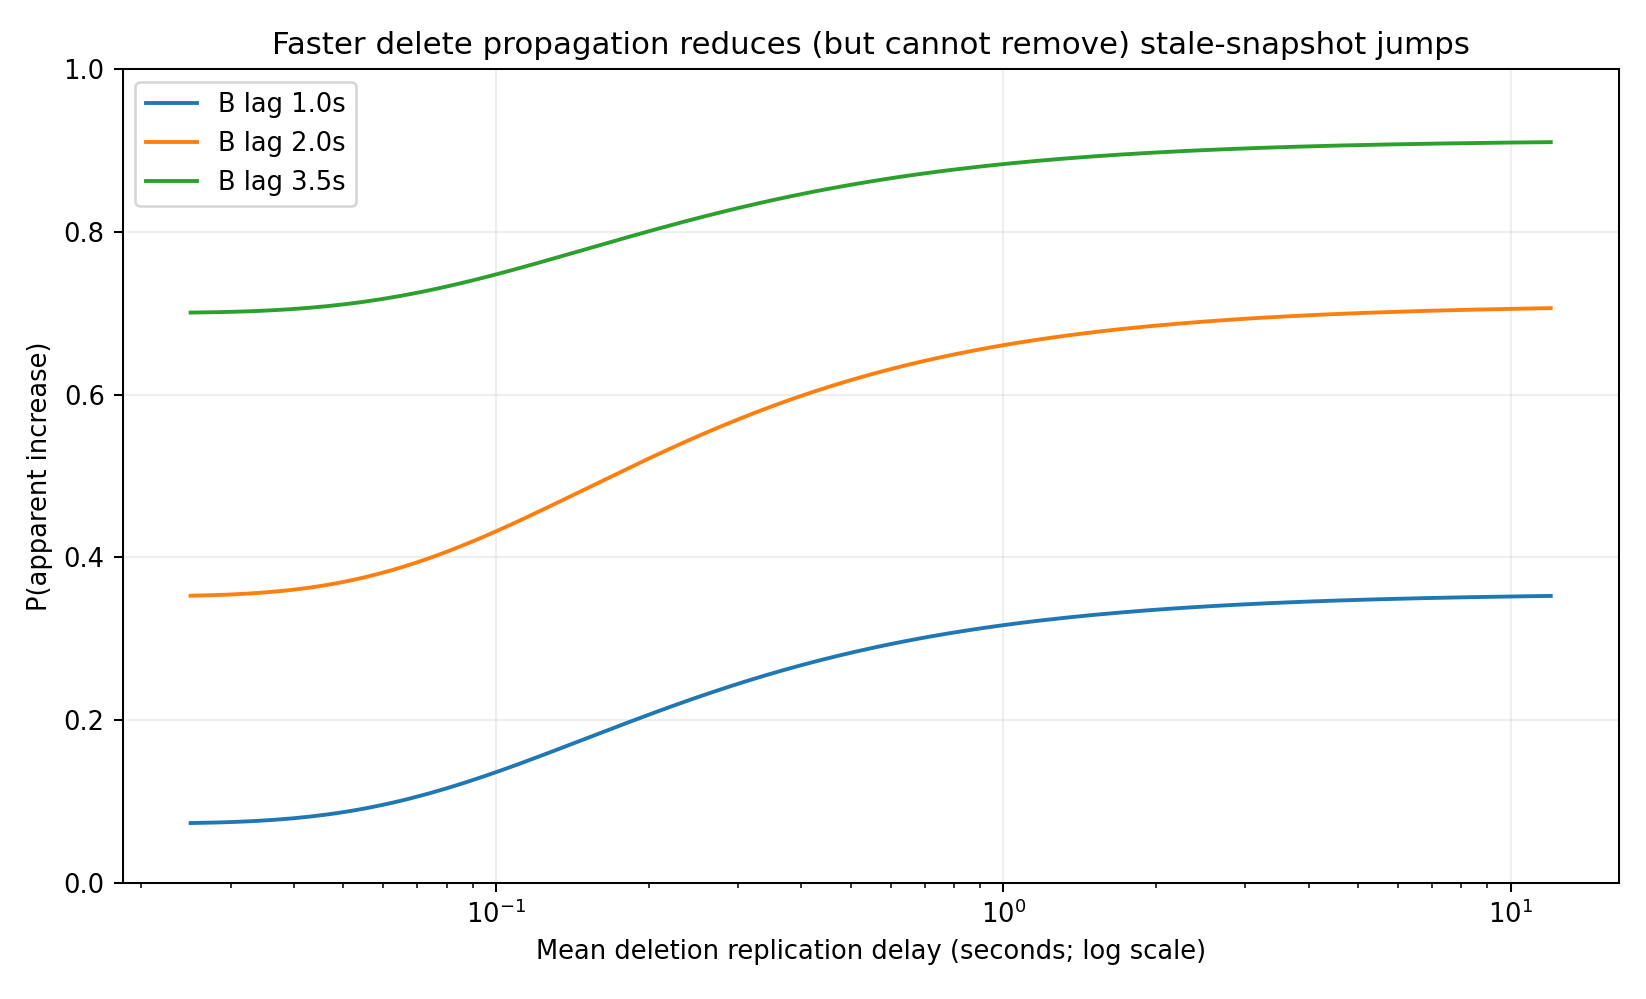
圖 4. 三種 B 快照年齡下,刪除更新的指數平均傳遞延遲改變時的解析反彈概率。橫軸為對數尺度,其他參數維持基準設定。
圖四讓刪除通道的貢獻獨立可見。當 τ_d 很短,刪除幾乎必定在刷新前送達,故只有 K 至少兩筆時才能反彈;當 τ_d 很長,刪除幾乎必定來不及送達,只需 K 至少一筆便可能反彈。這是一個連續變化,不存在「傳遞過了一秒便突然失效」的門檻。對各種 B 年齡曲線而言,快遞送刪除會改善概率,但不能抹去舊已讀快照帶來的所有差異。若政策只加快刪除事件、對舊快照覆蓋完全放任,便可能得到一個更快卻仍然錯亂的可見數字。
分析還可比較兩種干預的數學界限。方案甲保證 g≤0,等於消除這一類由版本倒退產生的反彈,概率精確為零;方案乙只提高 d 至一,則剩餘概率為 1−(1+m)exp(−m),在 m>0 時仍為正。前者的效果較強,因為它直接阻止舊版本重現;後者只是讓新刪除事件抵消一筆遺漏的已讀轉換。這不是說每一種真實系統都應優先採用甲,因為甲可能需要更長等待、會話黏著或更複雜的版本追蹤,而乙也可能是實用且成本較低的優化。模型提供的是機理比較,不是完整成本效益評估。
12. 對照情境:真的有新郵件時,「不准增加」會怎樣
基準模型中完全沒有新信流入,因此正向差值可以被視為舊快照造成的顯示矛盾。若把這個條件直接搬到真實郵件系統,便可能把真正的新增信件錯誤地視作不准出現的異常。本研究另外構造一組合成情境,假設刪除已在一致的資料來源上成功執行;刷新時間延長至一秒,新信抵達按強度 a 的泊松過程生成,其餘郵件被標記為已讀按每秒 0.2 次的泊松過程發生,兩者相互獨立。此時真實未讀數相對刪除前的變化為 N_new−N_read−1。
在此制度下,即使刪掉一封未讀信,只要同時抵達的新信超過已讀轉換加一,真實未讀數也會增加。當 a=0 時,由於沒有新郵件,強制最多負一不會抹去正確的正向變化;但 a 一旦大於零,就有非零概率出現至少一封新信。在被刪信之外無其他已讀事件發生、恰好新到一封時,真實差值等於零,而 guard 仍顯示減一,已經少報一封。可見只統計「有否壓住正數」仍會低估這項補丁的問題,因為它連真正應維持不變的數字也可能遮住。
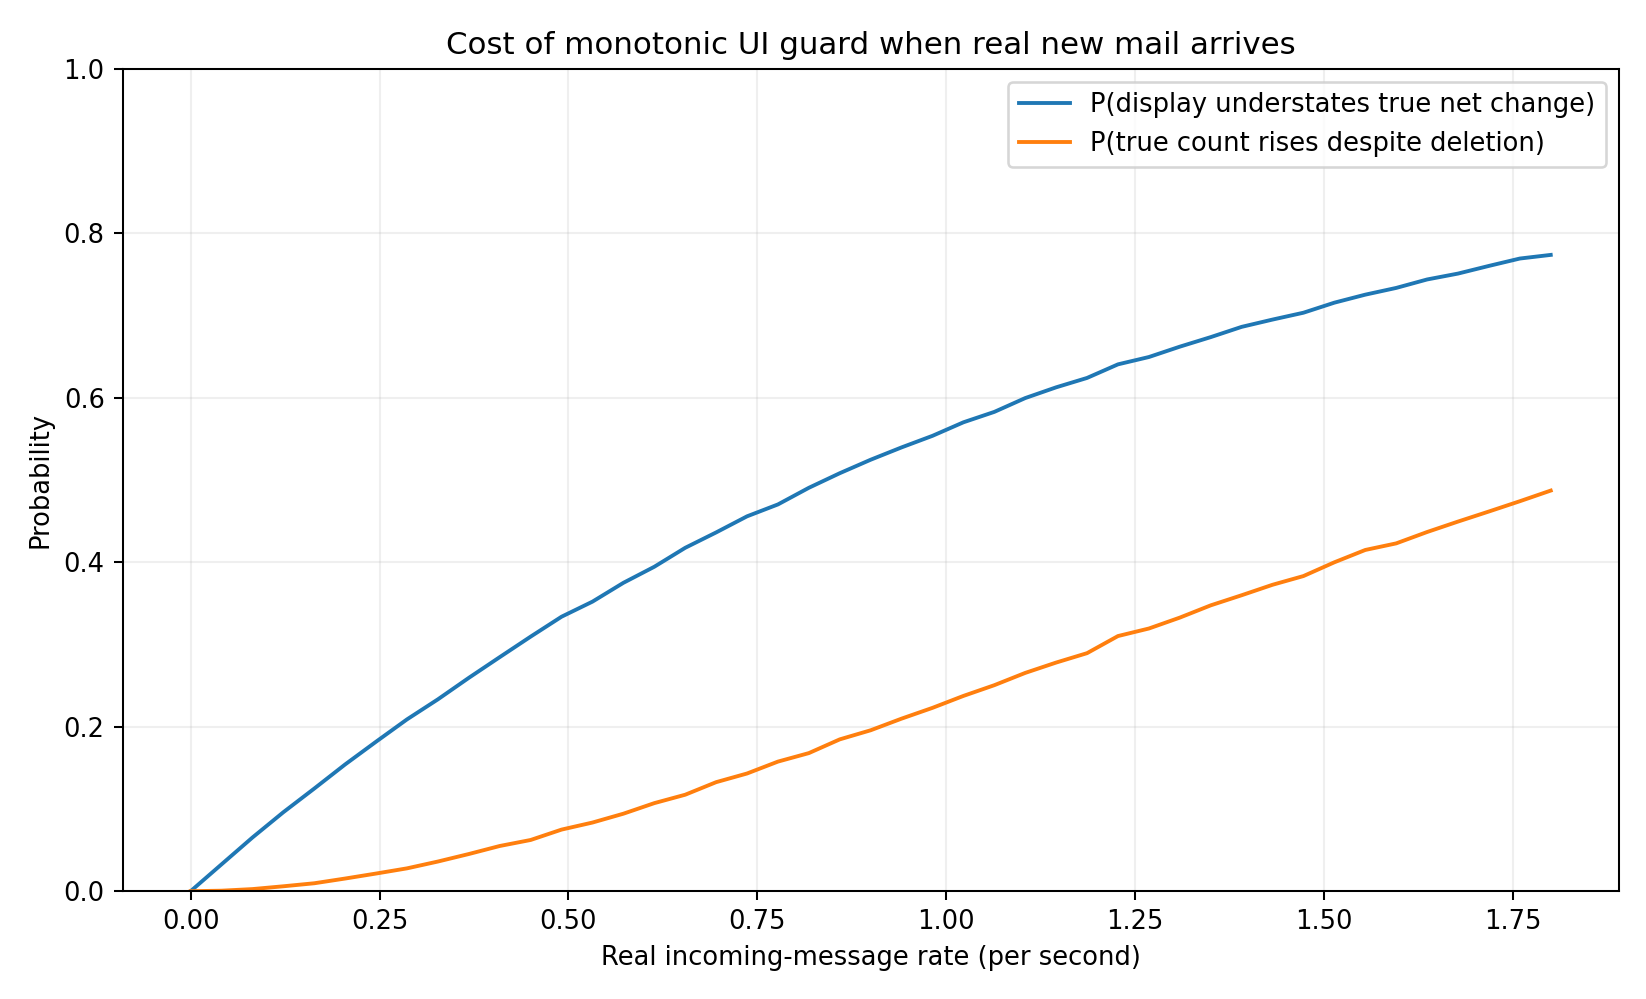
圖 5. 在獨立的新信到達情境下,強制負一顯示低報真實淨差值的機率,以及真實淨計數上升的機率,兩者都由合成試驗估算,不能視為產品實測。
圖五的第一條曲線精確定義為「顯示差值低於真實淨差值」的事件,即 true_change − display_change > 0,等價於真實淨差值大於負一;第二條曲線把「刪除後真實數字仍上升」視作淨正增長。第一條曲線通常較高,因為真實數字回到原值也會被硬性負一規則否決。例如 a 約為 0.9 次/秒的試驗中,模擬的低報事件比例約為 0.5248,但淨正增長比例約為 0.1957。這兩個值定義不同,不宜理解為同一量的兩種估計。當 a 增大,模擬兩條曲線的增加顯示了硬性遞減顯示與真實動態郵箱之間的制度衝突。
這個新信情境刻意採用與基準不同的更新機制:刪除已在一致資料來源上生效,沒有額外的舊 B 已讀快照切換。如此設計才能單獨揭示 guard 自身的缺陷,而不會同時混入兩種不同造成計數變化的機制。相應代價曲線不是「原本六成七反彈率經工程優化後變成多少」的直接比較,亦不是建立可行的機器學習分類器。它是一個反例測試,證明從基準條件下的完美遮掩,無法推出任何有新信抵達制度下的正確性。
13. 討論:修正介面需要版本語義,而不只是漂亮動畫
本研究最重要的洞見在於「計數錯覺」不必來自算術錯誤。每一封舊郵件被標記已讀,只會令正確的未讀集合縮小;被選中的未讀郵件被刪除,也只會令集合縮小。若把不同時刻、不同通道的派生數字拼接為一條畫面時間線,使用者卻能看見正跳。這與數學上同一個集合在單一全序歷史中突然增大不是同一命題。研究從一個日常玩笑出發,實際解釋了分散式系統中可見順序、資料版本與狀態轉換之間的差異。
若系統架構容許修改,第一項可考慮的方向是會話版本約束。當客戶端已看見某個資料版本,之後不接受低於該版本的相同來源派生統計;或者把計數和其來源事件序列標示在同一個版本上。這比單純檢查「數字有否增加」更有意義,因為版本較新的資料可以因新增郵件而出現合法增長。其可行性仍取決於版本序列是否可比較、是否有共同順序、不同資料夾或不同副本的版本令牌如何定義。本文沒有系統設計與負載實測,不能承諾這種做法沒有成本。
第二項方向是針對操作本身提供因果可見性。收到刪除成功的確認後,客戶端可以在畫面上把相應對象標記為已刪,再根據後端確認的事件序列整合新信與已讀事件。相較於對整個未讀整數做「最小值減一」,對有身份的信件事件進行去重和確定性合併,較有可能保留真正新信抵達的資訊。不過,若後端從未告知刪除對象是否未讀、刪除是否可以撤回、會否涉及同一對話串多封郵件,客戶端仍可能算錯。介面正確性需要語義契約,而不是一條局部算式便能無條件解決。
第三項方向是讓系統暴露不確定性。若刷新回覆的資料新鮮度低於剛剛展示的版本,可以暫緩改動計數、顯示同步狀態,或者把未知的數字明確標為暫存值。這種方式可能減少誤導,卻可能犧牲即時性並令操作看起來較慢。假設使用者急需知道一封新信是否抵達,過度凍結計數本身也可能造成傷害。因此評價介面方案需要同時量度錯誤顯示時間、真正新信被隱藏的機率、刷新延遲、連線成本和使用者理解,而不只追求「每次刪除後都下降」一項漂亮指標。
第四項方向是對派生統計建立不變量測試。研究者可設計合成事件序列,包含刪除、已讀、回復未讀、異步新信及快照切換,並要求介面對每個可確定版本有可追溯的計數。特別應測試「刪除已送達但已讀快照尚未更新」、「客戶端先行樂觀扣減而後端操作失敗」、「同一刪除事件重送」、「新信與刪除同時發生」等情境。本文現有程式只研究第一類的簡化子情境及新信補丁反例,並未通過完整產品級事件重播測試;提出這些測試是未來工作的規格建議,不能當作已實施成果。
本研究的概率數字很大,容易產生宣傳式誤讀。六成七左右並非某郵件應用的故障率,而是我們故意選擇高已讀事件率、相差一點五五秒的兩個快照、以及刪除平均延遲一點五秒的結果。若使用者一分鐘只標記數封信為已讀,或者資料快照有會話一致性保證,概率可能與本文基準差天共地。研究有意選擇足以展示悖論的壓力條件,但並不透過數值戲劇性掩飾生成機制的人工性。用作教學例子時,應把參數、資料類型及限制與數字放在同一頁。
14. 研究限制、識別問題與外部效度
第一項限制是完全沒有真實觀察資料。本研究沒有獲授權的郵件服務日誌,沒有系統提供者的設計文件,沒有多裝置同步實驗,也沒有量度網絡延遲、事件批次或使用者讀信速率。所有統計只能在明確寫下的生成機制中成立。把合成頻率連同蒙地卡羅標準誤換算成真實故障率信賴區間,是方法學錯誤;就算模擬再增加一百倍,也只能縮小已知模型的抽樣噪聲,無法證明模型符合現實。
第二項限制是時間與事件獨立性。真實使用者會一次標記多封信、在通勤時停止閱讀、在不同裝置同時操作;網絡傳遞延遲亦可能因負載或連線狀態與刷新時間共同變動。若 K 分布過度離散、具有批次群聚或與 I 正相關,本文的乘積機率會改變。較合理的下一步應是先做追蹤數據描述,再比較泊松、負二項、更新過程或自激點過程的擬合程度。沒有資料支持前,不應說本研究證明泊松是「自然」或「最常見」的郵件事件模型。
第三項限制是派生快照語義。我們為避免物理時間矛盾,特意假設舊的已讀狀態快照與較新的刪除覆寫可以分通道合併。這種構造可以存在,但它不是所有分散式系統的普遍結構。若資料庫保證所有欄位由一個可序列化的交易快照取得,或者在會話內拒絕較舊版本,K−I 所代表的畫面組合可能根本不會被輸出。若讀寫事件在同一個完全有序的串流上執行,也要重新處理快照截點與刪除時序,而不能照抄第六節的概率。
第四項限制是選定被刪信必定原本未讀。使用者有時刪的是已讀信,有時在其他裝置已讀而本地仍顯示未讀,有時郵件包含多個訊息並以對話數量計數。不同產品甚至可能把未讀徽章定義為「符合查詢條件的對話串數」,而不等於未讀訊息封數。這些語義差異足以改變刪除的即時影響及任何正跳的解釋。只有把實際計數契約列入觀察設計,才可能由畫面異常反推底層更新機制。
第五項限制是可見性與因果識別。假設有人確實錄影拍到刪除後未讀數增加,仍不足以識別快照倒退為唯一原因:新信抵達、遠端裝置改為未讀、搜尋條件刷新、客戶端重算或網絡重送均可能造成相似畫面。要區分這些因素,需要同步紀錄實際事件 ID、資料版本、請求與回覆時戳、伺服器追蹤和刪除確認狀態。只從兩張截圖倒推出某個公式的參數,屬於辨識不足;本研究的解析性不等於對觀察成因的唯一解釋。
15. 結論與後續研究
本文在一個有完整假設、具固定種子且可重現的合成框架中,證明先展示較新快照,再展示較舊的已讀狀態加異步刪除覆寫,可以令未讀計數在刪除後反而增加;即使期間完全沒有新郵件,這種畫面差值亦可能為正。此結果沒有違反集合計數的基本算術,因為所比較的不是同一份權威狀態前後兩個按因果排序的版本。精確概率由被較舊快照漏掉的已讀事件數 K 與刪除是否已傳遞的指示 I 決定,對應 P(K−I>0)。基準計算的 0.676468 與固定種子模擬的 0.674983 在抽樣誤差內吻合。
敏感度結果表明,舊快照的年齡及背景已讀事件率能共同放大顯示反彈,而提高刪除事件送達率只可抵消一部分舊快照造成的差距。強制負一的介面補丁可以在沒有新信的基準下完全消除表面反彈,但在新信抵達時可能壓抑合法計數更新。因而較合理的研究方向,是設計可以追蹤版本和因果關係的會話資料讀取與顯示規則,並把介面新鮮度、操作確認、實際等待時間與錯誤隱瞞一起納入驗證。
後續研究首先應建立獲授權的匿名事件資料集,以便評估新舊快照差距是否真的存在、讀信到達過程有否批次性,以及刪除傳遞是否與讀取通道相關;其次應比較具有單調讀取保證的客戶端、版本化計數器和基於實體郵件狀態重算的實作成本;最後可設計人因實驗,檢驗使用者究竟較信任暫時標示「同步中」的畫面,還是出現短暫回彈但保留真正新信的畫面。上述工作均未在本文完成,不能由本次合成分析預先斷言最佳產品選擇。
這項研究以最嚴肅的概率公式分析「為何按減號卻見到加號」的荒誕情境;數學答案是資料版本可以倒退、事件覆寫可分通道,而人的眼睛只知道哪個畫面最後出現。若不先問「這個數字代表哪個版本」,任何對正負一的直覺判斷都可能沒有真正比較同一個對象。
參考文獻
Gilbert, S., & Lynch, N. (2002). Brewer's conjecture and the feasibility of consistent, available, partition-tolerant web services. ACM SIGACT News, 33(2), 51–59. https://doi.org/10.1145/564585.564601
Lamport, L. (1978). Time, clocks, and the ordering of events in a distributed system. Communications of the ACM, 21(7), 558–565. https://doi.org/10.1145/359545.359563
Shapiro, M., Preguiça, N., Baquero, C., & Zawirski, M. (2011). Conflict-free replicated data types. In Stabilization, Safety, and Security of Distributed Systems (pp. 386–400). Springer. https://doi.org/10.1007/978-3-642-24550-3_29
Terry, D. B., Theimer, M. M., Petersen, K., Demers, A. J., Spreitzer, M. J., & Hauser, C. H. (1995). Managing update conflicts in Bayou, a weakly connected replicated storage system. ACM SIGOPS Operating Systems Review, 29(5), 172–182. https://doi.org/10.1145/224057.224070
Vogels, W. (2009). Eventually consistent. Communications of the ACM, 52(1), 40–44. https://doi.org/10.1145/1435417.1435432