摘要
多人合作中,一次承諾未能兌現可能來自故意拒絕,也可能發生在有誠意嘗試的情況下。若旁觀者僅看見成功或失敗,將所有失敗等同故意背約會排斥合作可靠但偶爾出錯的人。本文承接 HOK-011,取消其「履約嘗試及外生失敗原因可公開區分」的資訊假設,提出兩種隱藏固定類型、交付二元訊號及假設性帶噪聲審核的有限期貝葉斯決策模型。研究者明確指定誠信型與機會主義型的條件交付概率,推導累積證據的後驗勝算、合作/審核/停止三動作的 Bellman 方程,並證明最適性、先驗價值的分段線性凸性、較高審核資訊品質的弱價值改進,以及有限證據無法完全排除錯判。基準合成設定為八輪、折現率 0.9、誠信型交付概率 0.9、機會主義型 0.35、先驗 0.5;精確混合最適折現收益為 2.0837,高於首次失敗即排除規則的 1.7288。誠信型遭到提前停止的條件概率由 0.5217 降至 0.07695;但在不誠信類型上,最適政策可承受較低的類型條件收益,不能誤稱所有類型都受益。40,000 條每類型的固定種子合成路徑與解析期望相符,255 個獨立有理數樹節點最大比較誤差為 1.33×10⁻¹⁵。另以單期策略冒充作反證式誘因測試:在 33 個可到達的合作節點中,19 個具有正冒充邊際收益,顯示固定類型更新規則若容許策略操控,不能直接視為序列均衡。本文的貢獻是把誤判、資訊取得及模型失配在一套可重現框架中同時量化,而非宣稱發現《王者榮耀》的真實玩家聲譽規律。
**關鍵詞:**貝葉斯聲譽;不完全資訊;部分可觀測決策過程;審核價值;錯誤排斥;策略操控
1. 引言:失敗紀錄如何扭曲合作
在多人競技合作中,隊友可能口頭約定彼此支援、輪流放棄某次優先資源機會,或在特定局勢優先保護另一人。此類互惠不需要遊戲真的存在貨幣合約,也不需要官方設置可供查詢的信用分數;其最低限度只要求合作方對未來某個合作動作抱有期望。一次行動無法實現,可能反映刻意不合作,也可能是視野不完整、偶發干擾或場景限制所致。在只有結果記錄的環境,外界無法直接觀察內在意圖,故後續合作需要根據歷史不完全證據決定。
HOK-011 的雙邊履約模型提供動態自我強制條件,但特別假定 B 的誠信嘗試、失敗原因及故意拒絕均可公開核實。這種區分使得對蓄意背約的永久懲罰容易定義,卻也令聲譽判斷的核心統計問題消失。本文把「故意/外生」合併成一個公開結果:只見交付成功 D 或未交付 F。B 的固定隱藏類型代表當前比較穩定的交付可靠性,A 則根據每輪資訊選擇合作 C、支付代價作獨立審核 A,或停止合作 S。這個抽象情境有助研究容錯與資源損耗的邊界,但不對真實排位中任何特定英雄或版本機制作經驗主張。
研究問題(Research Questions)分成四項。RQ1:在同時容納無辜失敗及故意背約的生成分布下,公開觀察如何累積成可以充分表示歷史的後驗聲譽?RQ2:有限剩餘輪數與折現成本如何共同決定合作、取得新資訊以及退出的最適動作?RQ3:使用後驗政策是否可以減少誠信型的錯誤排斥,同時限制對低可靠性對象的接觸?RQ4:當被觀察者可花成本模仿誠信型時,固定類型模型的最適政策是否仍具誘因相容性?
研究目標(Objectives)是導出可公開複製的後驗公式與完整有限期策略,提供必要的定理與證明;以類型條件概率而非只以總平均值衡量錯誤排斥;驗證數值演算法及提出可否延伸為內生策略均衡的檢查。可反駁假說 H1:後驗會隨正向證據上升、隨負向證據下降;H2:有限期資訊審核可在部分信念與期限下優於立即合作或退出;H3:最適政策的先驗混合收益不低於首次失敗即退出的政策,卻不一定改善每一真類型的收益;H4:給定的固定類型信念更新若忽略策略冒充,部分合作節點會出現正的模仿誘因。H1–H3 將以推導和精確數值檢查;H4 是對固定類型規格的失配診斷,不以觀察到正誘因直接宣稱特定均衡存在。
本文的研究貢獻(Contributions)有三項:其一,以四個足夠統計量縮減觀察史,讓讀者由任何公開路徑重算後驗;其二,分離最適政策的先驗福利、誠信型的錯排率及機會主義型的持續接觸成本,使容錯並非單一指標;其三,為固定類型的後驗最適策略加入可檢算的一期模仿檢驗,明確標出從最適控制推論到博弈均衡所缺少的內生策略條件。
2. 文獻回顧與理論定位
Green 與 Porter(1984)以不完美價格訊號下的動態合作指出:即使參與者沒有故意違規,壞的公開訊號仍可能觸發集體懲罰。這種對噪聲的不可歸責性提醒我們,單次失敗不能被當作意圖的無誤標籤;然而他們的產業合謀模型不同於本文的固定隱藏可靠性類型,故其均衡結論不會自動適用。HOK-011 則分析履約嘗試可驗證時的重複互惠,本文特意刪除這一強資訊條件,並不重算它的雙邊努力激勵不等式。
Kreps 與 Wilson(1982)論述不完全資訊如何使歷史影響聲譽與跨期策略;Milgrom 與 Roberts(1982)亦研究在潛在對手逐次反應的情境中,建立聲譽何以有戰略價值。這兩篇均強調對手會因預期未來行動而選擇目前行動。本文第一層刻意採取被觀察者的類型條件分布固定不變:這讓後驗控制問題可以精確求解,但不是完整的策略聲譽均衡。第 8 節將明示此限制,計算被觀察者偏離時可能得到的額外延續租值。
Smallwood 與 Sondik(1973)在部分可觀測馬可夫決策過程(Partially Observable Markov Decision Process, POMDP)中分析有限期限下的價值函數。本文的未見狀態僅有 H、O 兩種固定類型;信念是其連續分布的一維座標,屬有限期 POMDP 的特例。作者使用的是能由離散歷史精確枚舉的簡單模型,而非援引一般定理來省略計算。本文將明確證明價值函數對先驗信念的分段線性凸性,並逐條比較實際 Bellman 選項。
相關文獻解釋聲譽、有限觀察與懲罰的理論來源,但未提供本文特定八輪參數的實測校準。本文在文獻中找不到「《王者榮耀》中有獨立審核對方誠信類型的官方功能」的已核實證據,因此審核只是反事實實驗:它可以被理解為額外的、有代價的外部可靠性訊息,但絕不可當成遊戲已存在的操作。
3. 問題設定、符號與資訊結構
在有限離散期 t=1,...,T,A 面對同一個隱藏類型 θ∈{H,O} 的合作對象 B。真類型在整段期內固定,不因每輪機率抽樣改變。先驗 Pr(θ=H)=π∈(0,1)。如果 A 選擇合作,當輪付出 c>0 的機會成本;若成功交付,A 取得 v>0 的增量收益;若失敗,取得零交付收益但仍支付 c。H 類交付成功概率 q_H、O 類交付成功概率 q_O,且 0<q_O<q_H<1。條件於 θ,歷次交付成功獨立。給定對象為 O,交付失敗的統計生成率相對較高,但不等同每次失敗都為主動背約。
若 A 選擇「審核」,支付 k>0,當期放棄合作,取得獨立的二元訊號 + 或 −。假設 Pr(+|H)=α、Pr(+|O)=β,0<β<α<1,且各次審核條件獨立於歷次交付與其他審核;這是強烈、尚未驗證的統計假設。若選擇停止,這段抽象關係終止,剩餘期限的增量效用歸零;本期亦不產生收益。所有觀察、當期結果及後續決定公開,但真類型一直隱藏。每期僅採一個動作,沒有同一期審核並合作的選擇。
| 記號 | 意義與範圍 | 基準假設數值 |
|---|---|---|
| θ,π | 固定隱藏類型;Pr(H)=π | H/O;0.50 |
| q_H,q_O | 合作成功的類型條件概率 | 0.90;0.35 |
| α,β | 審核 + 的真陽性及假陽性 | 0.80;0.20 |
| v,c,k | 交付價值、合作成本、審核成本 | 5;3.2;0.15 |
| δ,T | 折現因子;最多決策輪數 | 0.90;8 |
| (s,f,a,b) | 成功/失敗/審核正/審核負的累積次數 | 起始均為 0 |
| z,V_t | 當前 Pr(H | 史);剩 t 輪最適價值 |
表 1:所有金額均為無物理單位的假設增量效用,所有概率均為作者指定的合成參數,非玩家調查估計。行動 S 對應永久停止,審核 A 和參與者 A 的命名須由上下文分辨。
為避免將使用中途多次查看觀察當作多輪,我們把時鐘定義為「每次動作之後剩餘輪數減一」。審核同樣消耗一個完整合作機會;停止時 t≥1 算作在有效剩餘期內提前排斥,若第 T 輪合作失敗而沒有後續決策,則不算已遭提前排斥。錯誤排斥(wrongful exclusion)嚴格定義為 Pr(有剩餘決策期而選 S | θ=H)。對 O 的停止概率不稱作錯誤排斥。這種因果順序決定了後面的風險指標,不能以「任何一次 F 曾出現」代替實際 S 動作。
本研究的一輪可對應隊友彼此承諾一次抽象的合作機會,不是遊戲正式機制。交付結果當期可以共同看到、但無法知道真正原因;審核結果也只是一種假設性額外線索。參數沒有對英雄、地圖、賽季改版、玩家行為或遊戲配對規則作適配。所有結果僅在同一對象重複互動、先驗共同知識、訊號條件獨立以及收益風險中性的範圍內成立。將模型搬到不同排位環境,首先必須收集合法觀測並檢查假設。
4. 貝葉斯後驗與公開充分統計量
記成功次數為 s,失敗為 f,審核正訊號為 a,審核負訊號為 b。歷史在 H 類型下的似然是 q_H^s(1−q_H)^f α^a(1−α)^b;在 O 類型下為 q_O^s(1−q_O)^f β^a(1−β)^b。使用貝葉斯定理,直接從似然比得出如下的後驗勝算(posterior odds):
此式說明四個計數而非完整先後次序就可以重建對 θ 的全部證據。成功時勝算乘 q_H/q_O>1,失敗時乘 (1−q_H)/(1−q_O)<1;審核正訊號乘 α/β>1,負訊號乘 (1−α)/(1−β)<1。它不表示有任何單次結果能確定意圖,只表示觀察較符合哪一類概率模型。乘法在長歷史可能下溢,因此程式在 log-odds 空間相加,最後使用 logistic 函數還原 z。
命題 1(路徑充分性、方向與非退化後驗)。 在固定類型、已知概率且條件獨立的假設下,任意兩個公開歷史只要具有相同 (s,f,a,b),其後驗 z 及所有未來最適決策問題均相同;若 π∈(0,1) 且各訊號似然嚴格位於 0 與 1 之間,任何有限歷史仍有 0<z<1。成功及正審核使 z 嚴格上升,失敗及負審核使 z 嚴格下降。
證明。 相同四計數令上述兩種類型的歷史似然相同,與其順序無關;在條件獨立環境,未來事件只取決於 θ 與當前行動,故充分性成立。後驗勝算由有限個嚴格正的因子相乘得到嚴格正且有限的值,於是 z 在開區間內。log-odds 各次的更新量分別為 ln(q_H/q_O)>0、ln((1−q_H)/(1−q_O))<0、ln(α/β)>0、ln((1−α)/(1−β))<0。logistic 嚴格遞增,所以方向如述。證畢。
基準先驗 z=0.5 下,一次成功使後驗變為 0.7200;一次失敗降至 0.1333;一次正審核升至 0.8000,負審核則降至 0.2000。這些數字都可以直接以條件概率分數算出。注意 H 即使願意交付,單次失敗概率仍是 0.10,觀察失敗後的低後驗並不能證明該次一定故意背約。
5. 最適決策與數學性質
定義 V_t(s,f,a,b) 為剩下 t 次動作、目前尚未停止時的最大期望折現增量效用,V_0≡0。當前條件成功概率 w(z)=zq_H+(1−z)q_O;正審核概率 u(z)=zα+(1−z)β。選擇合作時即時條件期望是 vw−c,續存的兩個後繼值各按 w、1−w 混合;選審核則本期支付 k,續存的兩個後繼值各按 u、1−u 混合。停止立即歸零。
我們以固定 tie-break C 優先於 A、A 優先於 S,使每個歷史都有可重現的唯一行動;在相等時不同打破平手規則不影響最適價值,但可影響錯排率。若 t=1,審核只產生成本而沒有剩餘期可使用訊息,因此 Q_A=−k<0;合作只在 w≥c/v 時優於停止。給定基準值 c/v=0.64,單輪合作門檻為 z≥(0.64−0.35)/(0.90−0.35)=0.527273。初始 z=0.5 因而在單輪下選停止,但在八輪環境因可學習與保留未來獲益,第一輪卻選合作。這是期限改變即使本輪即時淨收益為負,也可能正當地啟動試探性合作的例子。
命題 2(有限期 Bellman 最適性)。 在第三節假設下,從 V_0=0 按上面三行遞推,對任意 t=1,...,T 與任意可行公開歷史,都可求得 A 的全策略最優值;依 Q 的最大值選動作組成完整的歷史依賴最適政策。
證明。 t=0 時已無可選收益,值函數為零。假設對剩餘 t−1 期,每種後續歷史的 V_{t−1} 已是最適。任意 t 期策略必先從 C、A、S 擇一;固定首動作後,條件期望依觀察分割,再由歸納假設以各自的 V_{t−1} 續接最佳行動,於是三個首動作的最佳期望恰為 Q_C、Q_A、0。取最大值即得 V_t,且每階段的 argmax 构成可執行最適策略。依有限期數學歸納法,所有期數成立。證畢。
命題 3(先驗價值的分段線性凸性)。 在其他參數、剩餘期限與已指定的起始資訊狀態固定時,策略集合有限,從初始先驗 π 出發的最適值 V_T(π) 是 π 的分段線性凸函數。當不同 π 使首動作或後續政策切換時,函數可能有折點但保持連續。
證明。 一項純策略可以對每個有限觀察歷史指定三個動作,且在停止後不用再指定行動。有限期限、有限觀察及有限動作意味純策略數量有限。選定一項不隨真類型改變的純策略 σ,其 H 條件期望收益 U_H(σ) 與 O 條件期望收益 U_O(σ) 均為常數,故先驗混合收益為 πU_H(σ)+(1−π)U_O(σ),是 π 的仿射函數。由命題 2 可選純策略達到最大,於是 V_T(π)=max_σ[πU_H(σ)+(1−π)U_O(σ)]。有限仿射函數上包絡必然連續、分段線性而凸。證畢。這一理論特性可用來檢查先驗掃描的數值相圖是否出現不合理的非凸波動。
命題 4(較高品質審核的弱價值優勢)。 保持審核成本與其餘模型參數不變,且審核為對稱二元訊號,Pr(+|H)=γ、Pr(+|O)=1−γ,1/2<γ<1。若 γ₂>γ₁,則對任意先驗與期限,γ₂ 環境的最適混合收益不低於 γ₁ 環境的最適混合收益;個別類型的錯排概率不保證單調。
證明。 對 γ₂ 審核結果以與類型無關的概率 ρ 翻轉 + 與 −。有效正確率成為 γ₂(1−ρ)+(1−γ₂)ρ。令 ρ=(γ₂−γ₁)/(2γ₂−1),在所給條件下 ρ∈[0,1/2],即可使有效率等於 γ₁。擁有 γ₂ 訊號的決策者可自行隨機翻轉而模擬 γ₁ 的所有可觀測歷史和其後動作分布,故其可達策略集合包含較低品質制度的模擬政策,最佳值不會更低。惟最佳值以先驗加權,並未個別約束兩種類型錯判率,所以不導出 H 型錯排率的普遍單調性。證畢。
命題 5(延長期限的選擇權)。 若每輪仍可自由停止且停後外部價值為零,對相同當前信念而言,V_{t+1}≥V_t≥0。額外一期不必嚴格提高價值。
證明。 停止保障非負下界。t+1 期決策者可以模仿 t 期決策者的全部行動及必要時停止;較長期的動作可以至多做 t 次,因此可行策略集合包含原有 t 期策略。取最大值得弱不等式。當任意可行合作均使期望價值不正且不值得審核時,兩期同可取立即停止,故無須嚴格大於。證畢。
命題 6(有限觀察不提供完美身分判斷)。 若每一二元訊號的兩種條件可能性均嚴格正,且起始信念非退化,有限步驟無法得到「H 的後驗恰為 0 或 1」。更進一步,任何於 O 類可正概率到達的有限歷史,在 H 類也有正概率,故若該歷史觸發提前停止,就存在 H 類錯誤排斥的正概率。
證明。 第一部分已由命題 1 的嚴格後驗界給出。對任意有限行動、觀察歷史,其在 H 及 O 類下的路徑概率皆為有限個嚴格正因子的乘積;政策的動作由歷史決定,不會讓其中一類的相同路徑概率變成零。若在該歷史因 t≥1 進行停止,則此歷史屬兩種類型下均有正概率的停止事件,故 H 錯排率為正。此說法是特定停止歷史的必要後果,不意味每種政策都有錯排;永不停止的政策錯排率可為零。證畢。
6. 數值實驗設計與獨立驗證
由於未獲得獨立合法取得及適合因果歸因的遊戲玩家資料,本文採理論及合成(synthetic)數值研究。參數按「H 比 O 更常成功,但 H 仍可能失敗;審核有一定準確度但需要犧牲本期機會」的研究目的選擇,不以遊戲觀察校準。基準參數已列於表 1。程式使用 Python 3、numpy、matplotlib,以後驗 log-odds 和帶記憶化的 Bellman 遞推枚舉從全新關係出發的有限決策樹。它不以隨機梯度或近似強化學習代替精確有限樹;所有主要表格價值皆為條件期望的確定計算。檢查後才另外使用固定種子 20261015 抽樣模擬每類 40,000 條相互獨立的有限期合成路徑。
比較基準規則是首次交付失敗後立即永久排斥。在首次失敗所在的當輪仍已支付合作成本、觀察失敗;若後續還有決策輪,才在下輪選 S。在該規則中,B 交付成功之前 A 一直合作,不審核,即使最初一輪有負期望收益也不主動停止。這個保守基準沒有經過期限最佳化,所以本研究比較的是「先驗最適控制」對指定啟發式規則的優勢,不能將差額全歸因於貝葉斯更新,也不能稱為任何制度之因果效果。
對真類型 θ 的該基準策略,令 q_θ 為其每次交付概率,則預期折現效用、合作次數及提前排斥概率有閉式:
第二式的推導是:第 j+1 輪仍合作的必要充分條件為之前 j 輪全成功,概率 q_θ^j,故各輪即時期望報酬的折現權重是 (δq_θ)^j;在最後一輪之前只要有失敗,下一輪必觸發 S,事件互補是首 T−1 輪皆成功。即便 H 誠信,其 q_H<1 因而具有正的錯排風險。這一閉式除了檢算基準實驗,也避免把失敗發生在最後輪而其實沒有後續關係可排斥的情況錯誤計算入分子。
本研究的最適控制評估另以真類型分解執行一個獨立的條件概率遞推。在固定政策 π*(t,s,f,a,b) 後,對 H 使用 q_H、α,對 O 使用 q_O、β 遞推實際發生的兩條分支,累積條件折現收益、提前停止概率、預期合作及審核次數。這一層不再使用混合預測概率 w 與 u 作真實路徑的生成概率,因為在評估指定 H 類時,事件概率必須條件於 H。由全概率公式檢查 πU_H+(1−π)U_O=V_T;若此等式失敗,表示評估實作錯誤。
為盡量避免兩份程序擁有同一錯誤,第二支核對程式另外使用 Python Fraction 有理數、由序列逐步相乘重建類型似然,並在每個節點直接利用分數版貝葉斯公式展開全部可能的二元結果。它不呼叫主程式的 posterior 或 value 方法,只將輸出與主程式的浮點值比較。三種先驗 1/5、1/2、4/5,各自涵蓋深度 0–3 的四元結果序列,在總共 255 個歷史節點上連動作選擇亦須一致。數值檢查最大絕對誤差為 1.3323×10⁻¹⁵;此外測試單輪門檻、基準策略可行性及審核準確率比較靜態。這是程式一致性與算術驗證,並不能證明第三節的遊戲情境假設對真實玩家成立。
7. 研究結果:容錯、信念與期限的權衡
表 2 列出八輪初始先驗 π=0.5 的類型條件結果。「價值」是 A 的帶折現效用;提前停止與合作/審核次數則是未折現事件統計,不能將二者相加成同一福利量。所有數值為完整有限決策樹的解析概率期望,並非玩家問卷平均。
| 策略與真類型 | 折現價值 | 提前停止概率 | 預期合作/審核次數 |
|---|---|---|---|
| 最適 Bayes,H | 6.7711 | 0.07695 | 7.3468/0.3047 |
| 最適 Bayes,O | −2.6038 | 0.96767 | 1.9110/1.1006 |
| 首失敗即排斥,H | 5.5742 | 0.52170 | 5.6953/0 |
| 首失敗即排斥,O | −2.1166 | 0.99936 | 1.5381/0 |
表 2:exact synthetic model。H 為誠信固定類型,O 為低可靠性類型。兩個策略按同一收益、折現、交付概率與八輪停止定義評估,只有政策規則不同。
先驗混合最適值為 (6.7711−2.6038)/2=2.0837;固定首失敗基準混合值為 (5.5742−2.1166)/2=1.7288,差額約 0.3548 效用單位。這個差額證明指定模型、指定基準下的可計算優勢;一般理論上的 V 最適性只保證不低於任何可行策略。H 類錯排率降低約 0.44475(44.48 個百分點),但 O 類提前停止率由 0.99936 降至 0.96767,即低可靠性對象較可能再得到一些合作機會。較低的 O 類停止率與更負的 O 類折現價值互相呼應,提醒使用者:寬容從來都不是免費的。相反,H 類因錯排明顯減少,平均合作次數提升,足以令先驗加權總價值上升。
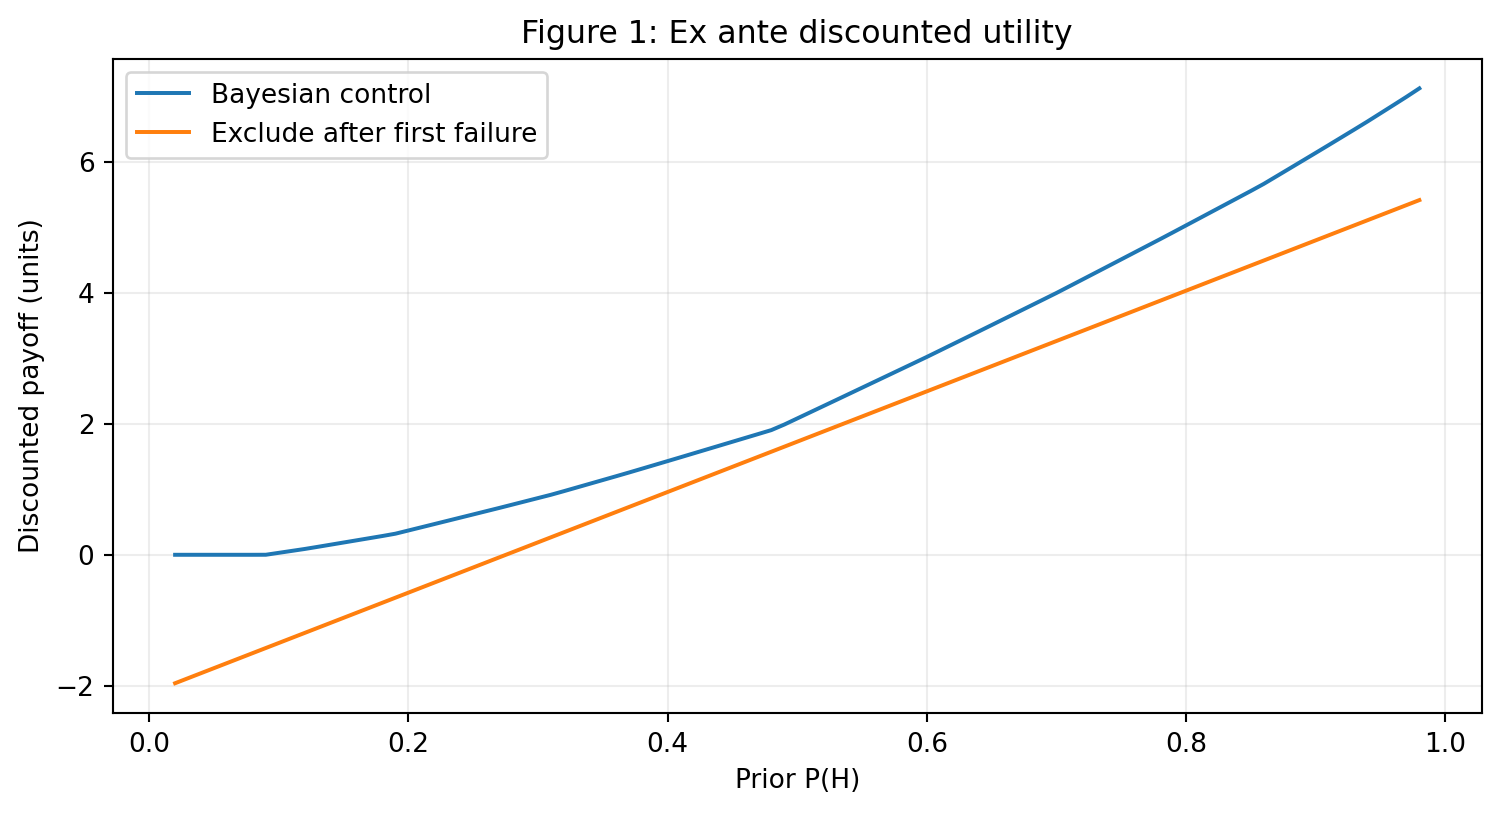
圖 1 的橫軸把先驗 π 在 0.02 至 0.98 共 97 點掃描,其他參數固定;縱軸是每一點重新解 Bellman 的事前值。於 π=0.02,最適選立即停止,價值為 0,仍高於強制合作的負 1.9628;於 π=0.98,最適值為 7.1278,基準為 5.4204。值函數的分段凸形與命題 3 一致:當信念偏向 H,未來合作的相對吸引力上升,但切換邊界由全部續存價值共同決定,不等於固定的 0.527273 單期門檻。
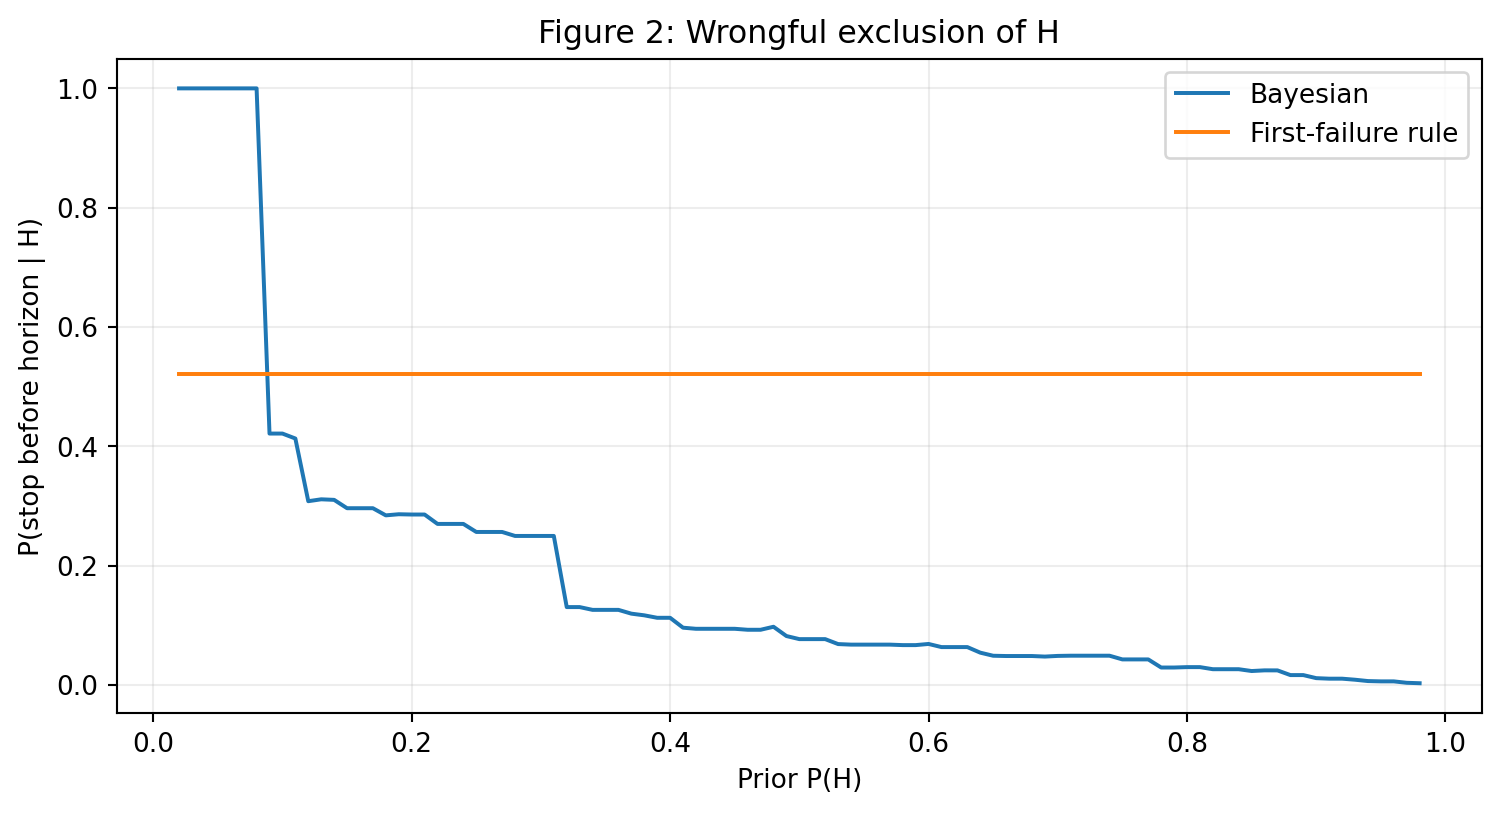
圖 2 呈現重要的非平凡結果:首失敗觸發規則下,H 錯排概率固定為 1−0.9⁷=0.5217031,與先驗 π 無關;最適政策的錯排風險卻可能隨先驗大幅變化。極低 π 時可能在任何觀察之前就拒絕合作,故對假如真是 H 的人錯排概率反而為 1;在基準 π=0.5 時,則大幅低於簡單觸發規則。以最適總價值取代單一錯排損失,必須承認這種先驗帶來的公平性風險;若制度要求對 H 的錯排率最高不得超過某個限度,需要改寫為風險受限決策問題,不能假設本模型已自動滿足該限制。
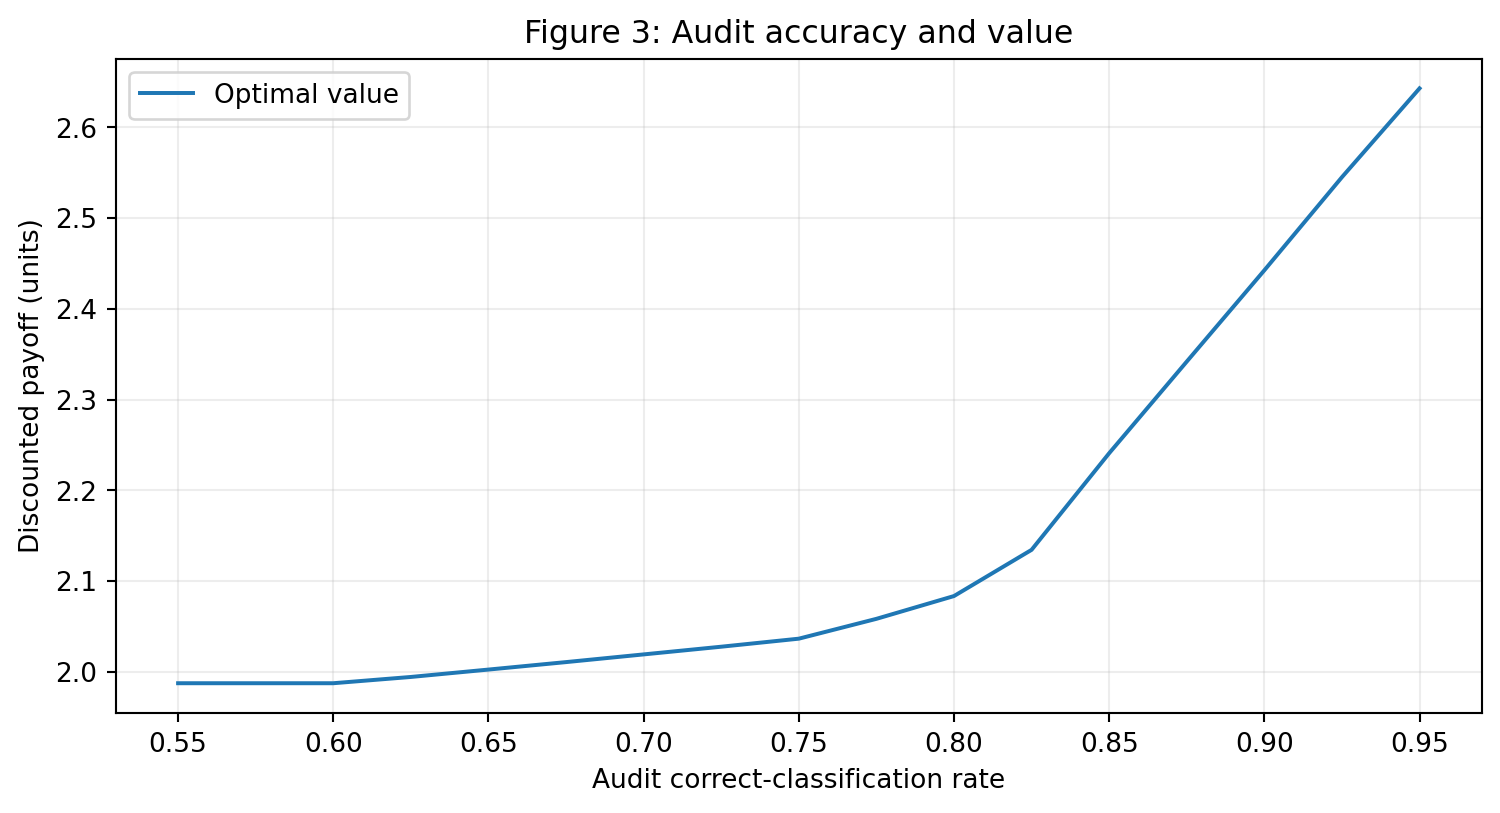
圖 3 固定 β=1−α,將對稱審核正確率從 0.55 提高至 0.95。低準確率 0.55 時,最適價值為 1.9876,當前設定下期望審核次數為 0;其資訊增加小於審核成本,最適政策根本不啟用它。準確率 0.75 時價值為 2.0367,審核期望次數約 0.1683;提高到 0.95 則價值達 2.6429,平均審核次數約 1.5847,首動作也由合作轉為審核。這些數值支持在對稱實驗中較準確審核弱改善總期望價值,命題 4 提供更一般的條件證明;但若審核成本隨準確率一起提高,單調結論不再直接適用。
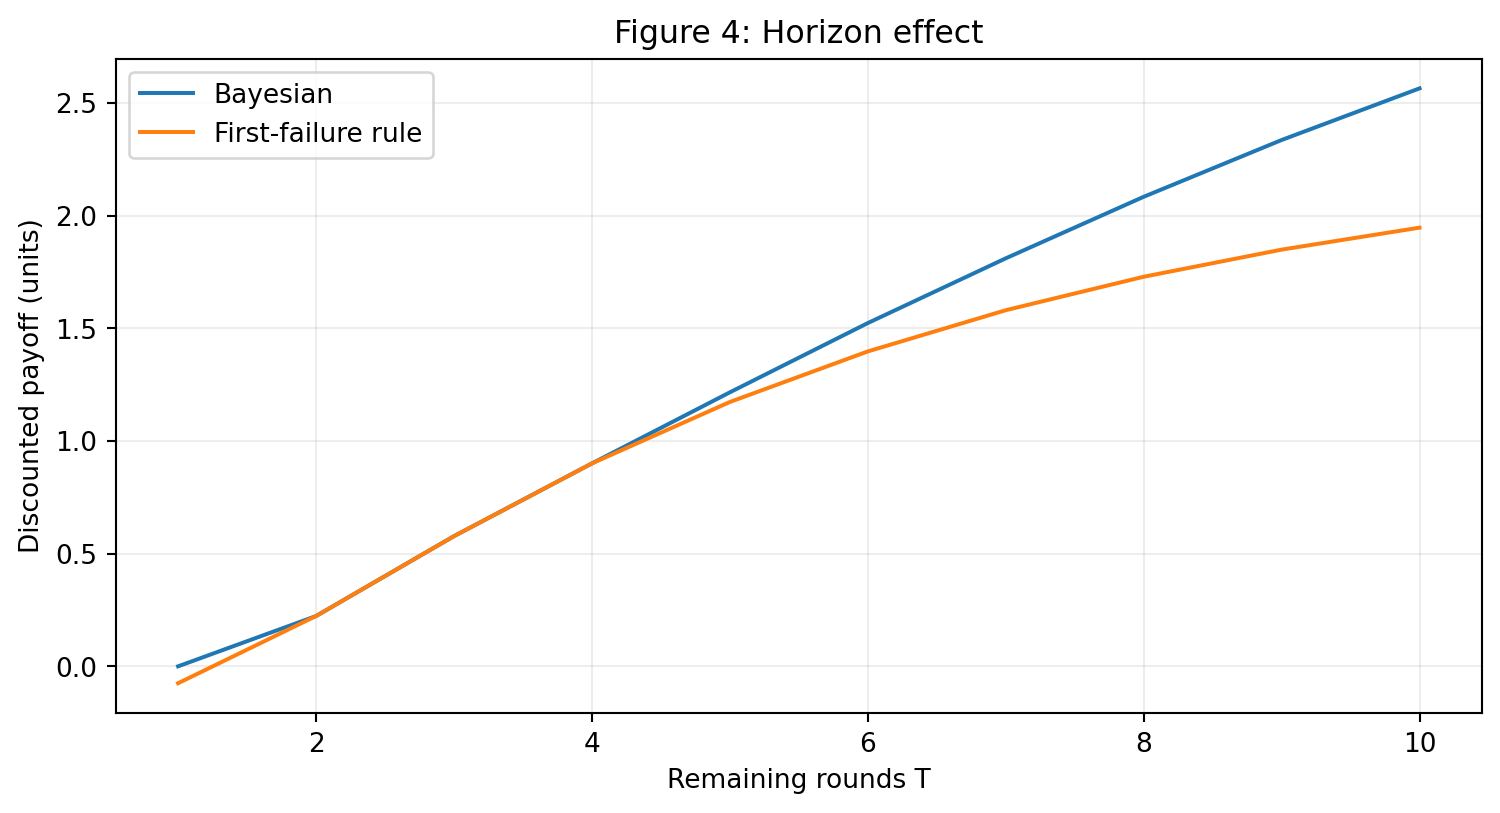
圖 4 在 T=1,...,10 每一點重新求解策略。T=1 時,初始成功概率 w=0.625,單次合作期望 5×0.625−3.2=−0.075,因沒有未來,最適選停止得 0;基準仍強制合作,得 −0.075。T=6 時最適 1.5233、基準 1.3975;T=10 時為 2.5648 與 1.9467。這說明保留未來選擇權的價值,但不能據此推論實際玩家應一律延長合作,更不能忽略跨場配對使對象改變時,固定類型假設可能不再成立。
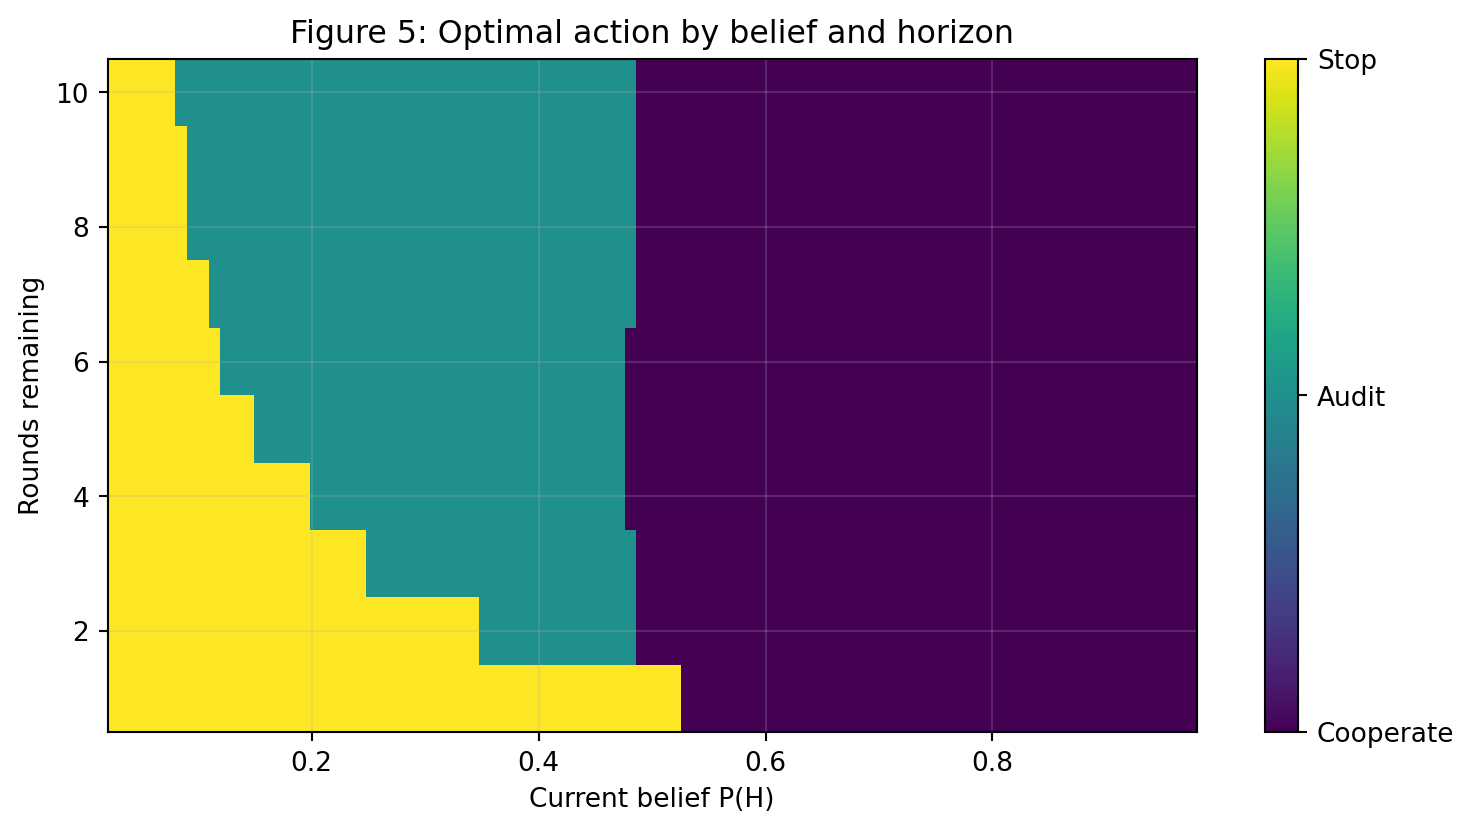
圖 5 對每個期限 t=1,...,10 和初始信念 z=0.02,...,0.98 配對重新指定當前後驗,再計算可選行動。色條表示 cooperate、audit、stop;這是反事實信念狀態的最適相圖,並非斷言所有格點都會出現在單一固定先驗的實際路徑上。最後一輪沒有使用審核資訊的未來,審核動作必然被淘汰;中等信念及較長期限時,資訊價值可能超越本期合作淨報酬,形成審核區域;低信念或短期限時則可以選立即退出。此相圖不能被簡化成一條不依賴剩餘輪數的「信用分數門檻」。
| 檢驗面向 | 分析解或設定 | 合成計算結果 |
|---|---|---|
| 初始 Bayes 及基準混合價值 | π=0.5、T=8 | 2.083665;1.728833 |
| H、O 事前類型值分解 | (U_H+U_O)/2 | 2.083665,與 Bellman 相同 |
| Monte Carlo 規模 | H/O 各 40,000 條 | 固定種子 20261015 |
| H MC 平均收益及標準誤 | 解析 6.771143 | 6.796391 ±0.020464 |
| O MC 平均收益及標準誤 | 解析 −2.603814 | −2.592537 ±0.007788 |
| 有理數獨立核對 | 三種先驗、255 歷史節點 | 最大誤差 1.33×10⁻¹⁵ |
表 3:MC 的「±」表示一個樣本標準誤而非信賴區間。H 與 O 樣本平均和解析真值的偏差分別為 1.23、1.45 個估計標準誤;抽樣確認只為核對計算實作,沒有任何真實玩家統計推斷含意。
以同一種子,H 的提前停止觀察比率為 0.076925,解析為 0.0769483;O 的對應值為 0.967125,解析為 0.967667。所有 MC 均由二元條件概率逐輪合成,而非隨機抽樣真實的玩家或對局。樣本均值接近理論值不能驗證模型的外部效度。相反,Fraction 核對是依據完全不同的分數形式展開公式,能更有力地檢查程式是否正確執行已明確聲明的形式模型。完整 CSV、JSON 及程式隨文提供。
8. 策略冒充:為何最適決策不等於聲譽均衡
先前的 Bellman 解把 B 的類型條件交付概率視為不可操控的資料生成機制。然而真實互惠中,原本低可靠性的人可能出於保住合作關係而暫時提高履行概率。例如 O 類可以投入額外的本輪不可追回成本 m,暫時把當期交付成功率由 q_O 提高到 q_H,而之後再回到 q_O。A 未看到此私人投資,仍以原本固定概率模型更新聲譽。若 O 每當 A 選合作便享有一份不依成功與否而改變的關係租值 r,這個反事實決策會影響 O 的未來被合作次數與收益。此處只測試策略對固定解的穩健性,並非擴建已求解的均衡模型。
給定原先求得的 A 政策 π*,定義 J_t(s,f,a,b) 為 O 在沒有再次模仿、日後每輪都按 q_O 生成訊號的剩餘期望折現合作租值;若 A 停止,J=0;若 A 選合作,J_t=r+δ[q_O J_{t−1}(成功)+(1−q_O)J_{t−1}(失敗)];審核輪沒有租值,則按 O 的 + 率 β 混合後繼 J。對仍處於合作節點的 O,一次模仿把成功概率增加 Δq=q_H−q_O,對未來租值的改變是 Δq 乘成功與失敗後價值差,再折現一輪;本輪關係租值 r 在模仿與否皆相同,互相抵消。故一期間的冒充邊際淨利為:
命題 7(固定類型規則的可操控性診斷)。 假設 O 可以單方、不公開地付出 m 使當期成功概率由 q_O 升至 q_H,該投入不改變其他收益或後續類型,且 A 繼續沿用原先固定類型最適政策。對任何 A 目前選合作的公開歷史,O 這一期改變概率有利當且僅當 G_t>0。若在一個從起始狀態有正概率到達的合作歷史 G_t>0,則「O 永遠不投資、A 沿用固定類型政策」不符合該擴充博弈的一次偏離激勵相容性。
證明。 在目前合作節點中,O 本期不論投資與否均取得共同的 r。投資者另外支付 m,改變成功/失敗分支的機率差恰是 +(q_H−q_O) 與 −(q_H−q_O)。由期望線性,兩策略未來收益差為 δΔq[J_{t−1}(D)−J_{t−1}(F)],扣除 m 即 G_t。若其嚴格為正,O 在原本規定不投資的策略下能單次偏離獲利,因此該候選策略不可能是擴充博弈的逐歷史最適反應。這個必要條件不建立替代均衡的存在、唯一性或信念一致性。證畢。
設 r=0.8、m=0.20,其他仍採表 1 合成參數。從起始狀態沿 A 的政策並容許兩個二元結果逐枝列舉,共有 33 個可到達、A 會選合作的歷史節點,其中 19 個的 G_t>0;最大淨邊際值約 0.83047,起始節點為約 0.60724。數值證明此固定資料生成模型若容許所指定的單輪模仿選項,會遭遇策略行為干擾。即使 19 個節點均有正誘因,也不能宣稱 B 必定模仿,因為我們未求當事人的全部最優動態策略,亦未考慮 A 預先預期模仿後調整其推斷。所有後驗及前述最適收益都是「固定類型政策規格」下的正確數值,不可移植成內生模仿下的預測。
為真正建立不完全資訊聲譽博弈的均衡,需要讓 O 與 H 各自在每個私人歷史選投入與否,讓 A 對每個公開歷史及觀察概率作符合策略的貝葉斯一致更新,並在可能零概率歷史上指定合理的離徑信念。其均衡概念可使用 Perfect Bayesian Equilibrium 或 Sequential Equilibrium,但每一個均衡條件都須重新推導及檢查。這將成為下一篇的核心任務,不能把本文的單期偏離檢查寫成完整的求解。
9. 討論、敏感度解釋與研究局限
本研究最清楚的實際洞見是:結果導向的嚴格觸發規則容易把無辜的隨機失敗當作低可信度證據。即使在完全明示的合成機制中,錯誤排斥與持續接觸風險也朝不同方向變化,決策者只看「排掉多少壞類型」或「留住多少好類型」都不足以評價一套互惠安排。在 H=0.9 的可靠性下,八輪當中的一次偶發失敗相當常見;單次零容忍的規則尤其容易累積錯判。Bayes 政策以整段歷史及剩餘期限評估合作,使正負證據互相補充,卻必須同時承擔更多審核成本及對 O 的試探性損失。
審核是否有價值由成本與未來行動選擇共同決定,而不只由分類準確率決定。觀察結果能否改變後續行動是關鍵;若剩下零輪,任何真實有用的資訊都無法產生新的合作收益。因此本研究展示「信息很好」與「值得現在取得信息」是兩個不同命題。更精確的審核按命題 4 提高了策略可行集合,但並沒有自動改善某個群體的錯判風險。若研究目的將社會公平、對弱勢新手的包容或類型條件最低福利列為獨立約束,應把錯排率直接放入帶約束的 POMDP,而非只是期待事前期望最大化可以代替公平規則。
研究還存在七項明確局限。第一,固定二種類型只是統計近似;實際可靠性可能隨隊友配合、疲勞、團戰風險、配對陣容與學習而變化。第二,所有交付與審核條件獨立,忽略共同環境衝擊造成的序列相關,也忽略英雄、地圖及補丁差異。第三,先驗 π 與各似然概率完全已知且被所有理性決策者共同接受;實際估計誤差可能推動重大決策錯誤。第四,兩人合作視角未納入其他隊友的網絡外部性、排位配對、角色差異及固定群體分層。第五,收益線性且風險中性,不包括情緒、報復、風險規避、身份歧視、可信度啟發式或有限認知。第六,審核是為研究資訊價值而設的假設性獨立訊號;並無證據顯示遊戲存在本文所述可用來辨識誠信型的功能。第七,只有 A 的控制問題被完整解出,B 的努力動機與有策略的交付概率尚未內生化;第 8 節的正冒充收益更直接指出此局限具有數值後果。
因此本文的結論僅適用於給定合成分布的有限期、同伴類型固定的理性期望決策。若將其當作任何賽季版的行為事實,至少須搜集經同意且可合法使用的真實合作互動紀錄,明確辨別公眾看見的失敗、獨立交付能力以及個體內動態因素;若資料不能辨識 H 與 O 的真類型,錯排率無法直接作實證估計。更深的倫理問題是類型標籤不該成為對真人貼標籤的依據;本模型的 H/O 僅是抽象生成參數的名稱。外推至遊戲配對規則會要求另行檢查官方功能、版本規則與偏差,本文沒有完成這類實證工作。
10. 結論
本文處理一個比可驗證背約更困難的公開資訊結構:交付失敗不代表一定故意,成功也不揭露類型。通過在有限期限內對觀察數據更新信念,獲得完整可計算的合作/審核/停止政策及數個可直接證明的數學性質。八輪合成基準最適值 2.0837,較首次失敗永久排斥規則的 1.7288 為高;誠信型提前停止風險由 52.17% 降至 7.69%,但低可靠性型亦得到更多試探性合作,風險與收益並存。審核品質與期限決定資訊取得是否具有價值,不能由單次訊號或固定信譽分數取代。獨立有理數節點檢查與合成 Monte Carlo 支持數學求解的計算一致性;策略冒充診斷卻發現部分節點的單次偏離有利,明確限制了固定類型解作為博弈均衡的適用性。
本文沒有得出真實玩家對故意背約的發生率、勝率效應或官方遊戲內信用評分。本篇主要成果是一組容易審計、可以反駁、可用獨立程式重現的數學基準;未來重點是讓被觀察者的策略與觀察者的更新共同內生,而不是把本篇理性決策公式直接當成真實玩家行為規則。
參考文獻
Green, E. J., & Porter, R. H. (1984). Noncooperative collusion under imperfect price information. Econometrica, 52(1), 87–100. https://doi.org/10.2307/1911462
Kreps, D. M., & Wilson, R. (1982). Reputation and imperfect information. Journal of Economic Theory, 27(2), 253–279. https://doi.org/10.1016/0022-0531(82)90030-8
Milgrom, P., & Roberts, J. (1982). Predation, reputation, and entry deterrence. Journal of Economic Theory, 27(2), 280–312. https://doi.org/10.1016/0022-0531(82)90031-X
Smallwood, R. D., & Sondik, E. J. (1973). The optimal control of partially observable Markov processes over a finite horizon. Operations Research, 21(5), 1071–1088. https://doi.org/10.1287/opre.21.5.1071
「HOK-011:低精確度公開績效訊號下的非貨幣互惠」(2026),本研究文庫內部工作論文;僅用於研究延續及模型對照,未聲稱獨立同行評審或期刊發表。