Information Theory of the Open-Fridge Forgetting Moment
研究編號: Paper_007 完成日期: 2026-10-15
資料類別: E(純理論推導)、D(可重現合成模擬);沒有真實參與者資料。
跨學科: 認知科學、資訊理論 Keywords: 條件熵;對稱訊息通道;序列搜尋
方法聲明:本文參數為合成設計。若未經獨立現場驗證,不得把模型數值解讀為真實社會發現。
中文摘要
走到雪櫃前卻忘記自己要拿甚麼,看似記憶問題,也能被建模為一個有噪聲的意圖訊息通道。本研究假設事前存在八個等機率目標,記憶線索以 70% 機率正確指出其中一項,錯誤時平均指向其餘七項。以 Shannon 熵計算先驗不確定性為 3 bits,通過線索後互資訊量約 1.28 bits;若先檢查線索指示的物品,再依隨機次序逐項搜尋,平均需要 2.2 次檢查,相對沒有線索時的 4.5 次減少約 51%。180,000 次合成訊號抽樣的正確率約 0.7006。此結果屬理論訊息與搜尋策略模型,不是對人類記憶容量的實測。
Abstract
The moment of forgetting one's objective upon opening a refrigerator can be framed as noisy information transmission. Assuming eight equally likely intentions and a symmetric clue that identifies the true one with probability 0.7, the prior entropy is 3 bits and mutual information is about 1.28 bits. An optimal clue-first inspection sequence reduces expected inspections from 4.5 without a clue to 2.2. A simulation of 180,000 synthetic signals reproduces the stated clue reliability. These results characterize a simplified information channel rather than empirical working-memory loss.
關鍵詞 / Keywords: 條件熵;對稱訊息通道;序列搜尋
1. Introduction — 引言
人打開雪櫃門、看着一排食物、然後問自己「我原本想攞咩?」這個場景讓人感到奇怪,因為行動目標似乎只隔了數秒便丟失。認知科學可以從工作記憶與情境改變解釋這種現象;資訊理論則提出另一個問題:若行動意圖被一條帶噪聲的線索表達,這條線索究竟提供多少有用資訊,又能減少多少搜尋步驟?
本文不宣稱人的記憶就是一條對稱通訊通道。研究的數學設定是刻意簡化的八選一任務:一個真實意圖、有限候選集合、以及偶爾給出錯誤提示的記憶線索。透過條件熵與排序搜尋,我們把抽象的「忘記」轉成可量化的資訊損失及額外檢查成本。
2. Literature Review — 文獻回顧
Shannon(1948)建立以機率分佈測量資訊量的基本框架,適合分析候選目的與線索之間的不確定性。Hick(1952)的選擇反應研究顯示選項數目與判斷時間可以具有資訊論關聯,但不能因此假定檢查雪櫃每件物品都需要固定反應時間。Radvansky、Krawietz 與 Tamplin(2011)研究穿越門口與記憶任務的關係,為空間情境更新可能影響記憶提供實證背景。Tversky 與 Kahneman(1974)則提醒對記憶失誤的回顧性估計可能受啟發式影響。
本研究只使用文獻提供的概念出發點,沒有借用未核實的記憶正確率;70% 是自行設定的合成通道參數。來源的實證結果與本文的數值推導必須嚴格分開。
3. Research Questions and Hypotheses — 研究問題與假設
研究問題一:當目標有 個等可能選項、記憶線索以概率 正確時,互資訊量是多少?問題二:先檢查線索所指目標,之後才檢查餘下候選,平均檢查次數能減少多少?問題三:若候選選項數增加,固定準確率的線索是否仍有價值?
H1:對稱通道下, 時線索不含任何關於真實意圖的資訊, 時含有完整 bits。H2:在 時,線索優先的策略比隨機搜索節省期望檢查數。
4. Theoretical Framework — 理論框架
令離散隨機變數 表示原本想取的食物類別,,且先驗均勻。 是打開雪櫃時頭腦浮現的目標提示。若 ,稱線索正確;若錯誤,令它平均指向其餘 個候選。這是一個 元對稱通道,不代表實際人腦錯誤一定平均分散。
搜尋者先檢查 指示項;若並非真實目標,對餘下候選以隨機次序無放回檢查,直到找到為止。這項策略在對稱錯誤機制下是自然的排序方法,因為 所指示的項目具有最高的後驗概率,當 時優先檢查它合理。
5. Methodology — 研究方法
先從通道的條件概率矩陣計算先驗熵、條件熵與互資訊量。取 、,另將 從 掃描至 1,計算有線索的平均檢查數,再在 至 30 的候選規模下比較沒有資訊與固定 的情景。以種子 20261022 生成 180,000 組真實目標及帶噪聲提示,檢查合成訊號正確率。
本文資料類別為 E(數學推導)和 D(電腦模擬),並沒有任何真實受試者。抽樣只為檢查通道機制寫成程式後是否符合指定的參數,不能反向得出記憶失誤的心理成因。
本研究中,對稱通道假設讓提示所指的目標在看到線索之後仍以概率 為真,其他每個候選的後驗概率各為 。由此可嚴格比較搜尋順序。當 ,提示指向的目標比任一其他目標更可能為真,應優先檢查;當 ,反而應先檢查其他候選,把提示所指選項放到後面。這個條件提醒我們,提示可靠度若低於隨機水準,就需要調整使用策略,而不是單純提高提示的醒目程度。
互資訊量可用兩個極端情景作檢查。若 ,提示不會改變任何候選的後驗機率,所以互資訊為零;若 ,提示完全揭露目標,互資訊等於均勻先驗熵 。反直覺的是當 ,線索即使一定指出錯誤選項,仍可可靠地排除一個候選,因此互資訊可能大於零。對八個選項而言,知道提示必錯的人可以從另外七個選項搜尋,比完全沒有提示更有效率。資訊有價值與提示字面上有沒有說中答案是兩個不同問題。
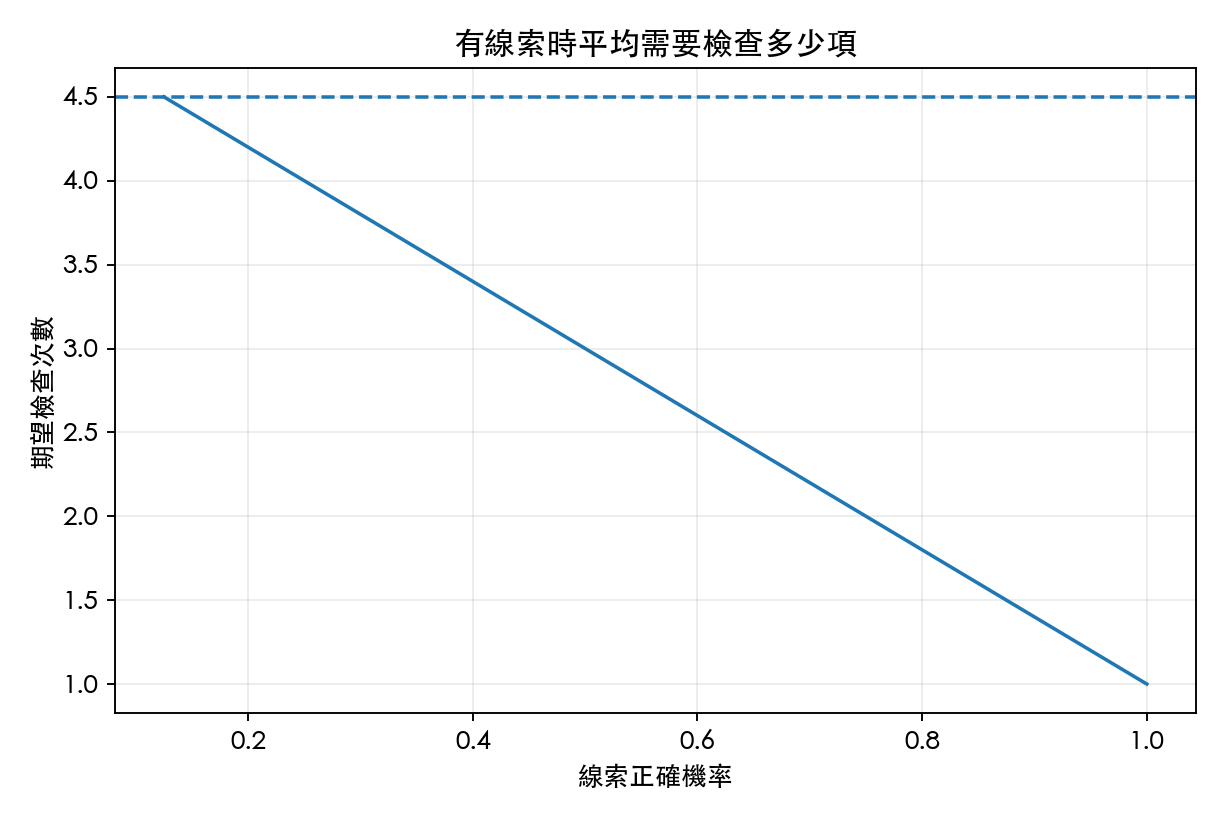
搜尋成本公式可由全概率定理得到。若先檢查提示指向的選項,正確時只需一次;錯誤時先浪費一次,再從其餘 個選項中平均檢查 次,故期望檢查數為 。沒有提示時,正確選項平均位於隨機次序的 位置,兩者差額為 。此式在 時為正,精確表達採用線索優先策略所節省的搜尋步驟。
若不同候選的先驗概率或檢查成本不同,最適次序未必由提示本身決定。必須先以 Bayes 法則重新計算後驗概率,再考慮不同物品的搜尋時間;若每個候選的檢查成本也不同,可將期望成本最小化作為新的最適化目標。對實際雪櫃,常用物品位置固定、部分物品體積較大且容易看到,故等概率與等成本只是分析起點,不能視為已實測的記憶機制。
未來若給參與者兩個提示,亦不能假定它們必然提供兩次獨立資訊。同一段記憶重複浮現可能具有高度相關性,重複訊息不代表信息量翻倍。若在沒有測量依賴結構下直接將兩條提示的似然相乘,便可能高估正確目標的後驗概率。
6. Mathematical / Computational Model — 數學或計算模型
先驗均勻時,每個目標概率為 ,故
對稱通道定義為 當 ,否則 。後驗仍具有相同對稱結構,故條件熵
其中 是二元熵。互資訊量由定義得
若沒有任何線索,隨機逐一檢查 個候選時,真實目標的期望位置為 。若先檢查 ,線索正確時一次完成;線索錯誤時第一次浪費,目標在剩下 項中的平均位置是 ,故
因此省下的平均檢查數為
這個公式清楚揭示何時線索有用:只有 時才節省檢查。若 ,理性的搜尋者應將該提示反向處理或放到後面;本文的簡單策略在該區間並非最優。
對稱通道之所以能得到簡潔的互資訊公式,在於先驗均勻以及每個錯誤候選得到相同概率。已知線索 後,目標正是 的後驗概率為 ,其餘每一候選的後驗概率是 。因此「先查看線索指出的物品」只有在 時才是按機率由高至低搜尋的合理策略;若線索可靠度比隨機猜測更差,應優先檢查它沒有指出的候選,否則可能比沒有線索還要浪費時間。這說明資訊的使用價值與訊息內容本身必須分開理解。
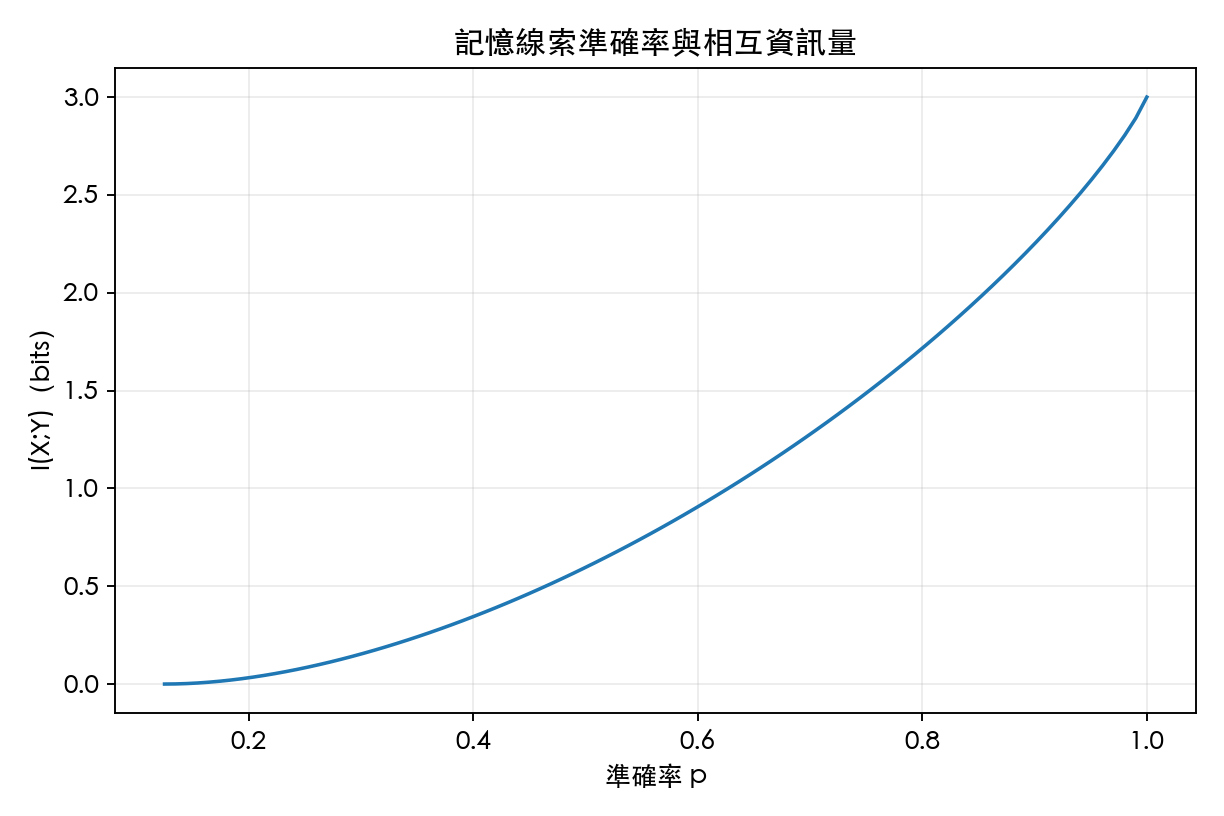
互資訊量等於先驗熵減去條件熵。當 ,線索與真實目標獨立,互資訊為零;當 ,線索完全準確,互資訊等於 。有趣的是當 ,線索雖然從不指出正確項,仍然提供了「該項一定錯誤」的排除資訊,故也可能具有正的互資訊。若搜尋者知道通道機制,可靠的排除訊號同樣可以幫助決策。本文的圖表為了分析常用的正確線索情境,只掃描從隨機水準 至 1 的部分參數域。
若先驗不均勻,等機率的計數捷徑就會失效。應以 Bayes 法則計算每個候選在看到線索後的概率,再按照後驗概率與檢查成本排序;若不同物品所需時間也不同,最佳搜尋不一定只依概率排名。這些修改可以把目前固定每次一單位成本的模型擴展至實際廚房、儲藏室或資訊檢索情境,而不用將人腦錯誤簡化成均勻亂猜。
7. Results — 研究結果
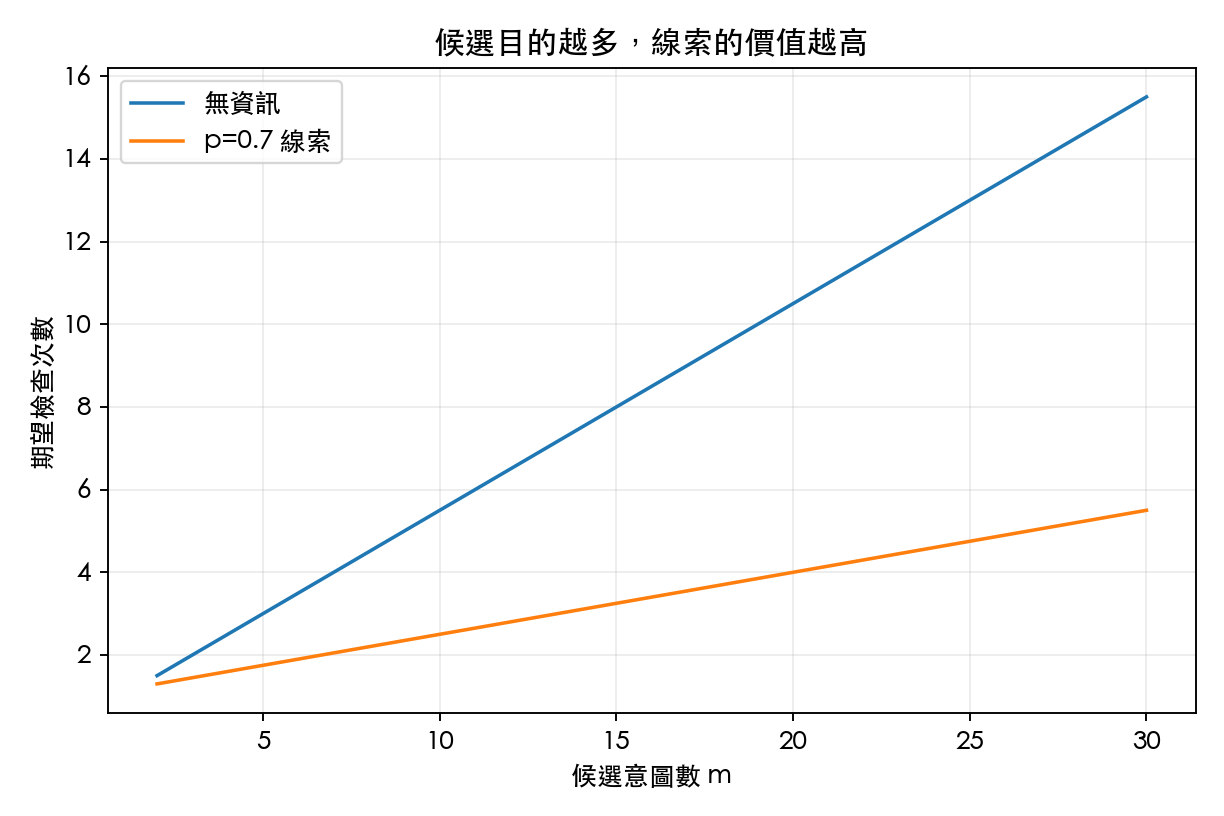
八個等可能目標給出先驗熵 bits。取 時,解析互資訊量約 1.28 bits;無資訊平均檢查 4.5 項,有線索平均檢查 2.2 項,節省 2.3 項,約為原本的 51.1%。180,000 組合成訊號中,經驗正確率約 0.70064。圖 1 顯示互資訊量隨線索準確率上升;圖 2 呈現有線索的平均檢查數;圖 3 在不同目標數下比較兩種搜尋方案。
這些數字量化的是人工通道模型中「線索的價值」,不是一個人在雪櫃前平均忘記幾次,更不表示任何物品真的需檢查 2.2 秒。檢查次數要轉換成時間,還需估計每件物品的視覺辨識時間、遮擋程度與重新回想成本。
模型圖表及數據來源
圖 1 記憶線索準確率與互資訊量
 來源:本研究解析計算及/或固定種子電腦模擬。
圖 2 線索準確率與預期搜尋次數
 來源:本研究解析計算及/或固定種子電腦模擬。
圖 3 候選目的數目與搜尋成本
 來源:本研究解析計算及/或固定種子電腦模擬。
8. Discussion — 討論
這項研究把通常被當作尷尬經驗的遺忘,改寫為兩種資訊量的差距:目標的不確定性與線索消除的不確定性。一句明確的自我提示,例如走去雪櫃前先說「我要拿牛奶」,可能相當於提高了通道準確率;若視覺標籤也提供可識別的線索,搜尋成本還可能進一步下降。但這些設計效果只是由模型提出的假說,需要透過認知實驗量測。
值得強調的是,更多選項不一定意味更差的記憶。當 增加而 保持不變,線索可能避免更多項檢查;如果現實中 隨選項數下降,總效果便不同。模型並不能單憑曲線推斷增加雪櫃分類一定提高生活效率。
雪櫃門口的遺忘現象包含至少三個可區分的因素:目標在離開原本情境時是否丟失、面對多個相似候選時是否搜尋困難,以及人是否有外部提示能恢復目的。本文刻意只研究後兩者中的資訊搜尋部分,因此其互資訊與檢查次數不能被解讀為認知實驗量測到的記憶容量。Radvansky 等人的情境轉換實驗可提供研究動機,但不意味著打開雪櫃會產生同一大小的記憶損失。
一個可檢驗的設計是讓參與者在進入一個房間前收到取物指令,隨機安排不同的提示可靠度、不同候選物品數目與不同距離的環境轉換。除記錄是否找到正確物品外,還要測量第一次檢查時間、後續搜尋次數、是否需要重新詢問目標及整體任務完成時間。若給予事前明確口頭提示,理論上等價於提高通道可靠度;但能否真的提高記憶恢復率,必須由實驗而不是資訊公式回答。
模型還有一項實務啟示:若某種提示經常誤導,解決方案不一定只是增加提示的醒目程度,也可以先校準它與真實目標的對應規則。可靠度低而使用者仍相信它會正確,可能造成比沒有提示更長的錯誤搜尋。若提示能清楚標示其不確定性,使用者可以調整先後檢查的順序。這一論點來自後驗機率的決策框架,現階段仍沒有真實測得的行為效應。
補充:反向線索也是資訊。 在八個等概率候選的對稱通道中,線索指出的項目若正確率 高於 ,優先檢查該項是合理的;但若 ,正確的最優次序其實是把該項留到最後。此時若線索所指項真的正確,搜尋需進行八次;否則真目標在其他七項中均勻分佈,平均檢查四次。因此 的一般公式是 。沒有提示時平均檢查 次,將不可信線索用作排除資訊可節省 次。特別是 時,八選一的最優平均由 4.5 降至 4.0;即使線索總是錯,它仍然能可靠地排除一個選項。
這個推導必須與互資訊分開解讀。互資訊描述提示與真目標之間有多少統計依賴,並不指定讀者如何行動;搜尋效益則還取決於提示如何映射到搜尋次序、每次打開或移動食物的成本,以及容許否選擇忽略線索。只要決策者可以自由忽略提示,增加一份訊息原則上不會使最優搜尋成本惡化;相反,若介面強迫使用者永遠先看提示所指位置,在 的情況就可能表現得比沒有提示更差。所謂「提示令人更迷糊」,在數學上需要先區分訊息本身與錯誤的使用規則。
均勻先驗的假設也會影響策略。例如雪櫃中經常取用的牛奶可能先驗概率遠高於只在週末使用的醬料。若目標先驗分佈是 ,提示對不同真目標的正確率亦不同,觀察提示 後的後驗概率應按 Bayes 法則計算為 。在每個檢查成本相同的條件下,依後驗概率由高至低搜尋可由交換相鄰順序的論證證明最優:若把較可能的項目排到更後,交換兩項總能不增加期望檢查次數。
對不等成本,若檢查項目 需時間 ,應考慮檢查順序的總期望時間;兩個相鄰項目互換的比較指出,應優先排列後驗概率與檢查時間比值 較高的項目。這個比值規則要求檢查成本已知且一旦找到就停止,並假設檢查過程沒有新的提示。實際冰箱的物品可見程度、抽屜遮擋及使用者身高都會改變成本。若沒有量測這些變數,就不能把數學上的最短搜尋順序視為對所有家庭適用的設計建議。
9. Limitations — 研究限制
假定八個目標先驗均勻、錯誤線索均分其餘候選、每次檢查成本相同。現實物品具大小、位置及出現頻率差異;人在熟悉環境時亦可能利用空間記憶,不需逐件搜尋。雪櫃門與記憶干擾的因果聯繫並未測量,不能把關於 doorway effect 的文獻當成本研究效應量。
10. Conclusion — 結論
在八選一、線索準確率 70% 的對稱模型中,一條線索具有約 1.28 bits 的互資訊量,令期望檢查次數從 4.5 降至 2.2。表面上「打開雪櫃卻忘記」的經驗,至少可以用資訊通道可靠性與最優搜尋的概念提出清楚可測的研究問題。
11. Future Research — 未來研究方向
可招募受試者進行經倫理審查的短期視覺搜尋實驗,隨機操縱物件數量、提示可靠性與情境轉換,估計真正的提示混淆矩陣。若混淆並非對稱,可使用貝葉斯後驗機率排序,對比模型預測的搜尋路徑與實際眼動紀錄。
Appendix — 附錄
生成機制為先均勻抽取真實目標,再以概率 輸出正確提示,否則把一個從 1 到 的均勻偏移量加至真實目標並取模。data/information.csv 列出互資訊量與期望檢查數。
八選一案例的先驗熵為 3 bits;指定正確率 0.7 的對稱通道後,可用二元熵及錯誤均分至其餘七項的條件熵公式,核對互資訊約為 1.28 bits。此數字取決於人工設定的通道,並非任何人的實測記憶容量。之後可以生成 180,000 條合成線索,檢查正確率與解析設定一致,再用每次搜尋次數的樣本平均對照理論值。
若提示錯誤,搜尋器應在剩餘七個候選中不重複地逐個檢查;如果程式容許重複檢查同一件物品,其期望值會偏離模型。若使用者在搜尋中重新得到外部提示,便引入了新資訊,亦不能再沿用只觀察一次線索的公式。完整可重現的實作需固定候選數、通道矩陣、先驗分佈與檢查成本。
真實認知研究還需另行測量情境改變、指令呈現方式、視覺搜尋速度及不同物件數目的影響,避免把搜尋步驟減少誤稱為記憶容量提升。本研究沒有蒐集任何受試者資料。
對稱通道的互資訊在 恰為零,但這不是說正確率愈低資訊量就必然愈少。當 從 繼續降向零,提示愈來愈能可靠地排除其所指選項,因此互資訊又開始增加。從決策角度,使用者應根據線索的統計品質選擇優先、延後或忽略,而非把它抽象地標作「有用」或「無用」。本研究使用的互資訊是對所有可能目標與線索取平均,不代表某一次提示一定讓讀者節省相同數量的檢查步驟。
若實際介面容許「我現在想找的是飲料還是食材」這類層級式提示,目標空間不再只是八個等概率物件,而可能形成樹狀分類。研究者可比較先查詢類別再查詢物件,和一次顯示單一候選的期望總步數;但每一次詢問也應計入認知與操作成本,否則把分步提示誤當免費資訊會高估介面改善效果。
12. References — 參考文獻
- Radvansky, G. A., Krawietz, S. A., & Tamplin, A. K. (2011). Walking through doorways causes forgetting: Further explorations. The Quarterly Journal of Experimental Psychology, 64(8), 1632–1645. https://doi.org/10.1080/17470218.2011.571267
- Shannon, C. E. (1948). A mathematical theory of communication. Bell System Technical Journal, 27(3), 379–423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x
- Hick, W. E. (1952). On the rate of gain of information. Quarterly Journal of Experimental Psychology, 4(1), 11–26. https://doi.org/10.1080/17470215208416600
- Tversky, A., & Kahneman, D. (1974). Judgment under uncertainty: Heuristics and biases. Science, 185(4157), 1124–1131. https://doi.org/10.1126/science.185.4157.1124
本文是虛擬學術研究所的原創模型演練;它不是實地研究或同行評審期刊論文。
所有模擬數值均可在同一資料夾的 data/summary.json 與程式中核對。