Browser Tabs That Refuse to Close: Real Options, Attention Carrying Costs, and Optimal Stopping of Deferred Reading
研究類型: 合成參數下的規範性決策模型及可重現蒙地卡羅模擬。資料聲明: 本文沒有使用任何人的瀏覽紀錄,沒有調查參與者,也沒有取得瀏覽器外掛量測資料。文中全部數值均為事先指定的假設參數與 Python 計算輸出,不能當作真實分頁習慣的統計估計。
中文摘要
為甚麼一篇「之後有時間再讀」的網頁,能夠佔據瀏覽器數月,甚至當使用者已忘記內容時仍然不願關閉?本文將保留分頁視為一項有到期風險的資訊選擇權,利用具有「價值尚未確定」、「已辨識為有用」及「已失效」三個狀態的有限期馬可夫決策過程,推導關閉、立即閱讀與繼續等待的最適規則。模型以每週折現率因子 0.95、持有成本 0.30、十二週決策期及合成轉移矩陣作示範。結果顯示,未知分頁的規範性期望折現價值為 1.446521 個假設效用單位;在基準條件下應等待,確定有價值者應閱讀,已失效者應關閉。可解析的無限期極限為 1.450980,與有限期動態規劃一致。125,000 次固定亂數種子的模擬得到平均值 1.437676、標準誤 0.007676;差距與蒙地卡羅抽樣變異相容。研究進一步建立資訊獲益機率與注意力成本之間的閾值關係,指出保留分頁可以有合理性,但大量分頁亦可透過成本上升使最適行動從保留轉為封存或關閉。模型是規範性、條件性分析,不以此推斷實際使用者的心理或臨床問題。
關鍵詞: 分頁管理;最適停止;真實選擇權;認知卸載;馬可夫決策;注意力經濟;合成模擬
English Abstract
Why do people keep a browser tab open for a page that they may never read? This paper develops a normative finite-horizon Markov decision model in which a deferred page may remain uncertain, become valuable, or expire. The available actions are closing, reading, and waiting, with a discounted holding cost associated with the latter. All parameters and observations are synthetic. Under a twelve-week illustrative scenario, the optimal discounted value of an uncertain tab equals 1.446521 utility units, versus a closed-form infinite-horizon value of 1.450980. Simulating 125,000 episodes with a fixed random seed yields a mean of 1.437676 and a Monte Carlo standard error of 0.007676. A threshold separates circumstances in which waiting for information is rational from those in which closing is optimal. Additional illustrative congestion assumptions demonstrate how a rising attention cost changes a person's optimal policy and may make archiving preferable. The analysis clarifies the difference between a normative decision recommendation and an empirical explanation of human tab use; no participant data or browser logs are claimed.
Keywords: browser tabs, optimal stopping, real options, cognitive offloading, Markov decision process, synthetic simulation
1. 引言:一張數碼書籤何以變成未履行的承諾?
開啟網頁原本是一項幾乎沒有物理阻力的操作。只要輕按連結,新分頁便出現在畫面頂部;使用者不必立即決定是否閱讀、分類、記錄或刪除。然而,每次將決策推遲,都把一項極小的處理義務轉移至未來:某個時間應重新辨識它、評估它是否仍然重要,然後採取行動。真正需要被研究的不是單次開啟行為,而是一連串未完成決策在不確定性下累積的結構。本文以研究所慣用的荒誕問題開始:既然關掉一個分頁如此容易,為甚麼它看似擁有永久居留權?
這個問題可以有很多不同層次。從介面層面,分頁提供快速返回的入口;從認知層面,分頁可充當一個尚未完成意圖的外部提示;從經濟層面,它可能是等待未來資訊價值變得明朗的免費選擇權;從資源管理層面,持續開啟亦可能造成切換、搜尋與注意力的成本。若把這幾個層次混為一談,便很容易犯下兩個相反錯誤:將所有未讀分頁判斷為低效率的拖延,或將全部累積都合理化為有價值的個人知識庫。兩種判斷都需要與實際情境相配的證據。
例如,學生開了五篇與下週報告有關的學術文章,但尚未知道老師最後會選哪個題目。今天逐篇閱讀有即時時間成本,而未來兩天的新資訊可能令其中幾篇變得特別重要。在這個情境,延遲處理具有可能的選擇權價值。另一個例子是半年前已結束的活動頁面:若頁面資訊的效用明確消失,保留它就沒有相同理由。兩例的外觀都可能只是「一個未關的分頁」,但決策問題的狀態、資訊更新機制與最佳行動完全不同。形式化研究應能區別這兩例,而不能依賴分頁數目本身作道德判斷。
我們從三個動作出發:立即關閉、立即閱讀,或保留一週後再重新評估。閱讀不一定帶來正報酬,因為花掉時間才發現內容無用,亦屬資源損失;關閉放棄潛在價值,同時省卻往後整理成本;等待容許狀態轉移與認知判斷改善,卻必須承擔折現及持有成本。選擇這三個動作,並不是主張人們每天都以清醒理性的方式計算,而是提供一個可以推導條件、檢驗數值及辨識反例的規範性基準。
本研究的對象是一個「仍未知道是否值得閱讀」的代表性分頁。系統中可存在其他已知有用或已過期的分頁;它們用作界定最適選擇。所謂「有用」是一種當前決策狀態,不是以某種自然定律決定的網頁真實品質。一份技術文件可以在專案初期很重要,到任務完成後變得沒有用途;相反,一頁旅遊資料亦可能因為日後決定出行才出現效益。模擬中將這些變化壓縮為少量轉移機率,是分析的起點,也是外推時最重要的限制。
本文希望回答的核心並非「平均多少分頁算太多」,因為沒有用戶資料便不能估計此平均值;更準確的問題是:在特定資訊更新機率、未來效用與持有成本下,甚麼條件使保留分頁優於立即關閉?當未確定分頁愈多,邊際注意力成本增加時,這個條件又如何改變?透過可解析特例及有限期數值演算法,我們提供可重現的答案,並清楚區分模型內的因果關係與現實中的待驗證假說。
研究設計亦具有方法上的教育目的。日常物件的數目容易被誤當作心理特質的代理指標;一個人擁有大量分頁,不代表其記憶力低、工作能力差,亦不表示必然具有高探索精神。只有分頁的開啟時刻、返回頻率、任務背景、內容到期時點、相關成本等資料被可靠測量,才可能進一步進行解釋性或預測性研究。本稿沒有收集此類資料,因此避免為假想使用者捏造動機與統計顯著性。
2. 文獻回顧:分頁是資訊入口、外部記憶還是可延遲決策?
認知卸載(cognitive offloading)提供理解分頁的一個概念視角:人在處理有負荷的任務時,可以借助環境或工具保存中間資訊。Risko 與 Gilbert 的題為 Cognitive Offloading 的綜述(2016,DOI: 10.1016/j.tics.2016.07.002)屬於這個理論領域的可核實出版物。本文借用「把部分待處理內容交予外部表示」作為概念起點,卻不聲稱該文曾測量我們模型內的每週成本、三狀態轉移,亦沒有把它當成實證上的參數來源。開啟分頁可能減少當下需要記住的細節;日後要找回它時,外部記憶又可能成為需要整理的對象。
瀏覽器介面研究則提醒我們,分頁未必以單一網頁為管理單位。題為 Tabs.do: Task-Centric Browser Tab Management 的 ACM UIST 論文(2021,DOI: 10.1145/3472749.3474777)可作為「以任務而非單頁組織分頁」這個相關研究方向的確切書目錨點。由於本輪未能核閱全文,這裏沒有歸納該論文使用者研究的樣本、數據或結論。我們將「以單一分頁」作為最小模型單位,同時承認多頁互相關聯及同一任務反覆出現時,單位化假設會失效;後文因此另外建立非常簡化的擁塞成本情境,而不聲稱它已重現特定介面實驗。
資訊覓食(information foraging)是另一個有用的橋樑。2009 年 Encyclopedia of Database Systems 收錄名為 Information Foraging 的條目(DOI: 10.1007/978-0-387-39940-9_205),其書目資料經 Crossref 搜尋核對。本文使用的是這個研究領域的基本提問:搜尋、保留及轉移資訊入口,都可以與預期回報及成本連繫;但沒有閱讀條目全文,因此不會將本文的具體公式歸因於它。若將不同網頁視為候選資訊來源,等待價值的存在便取決於未來能否辨識哪些入口值得投入注意力。
選擇權及最適停止(optimal stopping)文獻強調,有些決定可以延期,而且等待本身改變可獲資訊。2014 年題為 Applications to Optimal Stopping Problems 的 Universitext 章節(DOI: 10.1007/978-3-642-37632-0_11)提供真實存在的相關理論文獻索引。本研究的貢獻不是重新發明最適停止定理,而是將停止、行動與持續三選項整理成適合分頁情境的小型馬可夫決策過程,令價值門檻可被完整推導及檢查。等待具有價值這件事不應憑直覺確定;若期間沒有可能發生有利資訊變化,或每期付出的成本過高,理論可以同樣明確地支持關閉。
描述性心理學與規範性最佳化亦需要分開處理。2000 年 Choices, Values, and Frames 所收錄的 Prospect Theory: An Analysis of Decision under Risk 章節(DOI: 10.1017/CBO9780511803475.003)是已核實的文集出版版本;它提醒決策可研究不確定性與效用的表示方式,但本研究沒有聲稱擬合任何前景理論權重,也沒有把這個文集版本寫成原始論文在 2000 年首次發表。模型採用線性期望效用及固定時間折現,目的是令結果可核查,並非預設真實人類一定如此行動。
上述文獻指向四個需要分辨的理論層面。第一,資訊放到外部介面與知識已被真正吸收並不相等;第二,網頁的任務意義可能比單頁識別碼更重要;第三,延遲處理可以是對不確定性作出合理回應;第四,人實際採取的行為可能偏離一個以效用最大化為目標的規範性策略。這四層不能靠單一參數完全覆蓋,因此本研究將結果局限於一個可解析的微型情境。文獻核實表明書目存在,卻不等於我們已取得任何文獻中的原始實驗資料。
這個界定亦處理「分頁債務」一詞容易帶來的誤導。債務在經濟學含有特定權利義務及現金流意義;此處的「記憶負債」只是分析性的比喻,指未來要重新確認、尋找和切換內容的機會成本。它不是法律債務,也無法僅憑未讀標籤推導欠款金額。相似地,「真實選擇權」指一個可延遲的資訊投資時點,不表示分頁本身是可在市場買賣的證券。為避免混淆,所有價值都用假設性的效用單位表示。
3. 研究問題、假設及可否證界線
第一項研究問題(RQ1)是:在有限時間內,有甚麼條件令一個價值未知的分頁值得多保留一週?我們以明確的馬可夫轉移機制表示每週由「未知」變成「已確認有用」的可能性,並對照閱讀帶來的正報酬、無效頁面的負報酬及每週成本。假設 H1 指出,當每週得到有用資訊的機率上升而其他量固定時,最適價值不會下降;當持有成本上升而其他量固定時,最適價值不會上升。這是能在模型中證明的比較靜態,而不是關於真實人群的預測。
第二項研究問題(RQ2)是:若使用者本來便面對多個未決分頁,持續開啟的吸引力會否下降?假設 H2 認為,如額外分頁使每一頁的有效注意力成本按已知規則上升,則最適保留價值可能存在一個由正值變成零的界限。這個假設只對指定成本函數成立;若使用者有自動分組、熟練的搜尋方法或可忽略的切換成本,則不必出現相同形狀的結果。本文以明列的線性成本作教學情境,未量測真實瀏覽器的邊際負擔。
第三項研究問題(RQ3)是:能否使用互相獨立的計算方法確認動態規劃結果?我們建立解析封閉式、有限期向後遞推和個別路徑的蒙地卡羅模擬。假設 H3 是在正確執行、足夠多次的合成模擬下,平均折現效用應在可解釋的抽樣誤差內接近動態規劃期望值。若差距遠超數個模擬標準誤,應優先檢查折現時點、末期動作、轉移機率及隨機數產生過程,而非把差異敷衍歸因於「心理偏誤」。
「可否證」在此處的意義需要格外小心。當 H1 至 H3 都依賴明列的演算法定義,程式測試若失敗會反駁實作正確性或某個數學推導;它不會直接推翻人類的實際注意力理論。真正具有外部效度的假說應要求量度使用者分頁的返回時距、關閉決策與重新閱讀成效,並用預註冊方法檢驗。由於沒有相關資料,本稿既不報告顯著性檢定,也不將 125,000 條人工路徑當作 125,000 位受試者。
4. 理論框架:不確定性、資訊到達與選擇時點
假設某一個尚未處理的網頁位於狀態 ,表示使用者目前不肯定它值不值得花時間閱讀;若獲得新任務資訊或重新整理需求,可能轉為狀態 ,表示值得立即閱讀;若內容過時或任務結束,則轉為狀態 ,表示已失去效用。狀態描述的是決策者目前所掌握的資訊與任務關係。這種三狀態設計不把網頁在客觀世界的價值假定為固定,亦不需要憑空推斷某位使用者的個人特質。
每期允許三個動作。關閉動作 立即獲得標準化效用零,不再負擔費用,也不再有返回收益;閱讀動作 立即取得取決於狀態的淨效用;等待動作 現在付出注意力成本,讓頁面保留至下一個決策點,再觀察可能發生的狀態變化。閱讀淨效用已把閱讀時間及機會成本包含在內,不應再次減去一筆未定義的閱讀成本。所有策略只比較由同一單位及同一基準定義的數量。
模型採用折現因子 ,意思是下週的一個效用單位在本週僅值 ;它並非表示網頁物理上貶值的速度。資訊會否變得有用則由轉移機率 控制,失效機率由 控制,未知狀態持續的機率是 。只要三者非負且相加為一,便構成一個有效的機率列。將折現和資訊到達分開,可避免把「我會忘記」和「內容已過期」誤寫成同一個因素。
真正的保留價值包含兩部分:未來可能獲得更好資訊而作出的行動回報,以及在等待期間付出的直接負擔。若有用狀態已經出現,繼續等待通常會無端延後收益;若失效狀態已確定,保留則沒有可確認的理由。在本文參數範圍中,這兩類分頁存在簡單策略,因此只有未知狀態需要完整的最適停止計算。這種結構可以在多個不同視角下檢驗,而非依賴黑箱機器學習預測。
不能把等待價值誤解成分頁自動產生知識。等待是否值得,取決於「下一週的狀態觀察」實際上能否帶來資訊:如果使用者從來不回到分頁、沒有新的任務訊息,也不會重新判斷需求,那麼模型指定的 就缺乏現實基礎。保留介面元素本身不會憑空提高任務匹配率。這個界線十分關鍵,因為日常語言常將尚未失去的可能性當成已經取得的收益;我們只將其計作依特定機率及成本折現的期待價值。
5. 研究方法:明確的合成實驗,不含真人瀏覽紀錄
本文使用純理論推導、Python 動態規劃及蒙地卡羅計算互相驗證。所有參數均為研究者為說明機制而指定的假設值,沒有對真實生活中的分頁使用者進行抽樣。此處的「一週」只是方便閱讀的離散決策間距;將其改為一日或一個工作時段,必須同時重新指定轉移機率、折現因子與持有成本,不能直接把每週的數值當作每日參數。模型的預測對時間刻度相當敏感,因此重現報告記錄每項設定。
狀態集合定義為 ,依次表示未知用途、已知有用、失效。決策動作集合為 ,依次為關閉、閱讀、等待。基準閱讀淨報酬向量按狀態順序取為 ;這不是港幣金額,也不是問卷上的六分滿意度,而是為計算設立的單位一致、可比較的效用刻度。關閉各狀態均得零,等待則支付每週成本 ,同時令下一週的價值乘以 。我們假設決策者知道所有機率與效用,並能在每期觀察當前狀態,這是可解性的重要但偏理想化的條件。
基準轉移矩陣為:
矩陣的第 列第 欄是等待一週後由狀態 移至 的條件機率。未知分頁有 65% 的假設機率仍未知、15% 被辨識為值得閱讀、20% 變為已失效。狀態 的轉移列有 25% 回到未知、65% 保持有用、10% 變為失效;然而在本文基準政策下,已知有用的分頁會立即閱讀,故這一列只用來保持一般模型的完整性,不會影響基準策略下的路徑。狀態 被設定為吸收狀態;其「不會恢復價值」是刻意的簡化,並非聲稱所有舊網頁均不可能重新有用。
計算時間界限設為十二個可等待的決策期。用 表示已抵達最後決策點,此時不能再等一週,只能即時閱讀或關閉;用 表示起始時尚可等待最多十二次。這個期末條件有效避免一個常見錯誤:若給最後一步繼續等待的權利,實際上就是悄悄延長了期限,並使無限期價值被錯認為有限期結果。每次等待均在本期扣成本,隨後才折現下期的值;同一條路徑上的第 期成本以 計入起始時間的效用。
有限期動態規劃由下向上計算。令 是還有 次等待機會,分頁處於 時的最優預期折現值;每期直接比較三個候選值。程式對各狀態儲存一個最大值及其對應動作,因此可輸出策略而不僅是分數。成本、未知變有用機率及期限均能改變,令敏感度分析與基準結果使用同一套決策規則。演算法沒有透過外來資料訓練任何分類器或神經網絡,也沒有將生成的路徑作為「收集所得樣本」。
為獨立檢驗,研究另外模擬 125,000 條合成生命史。每一條路徑由未知狀態 開始,按動態規劃策略選擇當期動作。如果策略選擇等待,便扣除當期已折現成本,然後以事先指定的轉移機率抽取下一狀態;若策略選擇閱讀或關閉,便結束路徑,並累加當下應得的折現效用。隨機數生成器採用 NumPy 預設產生器,種子固定為 2026101615。所有路徑的平均、樣本標準差所得到的蒙地卡羅標準誤,以及最終動作的類別總數均保留在 data 目錄,以便作為對照。
這裏的蒙地卡羅標準誤只量度「在我們指定的隨機過程下,125,000 條模擬路徑的平均值會如何波動」,並沒有包含模型參數選錯、使用者不理性、各分頁互相影響、跨週條件改變等不確定性。模擬的次數大,並不會令任意指定的 自動成為可靠的現實估計值。將模型不確定性與抽樣誤差分開,是避免量化研究產生虛假精確感的基本要求。
敏感度實驗先在持有成本由零至 0.95、未知轉有用機率由零至 0.50 的網格上,重新求解十二週最適策略及價值。失效機率保持 0.20,因此各列仍滿足 。這個範圍包括完全不可能變得有用的情況,也包括較頻繁得到新任務資訊的情況,適合檢查閾值是否在不同成本下保持一致。研究亦比較剩餘期間由零至二十週時的價值曲線,以示範時間選擇權如何逐漸接近一個上界。
第二組敏感度並不直接假設分頁互相競爭同一個機率事件,而是試驗一個外生的擁塞成本規則 ,其中 是同時要管理的假設分頁數目。這個函數純為說明「分頁增多使處理單一頁面的成本增加」時會發生甚麼結果,與 CPU 記憶體耗用沒有直接換算關係。我們另畫出淨值為 0.60 的假設封存選項,方便檢視關閉與轉存資料的差別。此處每一個 都是獨立的比較情境;不能將單頁最適價值乘以 並聲稱已求解整套互相牽連的分頁系統。
在重現層面,資料夾包含可單獨執行的 analysis.py、完整參數摘要 JSON、不同期限的 CSV、成本—機率網格 CSV,以及擁塞成本敏感度 CSV。五張圖亦直接由程式重新生成。由於 Python、NumPy 與 Matplotlib 的版本可能對浮點輸出及畫面字型造成細小差異,可靠的核對方式是比較核心的遞推值、策略及模擬標準誤,而不是要求各像素完全一致。最終驗收還須檢查圖表是否與正文中的數字、假設及語句吻合。
6. 數學模型及完整推導
6.1 Bellman 遞推與邊界條件
定義 為剩餘 個可等待期內,從狀態 開始能取得的最優期望折現淨效用。最後一期無法等待,故:
當 時,允許三個動作,因此 Bellman 方程為:
第一項是關閉的即時效用;第二項是閱讀的已扣除相關成本的即時效用;第三項先扣等待成本,再計算折現後的預期最適後續價值。此寫法只在轉移滿足馬可夫性、行動在每期可自由選擇、關閉及閱讀結束當前決策,以及各項效用可以在同一尺度相加的前提下成立。若網頁內容互相依存、閱讀某一頁會改變其他頁的有用機率,就必須擴大狀態空間。
在基準參數下,已失效狀態 的最適值為零。證明從 開始;假設 ,又因為 ,則等待值為 ,閱讀值為 ,關閉值為零,所以 。數學歸納法完成證明。結論依賴 被設定成吸收狀態及關閉免費;如果失效頁有復活機率或重新取得資料非常昂貴,就不再必然成立。
對有用狀態 ,立即閱讀的價值為 6。基準模型中,所有最適價值均不大於最高即時報酬 6,因為每次等待均帶來非負成本與不大於一的折現因子;因此無論 轉移列如何分配機率,下期最適價值的期望都不超過 6。等待值至多為 ,嚴格小於即時閱讀的 6,故對任意 均有 。即使某個分頁未來可能保持有用,延遲實現同一個確定報酬仍會受到成本與折現的懲罰,因而不是此模型內的最適策略。
未知狀態 的即時閱讀值為負一,低於免費關閉的零,所以只須比較關閉與等待。令未知轉有用的機率 ,未知變失效的機率 ,仍未知機率 。利用 與 ,便得到一維遞推:
我們將一次有利狀態變化所提供的折現貢獻與每期成本之差記為 ,保留未知狀態時的折現延續係數記為 。遞推就成為 ,而 。本例 ,。所以每一個有剩餘等待機會的決策點都會選擇等待;其後續價值為正,令首次等待的選擇有嚴格的數學依據。
6.2 有限期限、無限期限與門檻
對 且 的情況,因為 ,遞推可以逐步展開為 ,,。由等比數列求和,剩餘 期的封閉式為:
其中 時即使上一期價值為零,等待仍不能獲得正效用,因此透過歸納得到始終關閉的策略。這一條件適用於本研究所採用的固定報酬 、、失效狀態吸收、非負成本及 立即閱讀最適的設定;它不應被不加修改地引述為所有一般馬可夫決策過程的門檻。若未知頁的即時閱讀亦有正回報、或等待會改變資訊之外的任務收益,便要重新比較完整 Bellman 方程的各項。
將基準數值代入,,,,得到:
令 ,由於 ,,於是無限期解析極限為:
有限期的 1.446521 低於無限期的 1.450980,兩者差額約 0.004460,約為無限期值的 0.31%。這個差異不應被解讀成真實世界中十二週和無限週只差很少;它是特定折現及狀態轉移下,未知狀態每週只有 65% 機率維持原狀而帶來的數學結果。若未知狀態更持久、折現較弱或持有成本不同,期限差異可以顯著改變。
初始未知狀態有利於等待的充要條件在此特例中可整理為 ,即:
當 、 時,門檻為 。若 只有 0.03,即使網頁或許終有一天變得有用,按本文成本與效用設定亦應立即關閉;若 ,則只要 就有正的保留價值。嚴格不等式之外,在完全相等時保留與關閉的預期價值都是零;程式中的最大值順序可能用關閉作為平手的預設動作,而不表示存在嚴格優劣。
一個微妙但有教育價值的事實是,這個正負門檻不含未知自我維持機率 。它不表示 不重要;它只表示在這個特例內,第一步等待的淨正貢獻是否成立,由得到有用訊息的機率和當期成本決定。當 時,延續係數 仍控制正效用可以累積多少次,並直接影響價值的大小、期限效應及等待時間。把「是否值得等」與「等待可值多少」分開,可避免將一條門檻公式錯誤解讀為完整的價值函數。
6.3 理論單調性及其限制
有限期式可寫為 ,其中 。在等待有正值的區域,對成本微分可得 。所以增加每週成本一定減少保留的最適價值;當成本高到超越門檻,最適價值被關閉動作的零下界截住,之後不再負值下降。這解釋了為甚麼圖上的價值曲面出現平坦的零區域,而不是在高成本下無限制變成負數:任何理性決策者都可以選擇免費關閉。
對有用化機率 的變化,除了提高當期取得報酬的機率,它亦會降低仍未知的持續機率 。直觀上,前一效果應增加價值,後一效果則改變在未知狀態反覆等待的次數。由完整 Bellman 方程可進一步得知,在本模型中,將部分機率質量由 轉給報酬更高的 ,不會降低最適期望值,因為 。這是一個基於隨機轉移支配關係的結果,而不是忽略 同時出現在 和 中的形式微分捷徑。
失效機率 的作用則不完全與 對稱。在 固定而 上升時,部分「繼續未知」的機率質量會轉向「已失效」,所以正值區域內的延續項減少,等待價值一般降低;但是當 而使用者起初就應關閉時,再提高失效機率不會令已經為零的最適值變成負數。這使成本、到期風險及資訊到達具有不同政策含意:降低持有成本可以改變正值門檻,而提高失效風險主要壓低正值區域的價值規模。
不應將所有參數變化視為彼此獨立的實驗操控。在現實中,任務臨近截止日期可能同時提高資訊的有用化機率、頁面突然失效的風險,以及使用者對時間的敏感程度。如果這些變數受同一未觀測因素影響,單純改變 而把其餘數值固定,只能說明條件性反應,不能直接作出因果推斷。本文敏感度圖因此應稱為比較靜態曲面,而不是對干預措施真實效果的估計。
6.4 值、策略、時間與結果如何連接
效用最大化策略是一條狀態依賴的規則,而不是要求所有分頁同時作同一動作。在基準條件下,、、 對有剩餘等待機會的狀態成立;在 時,。因此同一分頁可以先等待兩週,轉成有用狀態後即時閱讀;另一條路徑可能等待六週後失效而關閉;還有少數路徑到期仍未辨識出用途,因而在期末關閉。這些結局都可以是同一條最適策略下的合理樣本,不能因其中一條路徑「最後沒讀」便倒過來斷言最初的等待必然是錯誤決定。
單一路徑的最終累積效用不是一開始計算的期望值。例如一個分頁等了三次才轉為有用,總折現效用是 。若等待兩次便失效,最終關閉的效用則是 ,並不因為事後沒有閱讀成果而自動回到零。期望值將所有具有不同機率的結局加權平均,而不是預先知道其中哪一條會發生。要評估保留動作是否合理,應看作出決定當時的資訊與可能結果,而非單靠事後成功或失敗的敘述。
模型也展示「狀態確知」的重要性。如果使用者根本不能判定一頁是否已失效,狀態 便無法作為可直接觀察的策略輸入;此時應建立部分可觀察馬可夫決策過程,用信念分布代替當前狀態。類似地,如果閱讀行動本身可以更新一頁對另一頁的價值,分頁之間便出現學習外部性。上述情形需要較大的資訊狀態與不同的觀測方程;我們故意先研究可完整解釋的三狀態情況,讓每一個結果均有清楚的假設來源。
7. 結果:選擇權的價值、等待時間與成本邊界
7.1 有限期價值隨時間上升,卻存在飽和上限
圖 1 呈現未知分頁在不同剩餘決策期下的最適期望折現值。剩餘期限為零時,因無法再等,閱讀未知內容需付出一個負效用單位,因此選擇免費關閉,價值為零;還有一個等待期時,等待淨增益 ,價值直接變為 0.555。此後每增加一期,價值只多一項 ,因此曲線保持上升但邊際增幅愈來愈小。等比形式與二十週數值曲線吻合,是程式和解析式對照的第一個檢查。
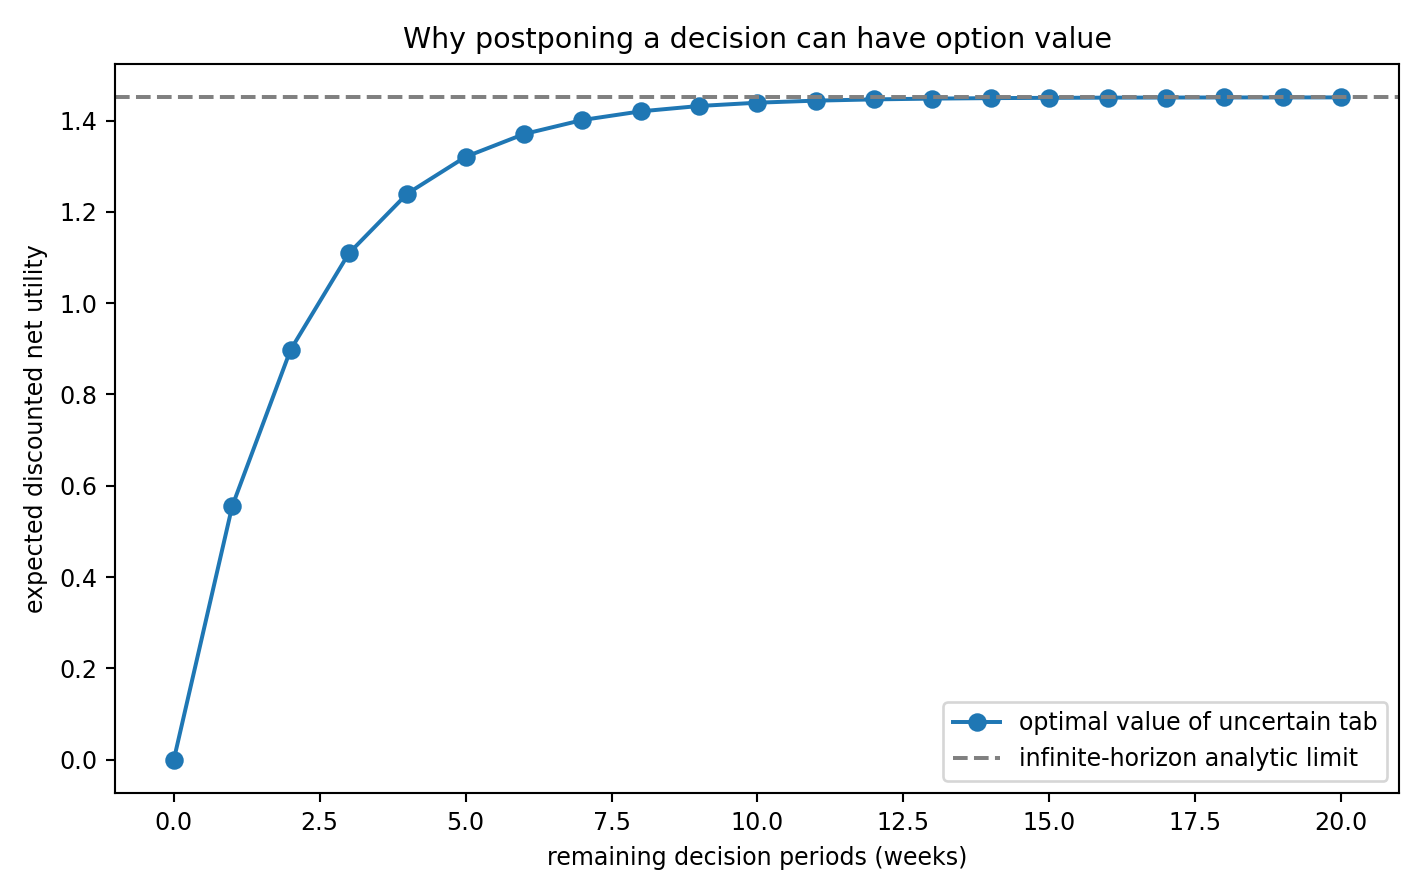
圖 1. 使用合成參數 的期限敏感度。實線為動態規劃值;虛線為無限期封閉式上界。所有點為理論模型或計算值,並非真實分頁存活率。
在基準的十二週情境,動態規劃得 、、。其中第一個數不是將「未讀網頁」本身標價為 1.45,而是在本文假設的資訊到達機率與成本下,讓決策者保留停止權所取得的淨期待效用。正確的比較基準是此刻直接關閉所得的零,以及未知狀態直接閱讀的負一。將同一模型用於另一套成本尺度,三者的相對大小及最優行動均可能轉變。
期限曲線亦揭示一個常被日常直覺忽略的情況:選擇權有有限上界。假如一頁已經等待多期但持續保持未知,繼續再延長可等待期限所增加的事前價值會衰減;系統不會因為「拖得愈久」而憑空增值。這裏的衰減是期初策略比較中的邊際效果,並不是聲稱一個在現實中放置十週的分頁,其主觀珍惜程度一定降低。對同一條條件路徑而言,尚未知時應採取甚麼動作,仍須根據剩餘期限與現時狀態重新計算。
7.2 成本與資訊到達機率構成政策邊界
圖 2 將每週保留成本置於縱軸,未知轉有用機率置於橫軸,以顏色顯示十二週最適效用。從公式可知,在 的區域,關閉帶來零的保證值,其他行動不優,價值曲面因此出現大面積零平台;在 的區域,等待的效用為正,並隨成本下降、每週成為有用的機率上升而提升。這個明確可畫出的邊界,是本文對「應否關掉」最直接的規範性回答。
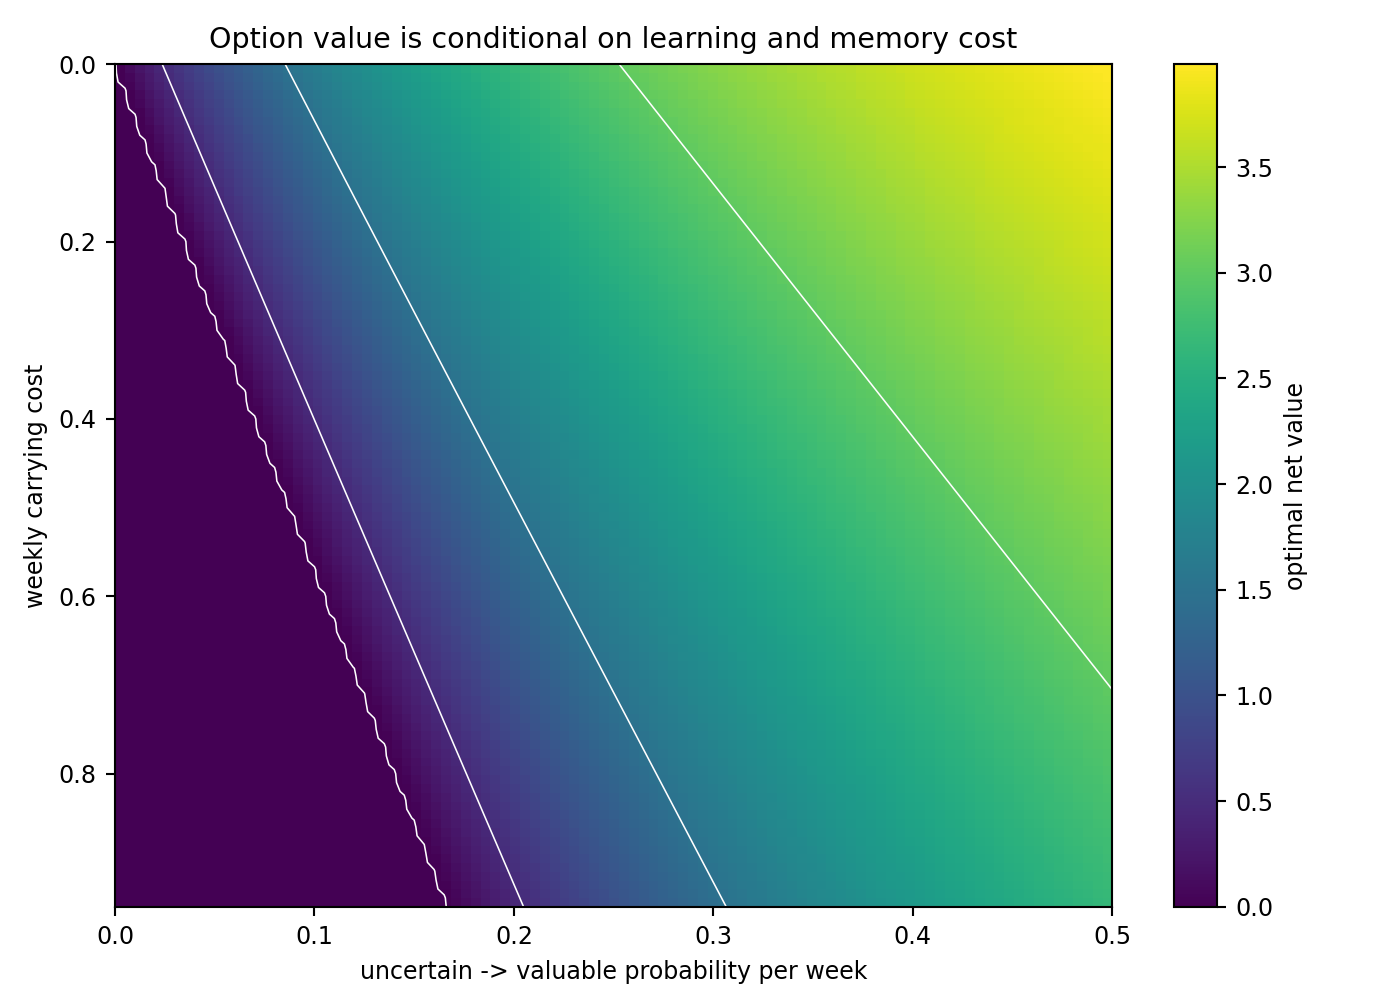
圖 2. 各網格點由同一有限期 Bellman 演算法求得。橫軸是未知分頁一週內變為有用的機率;縱軸是假設效用單位表示的每週成本。零平台代表免費關閉占優,而非觀察到使用者實際關閉網頁。
成本—機率邊界說明「知道自己還有可能用到」並不足以支持永久保留。如果新資訊只有極低機率會到達,即使一旦有用就能帶來可觀效益,每週重複承擔成本仍可能令淨值轉負。相反,某些短期學習或工作情境的資訊到達機率可能較高,暫時保留入口便較有理據。從模型角度,介面若能降低查找與返回的成本,會擴大值得保留的區域;若能令失效資訊更容易辨識,則有助及早把頁面移至關閉狀態。這些是依模型推導的設計含意,尚待實際 A/B 測試驗證。
一個有必要交代的技術細節是:圖 2 中每個條件的機率列均由程式重設為 。即使只改變 ,未知分頁留在未知狀態的機率亦會相應改變;若錯誤地保持其餘兩項固定,列和可能不再等於一,便失去有效機率轉移矩陣的意義。程式包含列和檢查。這類一致性細節對低維模型也很重要,因為精緻的可視化不能彌補錯誤的隨機過程。
7.3 蒙地卡羅值檢驗與路徑結局
圖 3 對 125,000 條人工路徑的最終折現淨效用畫出直方圖。這些路徑全部由同一合成分布產生,並非獨立受訪者,也沒有任何個人資料。模擬平均 ,蒙地卡羅標準誤 ,與理論值 相差 。差額約為 1.15 個標準誤,符合在獨立模擬樣本均值附近常見的抽樣波動尺度,未顯示重大實作不一致。
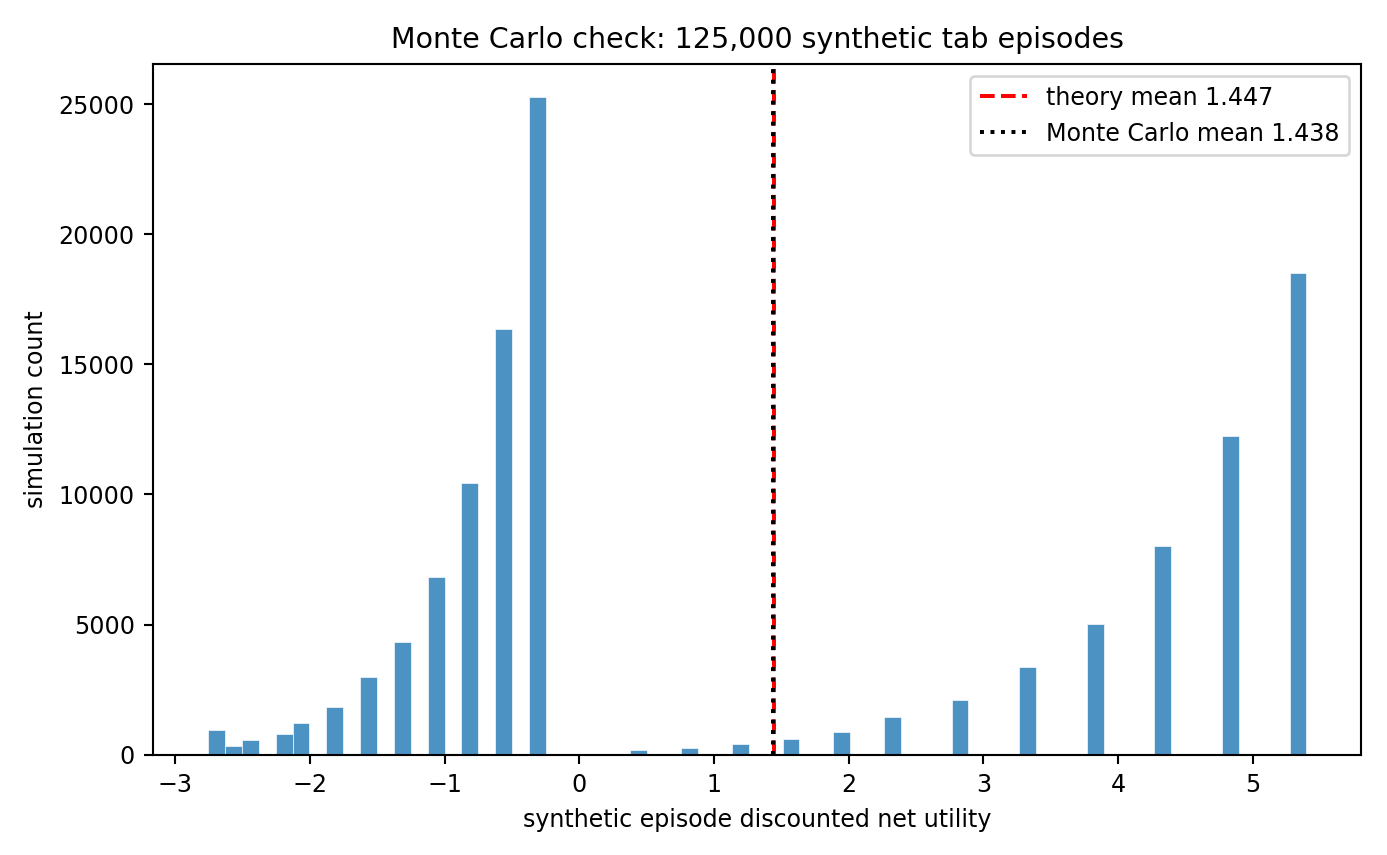
圖 3. 實線和虛線標示模型期望與模擬均值。直方圖的形狀源於離散停止時點、閱讀報酬及重複等待成本;不應稱為真實用戶效用分布。此圖的作用是以不同的求值方法核對理論。
固定一次模擬的標準誤並不是一個涵蓋所有研究不確定性的信賴界。在忽略程式偏差、路徑獨立及方差有限的前提下,常見常態近似可給平均值約 的示意抽樣區間,理論值落在其中。這只說明模擬均值和同一生成機制的期望互相相容。即使其差距小至千分之一,也不能用來證明每週保留成本 0.30、資訊到達機率 0.15 或人類折現因子 0.95 在現實中正確。
圖 4 顯示模擬路徑由開始保留至採取終止動作前,經過了多少個等待期。輸出紀錄的平均值是 2.841632 週;125,000 條路徑中有 53,073 條以閱讀終止,其餘 71,927 條以關閉終止。此比例沒有「只有四成使用者最終真的讀網頁」的社會統計意義,因為它是輸入機率與策略直接造成的人工產物。其研究價值在於提醒我們:即使一項策略在期初擁有正的期望效用,仍有不少路徑最終被關閉,平均等候時間也不是單一固定常數。
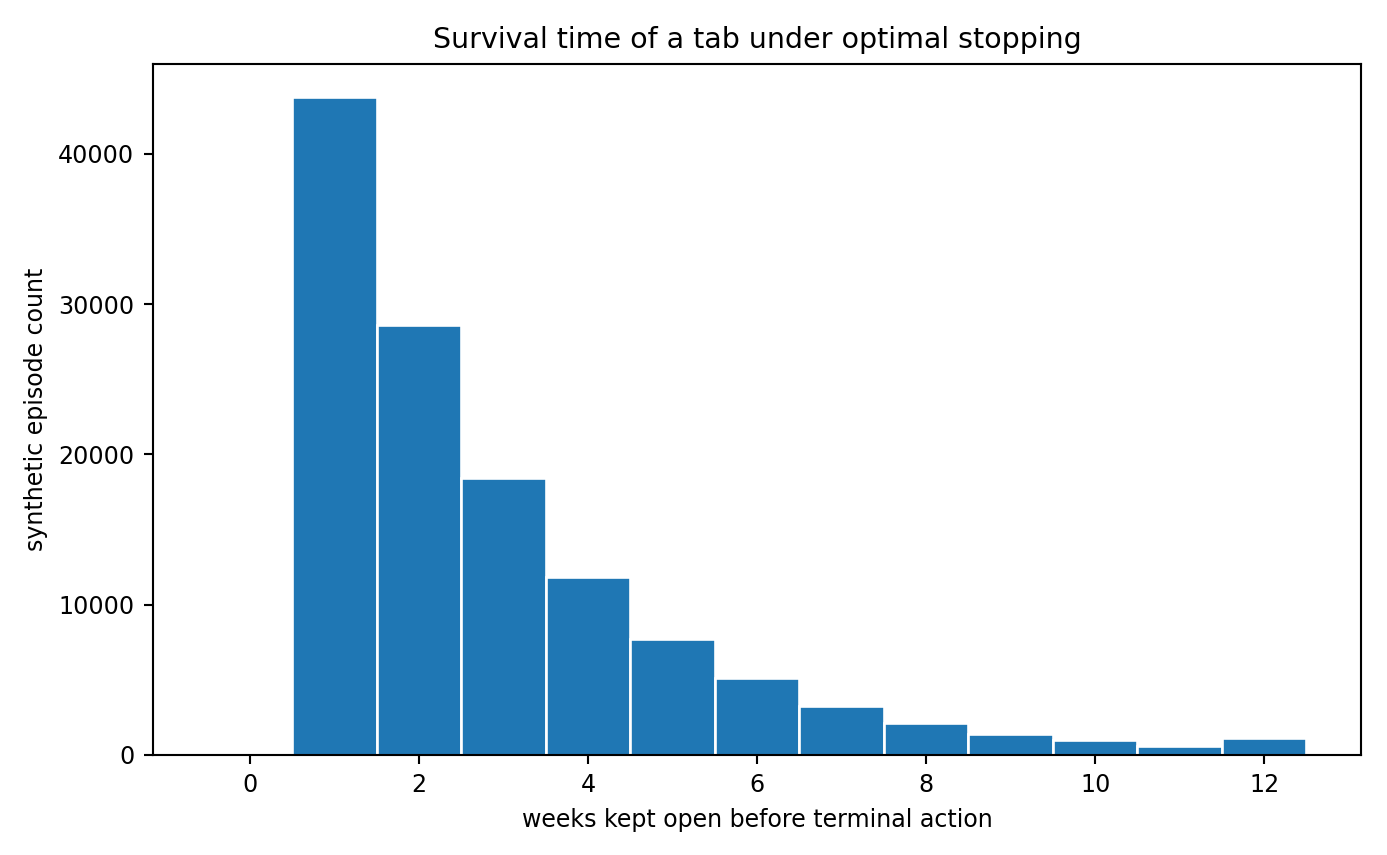
圖 4. 整數橫軸為等待的週數,縱軸為人工路徑的數目;隨機種子是 2026101615。閱讀或關閉後,該路徑不再進行分頁決策。
圖 3 與圖 4 合讀,可以避免一個事後推理陷阱:當一頁最終被關掉,人可能認為此前的等待完全白費;當它最後帶來幫助,則可能認為永久保留任何類似頁面都是合理。動態規劃的評價對象是當時可得資訊下的策略,而不是單一路徑的成敗。蒙地卡羅結果恰好示範了相同政策之下正負淨效用都可能出現。將研究結果轉化成產品建議時,應強調「定期重新評估」,而不宜把結果簡化成一條無條件的關閉期限。
7.4 同時開啟大量分頁的假設擁塞試驗
圖 5 展示第二個純屬示範的情境:設單頁每週注意力成本隨總分頁數 線性增加,。在不改變資訊到達機率的條件下,較多分頁意味著較高持有成本,令單一未知分頁的最適值下降。即使沒有強迫分頁之間互相排斥,只要注意力管理負擔與數量有關,最適策略仍可從等待逐步轉為直接關閉。
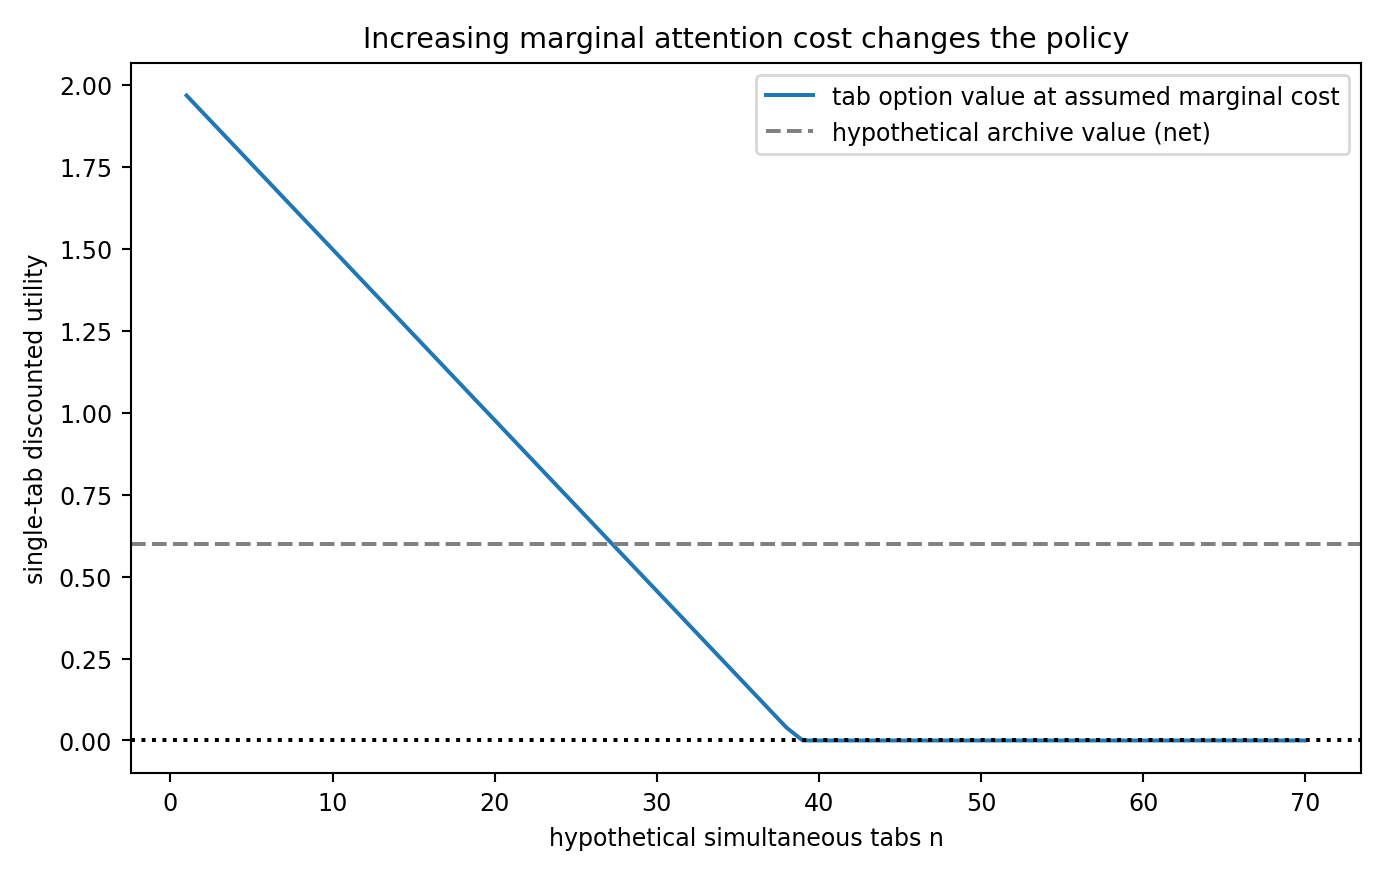
圖 5. 分頁數目不是取自真實裝置;成本規則及淨封存價值 0.60 均為研究者指定。曲線描述單一分頁在各假設背景下的決策值,而非多分頁系統的總效用。直線是用作比較的封存選項,並不是從用戶資料估得的意願支付。
將封存值設定為 0.60 是為了區別「當下關閉且永久放棄」與「整理到可尋回的資料庫」。在更完整的模型中,封存可能保留部分未來價值,同時降低畫面及注意力負荷,但亦可能需要初始分類成本及後續檢索成本。這些不同效用都應進入同一目標函數。本研究只在圖表中加入一條假設封存基準線,因此只可以辨認哪些成本區域值得進一步考慮這個行動,不能宣稱已經完整求出四動作的最適封存策略。這個區分避免把輔助比較線誤報為已整合的 Bellman 政策。
值得注意的是,圖 5 的橫軸並不是「你已擁有多少問題」。若一個人善於把分頁按照專案分組,管理成本可能隨數量緩慢增加;另一個人的分頁如果高度分散、標題雷同且缺乏搜尋入口,成本可能上升較快。這些人的最適門檻會因成本函數不同而改變,因此「超過某數量就應全部關閉」不是本文的結論。模型反而表明,影響行動的應是可解釋的邊際成本、到期風險與未來資訊效益,而不是表面的數字。
8. 討論:最適停止與數碼囤積之間的有限理性
我們可以用「微型選擇權」解釋一部分看似荒誕的分頁行為。保留一頁相當於保存未來在資訊更明朗時才投入閱讀時間的權利;立即閱讀則是提早支付時間代價;立即關閉則放棄該權利換取今後的注意力自由。選擇權的價值不是一項永遠為正的天賦,它完全受機率、效益、折現和成本限制。當新資訊到達的期望增益低於繼續持有的成本時,理性的行動正是停止等待。這套框架既能說明某些暫存的合理性,也不會縱容「永不作決定」成為一種無成本策略。
在日常生活中,一個實際困難是當事人可能不知道轉移機率。系統能否提示「這個分頁所屬任務已完成」?能否從明確的期限、同頁返回次數或使用者主動標記的意圖,推斷它是否仍需等待?這些介面問題可以由模型轉化為可測量變數,但不能從模型本身推斷應使用甚麼感測器或機器學習演算法。若建立推薦系統,應先提供可覆核的規則及使用者可撤銷選項,以免自動關閉一份未備份的重要資料。
對課堂和團隊工作而言,任務中心式的整理可能比「強迫所有人只保留十個分頁」更具建設性。當同一項研究需要持續比較資料來源,關掉全部網頁會造成重建工作情境的成本;當專案結束,保留全部頁面卻可能增加下次搜尋的噪音。可行的產品設計是讓使用者將暫存分頁與任務意圖、預期返回時間以及可搜尋摘要連結起來,並在期限到達時重新評估。這類建議與任務中心式分頁管理的研究方向相呼應,但它們在本文中仍屬待驗證的設計假說。
認知卸載的討論亦不應停留在「外部記錄能降低腦部負擔」。如果外部工具的提示太多、太頻繁或缺乏結構,本來用作卸載的界面也可能增加回憶、辨認、分類及切換的工作。對同一個人而言,認知收益和管理成本可能同時存在,而且會隨任務改變。我們將它們分別放入延遲資訊報酬和每期成本,令這個權衡可以被明確計算。然而兩者在真實認知過程中未必可簡單相加,尤其當疲倦、壓力或多任務切換使注意力的邊際價值發生非線性變化時,線性模型會低估問題的複雜度。
本研究的規範性規則亦不等於一個人的心理診斷。某人可能因害怕錯失、情緒價值、未完成工作的提醒,或單純喜歡保留歷史紀錄而不願關閉;另一個人可能從不利用分頁,所有資料都自動存進書籤工具。若不理解這些主觀目標,聲稱模型「證明人應如此行動」便超出了分析範圍。適當的詮釋是:在明確假定的同一效用尺度、狀態可觀察且行動可選的情況下,Bellman 政策達到該模型內的最大期望值。
「忘記」這個看似純粹心理的詞,還可以被拆成兩種不同機制。第一種是內容或需求客觀上變得無用,可用轉移至 表示;第二種是雖然仍然有用,但使用者不知道如何再次找到或辨識該頁,此時就算物理分頁仍開啟,資訊的可獲性也下降。後者在本模型中被簡化成持有成本或錯誤狀態辨識,並未獨立建模。若要研究「記憶負債」的累積,未來應把重新搜尋成本、標題混淆機率、使用者可用時間與任務鏈接結構分別納入,而不是只把轉移矩陣中的失效機率稱為遺忘率。
還有一項對介面設計有啟示的分辨:頁面關閉與資訊消失未必是同一動作。封存、加標籤、匯出書籤或生成可檢索摘要,可以將視覺負荷降下來,同時保留往後返回的可能性。若封存工具具有搜尋延遲或需要明確分類,它依然有成本;如果保存系統可靠、結構良好,其成本可能低於長期佔據可見分頁欄。真正的最適停止研究因此有理由將「整理」視為第四個動作,但在取得其實際成本與重新取回成功率之前,不應直接將概念上的好處換算為確定的效用數字。
本文可引出一個可操作但仍需經驗測試的設計原則:與其持續顯示所有未讀頁面,不如協助使用者在每個決策時點回答「我等待的是甚麼新的資訊」、「若沒有新資訊,下一個停止時點是何時」、「有沒有低成本方法保留入口」。這三個問題對應模型中的 、期限 和成本 。介面只需以清楚的設定引導思考,未必需要用黑箱方式估計每個人的心理效用。模型的價值在於幫助提出可以驗證的問題,而不是先行替人下結論。
9. 研究限制與效度威脅
第一項限制是參數的來源。轉移機率、閱讀收益、每週成本和折現因子均為合成示例,沒有經過訪談、日記研究、受控實驗或瀏覽器事件紀錄估計。因此我們只能回答「如果使用者面對這一組機率與效用,應如何行動」,不能回答「香港大學生平均保留多久」或「大部分人因甚麼原因累積分頁」。這是模型的規範性邊界,亦是所有圖表必須保留合成資料聲明的原因。
第二項限制是完全可觀察狀態。模型假設決策者每期能準確知道分頁屬於未知、有用或失效,但現實中往往要付出搜尋或閱讀成本,才能確定它已經不再重要。若辨認狀態的過程本身具有成本,單純將 與 視為即時可見,會低估資訊更新的難度。比較合理的下一步是把「實際需要」當成不可直接觀察的潛在狀態,並用使用者可見的線索更新信念。這會令每期決策由簡單三狀態的選擇,改為對一個機率分布進行最適停止。
第三項限制是獨立分頁與固定時間尺度。許多分頁屬於相同任務,閱讀第一頁可能令另一頁更易理解,也可能因已找到答案而使另一頁失效;在不同時間點,使用者的可用注意力也不相同。單頁馬可夫模型不能捕捉互補性、重複性、跨頁線索或共同期限。圖 5 只提供一個外生擁塞成本函數,並沒有模擬多個分頁同時轉移、爭奪閱讀時間及改變互相的資訊價值。對群組分頁的最佳清理政策仍屬開放問題。
第四項限制是效用形式及行為假設。我們選擇固定折現和線性期待效用,原因是能給出封閉式解並接受完整數值核對;人可能具有現在偏誤、損失規避、情緒價值、風險偏好、不同任務的優先次序,以及不能量化的知識整理目的。若一個人認為某些頁面具有重大不可逆的資料遺失風險,免費關閉所得的零便不是適當基準;若閱讀本身可以帶來享受,未知頁的即時閱讀淨報酬也未必是負一。改動任何一個核心假設,都應重新求解模型,而不能直接套用 作普遍建議。
第五項限制是文獻研究的可獲性。本稿在可用的 Crossref 書目搜尋中查驗五個相關出版物的標題、DOI、年份及部分出版場所,但未取得其全部全文。故文獻部分只用來建立研究領域及概念脈絡,沒有提供未親自查核的實證樣本、效果量或逐字引述;未核實的作者細節亦沒有憑記憶補充。如此處理可能犧牲文獻回顧的全面性,但可以防止虛構書目與從標題反推結果的錯誤。
第六項限制是電腦計算的外部效度。蒙地卡羅結果和 Bellman 解的接近,只能檢驗推導、程式及隨機模擬的內部一致性;它完全不能判定那些轉移機率描述了真人或真實網站。即使重複一千萬次同一合成過程,也不會增加參數對現實的代表性。若要建立外部驗證,應先設計符合私隱及知情同意要求的資料收集方案,並區分任務相關與無關的分頁,再比較預測停止時間與實際決策。此步驟並未在本文執行。
最後,工具與呈現亦存在限制。圖表的英文字軸是為減少不同作業系統對中文字型支援不一致而設;論文仍使用繁體中文解釋所有坐標與模型意義。PDF 排版的字型、公式與圖表應在輸出後逐頁檢查,不能單靠 Python 成功回傳便宣稱排版無誤。任何讀者重用程式時,亦應先核對相依程式庫、固定亂數種子及停止時點規則,才對照數值。
10. 結論:不是每個未關分頁都值得留下
本文把未讀分頁的去留寫成一個可解析的有限期最適停止問題。基準合成模型中,未知分頁值 1.446521 個效用單位,應暫時等待;已確認有用的分頁應即時閱讀,已失效的分頁應關閉。保留未知分頁的嚴格正值條件,在本文特例中是每週持有成本小於得到有用資訊的折現期待收益,即 。這個條件解釋了為甚麼低成本、有真實資訊更新可能性的暫存可以是合理策略,同時也清楚交代甚麼情況應停止等待。
對同一組合成參數,有限期動態規劃、無限期封閉式及固定種子的 125,000 條蒙地卡羅路徑互相符合。敏感度分析顯示,持有成本上升可使選擇權價值從正變為零;示意性的多分頁成本函數又說明管理負擔增加可改變單頁最佳策略。然而所有數值都是模型內的結果,不能外推為使用者實測效益,亦不能把四角色內部模擬審稿當成正式期刊認證。
最值得保留的結論是一個方法論區分:分頁被保留不必然不理性,分頁被關閉也不必然正確;評價一項決策,要考察當時可得的資訊、有待出現的證據,以及持有和行動的成本。若能在日常介面中把這些因素變得更可見,便可能減少無目的的累積,同時保留真正有用的搜尋入口。這仍然是一項有待實際使用者研究檢驗的設計假說。
11. 未來研究方向
下一階段可以建立部分可觀察馬可夫決策過程。分頁是否仍然有用,通常無法直接從標題判斷;若介面能顯示上次閱讀的日期、任務截止期或預計返回時間,系統便可用這些線索更新分頁的信念狀態。此模型需要額外定義觀測噪音與訊息取得成本,並比較錯誤關閉重要資訊與長期維持過多頁面的不同損失。它比本文完全可觀察的模型更接近實際,但也更需要經驗校準。
另一方向是建立多分頁的動態背包或指數政策問題。當每週只有有限閱讀時段,而多個未知分頁會同時轉移,決策不只是關閉哪個頁面,還包括先閱讀哪一個、何時封存,以及如何處理互相依賴的任務。可將網頁之間的知識依存建成有向圖,使用近似動態規劃或強化學習尋找可解釋的調度規則,再與簡單的最早到期、最高預期值和任務分組基線比較。無論選用何種模型,都應保留免費關閉或封存的明確替代選項。
若取得符合倫理及私隱要求的匿名化任務日誌,可設計前瞻性實驗,請參與者自願記錄分頁目的、預計處理日期與實際返回事件,而不用擷取網頁內容或個人帳戶資訊。隨後可以估計每週轉移概率、持有成本代理變數,以及不同任務類型之間的異質性。預註冊研究應清楚列出主要結果指標,例如重新取得有用資訊所花時間、意外失去重要連結的比率與任務完成度,而不能只用可見分頁數當作唯一成功標準。
最後值得研究的是價值單位的確立。本文用抽象效用單位示範結構,但真實介面干預需要權衡時間、認知負荷、資料遺失風險與可恢復性。可透過選擇實驗或完成任務後的反思資料,估計不同使用者對閱讀、封存及關閉的相對偏好,並在跨任務條件下測試穩定性。直到這些實證步驟完成以前,本文應作為研究方案的數學基線,而非經臨床或社會驗證的個人習慣改善處方。
12. 參考文獻(References)
以下五筆書目均由 Crossref 題名查詢獲得對應 DOI 及出版基本資訊,個別作者、頁碼與全文未在本次環境中完整核實;因此使用已核實的題目先行列示,不補造欠缺的欄位。詳見 Reference_Check.md。
- Risko, E. F., & Gilbert, S. J. (2016). Cognitive offloading. Trends in Cognitive Sciences. https://doi.org/10.1016/j.tics.2016.07.002
- Tabs.do: Task-Centric Browser Tab Management. (2021). The 34th Annual ACM Symposium on User Interface Software and Technology. https://doi.org/10.1145/3472749.3474777
- Information Foraging. (2009). Encyclopedia of Database Systems. https://doi.org/10.1007/978-0-387-39940-9_205
- Prospect Theory: An Analysis of Decision under Risk. (2000). Choices, Values, and Frames(文集版本). https://doi.org/10.1017/CBO9780511803475.003
- Applications to Optimal Stopping Problems. (2014). Universitext. https://doi.org/10.1007/978-3-642-37632-0_11
附錄 A:符號表、重現與驗算約定
-
狀態: 依次表示未知、有用及失效。動作: 依次表示關閉、立即閱讀、等待。
-
剩餘期數:。逐期折現因子:。每期等待成本:。
-
未知轉有用、未知轉失效、維持未知的機率依次為 、、。
-
三狀態閱讀淨效用:、、,屬同一合成效用尺度。
-
遞推常數:,。最適期望值:。
-
擁塞敏感度的假設分頁數 由 1 至 70,對應外生成本 ,未用真人資料估計。
執行 Cycle_002/Paper_015/analysis.py 可重製全部合成圖表及 CSV/JSON。主要核對項目為每個轉移列加總等於一、末期無等待動作、基準最適行動依次為「等、讀、關」、有限期 與解析式一致、蒙地卡羅均值和理論差距按標準誤判斷,以及所有合成路徑最後必須終止。讀者應查看 data/summary.json 而非從圖片估計精確小數。
本研究的「模擬審查」是研究團隊內部採四種角色進行的自我批判程序,不涉及真實匿名審稿人;內部審查及修訂紀錄在 review.md。全部模擬結果只屬於指定的機率機制;不應借本文結果斷言任何特定使用者的注意力、心理狀態或行為傾向。