Why Does One Wet Wipe Pull Out Another? Adhesion Thresholds, Extraction Cascades, and Optimal Separation Design
研究單位: 荒誕學術研究所(Institute of Absurd Academic Research) 研究類型: 理論建模與可重現合成模擬 日期: 2026-10-16
中文摘要
理想的濕紙巾包裝,每次應只取出使用者所需的一張;現實生活中令人煩惱的情境卻是第一張牽出第二張、第二張又牽出第三張,形成未經邀請的紙巾隊伍。本文不聲稱已觀察任何品牌或消費者,而是將此日常問題轉化成可反駁的隨機連鎖模型:指定每個紙巾界面成功牽引下一張的機率,推導有限容量幾何分布;再容許包裝內存在一個 Beta 分布的共同黏附傾向,得到 Beta-geometric 混合、尾部風險及有限容量解析矩。以每包剩餘十二張、平均牽引機率 0.28、共同風險相關係數 0.18 的純假設基準,固定機率模型期望抽出 1.388889 張,而共同環境模型為 1.544314 張;至少抽出五張的機率由 0.006147 增至 0.032428。180,000 次固定種子蒙地卡羅抽取與解析式之平均值差約 0.000331 張,最大分布質量差約 0.000916。本文另提出假設性的濕潤黏附曲線及增加分離阻力的設計成本函數,說明最佳控制取決於未量測的物理參數與損失權重。所有數值均源於數學假設,並非真實濕紙巾的試驗數據。結果的核心貢獻是指出「平均每對紙巾有多黏」不足以表徵多張連抽風險,包裝層級的異質性及有限數量約束同樣不可忽略。
關鍵詞: 濕紙巾、毛細黏附、截斷幾何分布、Beta-geometric 混合、尾部風險、隨機連鎖、可靠度、最適設計
English Abstract
Pulling one wet wipe from a package can unexpectedly drag out several more. This paper formulates the phenomenon as a finite stochastic extraction cascade without claiming any observations of commercial products. Under constant inter-sheet propagation probability, the number of extracted sheets follows a capacity-censored geometric distribution. A latent Beta-distributed pack propensity produces a finite Beta-geometric mixture, with a heavier upper tail than the constant-propensity model at the same mean. For a hypothetical twelve-sheet pack, mean propagation probability 0.28, and latent correlation 0.18, the expected number of extracted sheets increases from 1.388889 to 1.544314; the probability of extracting at least five sheets rises from 0.006147 to 0.032428. The exact distribution is corroborated by 180,000 seeded Monte Carlo episodes. We also study a deliberately assumed nonmonotonic wetness–adhesion relation and an optimization problem balancing extraction waste, tail risk, and separation effort. The analysis establishes theoretical mechanisms and testable predictions under explicitly stated assumptions. It contains no real-world product measurements, participants, or experimentally estimated parameters.
Keywords: wet wipes; capillary adhesion; geometric mixtures; cascade; tail risk; reliability; optimal design; synthetic simulation
1. 引言:一次拿一張,為何像拉出一列火車?
濕紙巾的包裝把大量薄片堆放在狹小空間,消費者透過開口抓住一角,期望手上只出現一張。但當第一張的末端和下一張仍接觸,取出的運動可能在相鄰界面傳遞拉力,讓第二張也跨過封口;而第二張如果仍然和第三張黏連,連鎖便會持續。這個問題的趣味不在於「紙巾不聽話」的擬人說法,而在於一個單次目標如何透過局部接觸轉化為多次結果。類似現象在片材送料、薄膜剝離、紙張分頁和接觸網絡中均可能出現,但每種裝置的材料和邊界條件不同,不能以某一材料的實驗數字直接推測另一材料。
直覺上,多張連抽可能源於紙巾太濕、包裝開口太大、抽取太急或折疊方式欠佳。這些解釋有時合理,卻缺少可檢查的定量結構。例如,一包紙巾有二十八百分比機會把下一張牽出;這句話是否足以預測一次拖出五張或更多的機率?如果同一包較濕的紙巾在所有界面都比另一包更易黏連,即使兩批所有界面的平均牽引機率相同,偶爾發生長串的風險仍可能不同。研究的第一個目的,就是用一個已知解析解的基線模型揭示這項差異,而非先把所有偶然事件塞進難以解釋的大型模擬。
我們把「一包中的一次抽取」定義為研究單位。令隨機變數 N 為單次動作後離開封口的紙巾張數;N=1 是符合目的,N≥2 是額外抽出,N≥5 則作為本文自訂的極端連鎖閾值。這裏的五張純屬量化分析選取的判準,並非消費者偏好調查所提供的臨界值。一次抽取開始時至少取得第一張;然後每次只有最末端已被牽引的紙巾,才有機會再把一張相鄰紙巾帶走。換言之,這是一條線性連鎖,並非樹狀分枝。若包裝僅剩 m 張,任何連鎖都不得超過 m。忽略這項物理上明顯的限制,便可能使機率分布容許抽出不存在的紙巾,特別在高黏附情況中產生荒謬結果。
本研究專注於四種相互聯繫、卻必須分別處理的問題。第一,固定黏附機率下,連鎖的平均張數、方差及長尾風險如何計算?第二,若每個包裝都有不同的共同黏附傾向,而一包內各界面在給定傾向後才獨立,會否系統性提高多張連抽的發生率?第三,能否以可辨識參數組成一條物理啟發、卻不冒充實驗定律的黏附曲線,探討濕度與接觸力的非線性關係?第四,若增加分離結構的強度可以減少連鎖,卻需要材料、力度或使用負擔,模型中的最佳強度會在哪裏?
本文會明確區分文獻對「濕紙、液橋、黏附與剝離」機制的支持,和我們自行提出的「紙巾包裝連鎖機率」假設。前者可以提供研究背景,卻不能讓後者憑空成為實測定律。所有繪圖資料由 Python 程式重新生成;分析同時採用解析矩、數值積分及固定種子蒙地卡羅,讓不同方法互相檢查。研究不採訪消費者、不記錄品牌、不測量拉力,因此結論的可信程度被限定在模型的數學一致性之內。即使看似令人信服的「最優分離強度」,亦必須保留成本權重完全虛構這個條件。
一個值得注意的教訓是,日常抱怨往往以平均經驗描述問題,例如「十次裏有幾次抽出兩張」。然而服務品質上的真正不便可能由罕見的長連鎖主導,因為一次抽出七張所造成的額外整理,未必只是一次抽出兩張的六倍。這涉及風險函數究竟量度平均浪費、嚴重事故概率還是時間成本;如果沒有先定義結果與損失,就無法嚴肅地說某種設計「較好」。本文因此先建立純概率的可核查關係,再討論使用者效用如何改變排序。
2. 文獻回顧:從濕紙的毛細力到隨機分布的混合
van de Ven(2008)的〈Capillary Forces in Wet Paper〉明確把研究對象放在濕紙及兩張濕紙之間的毛細作用,為本研究挑選界面力作為候選機制提供了直接的材料科學背景。需要特別指出的是,該文研究的是濕紙界面與力學,而不是市售濕紙巾包裝的一次連抽張數。從物理界面研究到日常包裝操作之間,尚有折疊路徑、容器邊緣、接觸角、紙張纖維方向、拉力速度等未測量的因素;因此不能把文獻的某個力值代入本文抽取概率。
Persson 等人(2013)討論紙張纖維黏附與濕度,並考慮纖維表面形貌、變形及水致接觸機制。Belle 與 Odermatt(2016)綜述初始濕紙網的強度及纖維相互作用,提醒讀者濕潤紙材除了存在界面黏連,其自身抗拉、變形和破裂也是同一問題的不同部分。如果第一張紙巾在出口被撕斷,後續連抽可立即停止,但那不等於系統成功給出完整的一張。因此我們將紙張完整度視為獨立的工程品質維度,並在後續研究指出一個只最小化連抽的設計也可能增加破裂風險。
Borri 等人(2016)的研究利用紙層剝離測試及統計建模討論黏結層的力學行為。這項研究尤其有助理解,分離事件具有局部界面狀態、力–位移過程與材料黏結的因素,不能簡化成完全不受前史影響的抽象硬幣。但本文刻意從較少參數的 Bernoulli 模型出發,其意義是建立一項可供未來測試否證的零假設:在同一包裝的條件機率已知時,各連續界面的傳遞事件是否可近似看作相互獨立?若未來量測出相鄰位置隨時間變得更易黏連,就必須修正這個條件獨立假設。
Wexler、Heard 與 Stone(2014)研究柔軟基材之間的液橋及變形;Butt 與 Kappl(2009)綜述正向毛細力的物理描述。它們共同提示,液滴或水膜會牽涉表面張力、曲率、接觸幾何與彈性回應。然而把這些理論轉成「下一張一定會被帶出」仍需比較界面向外傳遞的拉力和封口或折疊的抵抗力。紙巾究竟何時繼續移動,取決於一個閾值競爭,而非某個單獨分子作用的存在。本文以連鎖機率 p 概括這個閾值事件,並坦承它吸收了大量尚未分別辨識的因素。
Peng 等人(2022)在特定多重粗糙界面系統上研究水致毛細黏附、氫鍵和摩擦之間的非單調關係。這不是證明「越濕的濕紙巾反而越不黏」;它只提醒我們:把含水量對牽引機率的影響假設成永遠線性增加,並非唯一合理的模型選擇。Colbeck(1997)關注接觸角、表面粗糙度與濕表面黏結,Ha 與 Kim(2020)則從較大尺度概述軟質多孔材料的毛細作用、吸液與形變。這些資料使我們有理由設計非單調性的敏感度實驗,但實驗曲線的峰值位置、曲率及尺度全部仍須來自實際測量,不能由其他基材原封不動移植。
在概率研究方面,Daniels(1961)討論幾何分布的混合表示,提供本研究將包裝共同異質性整合為混合分布的統計背景。幾何分布常見於固定成功機率的重複試次,其無記憶性使公式容易計算;但倘若每一個抽取事件都有隱藏機率參數,混合之後的整體分布便不一定保留無記憶性。本文採用 Beta 分布,只因它定義在零至一之間、矩容易計算,並能透過平均值和濃度調節異質性。這不代表紙巾包裝的真實黏附傾向已被證實服從 Beta 分布,更不能把一般統計分布研究當成某品牌紙巾的品質報告。
綜合以上文獻,可以確認濕紙黏附、纖維機械、液橋和摩擦具有真實學術基礎,而以隨機連鎖作為待驗證的現象模型具有合理的研究動機。仍未解決的空白包括:對每個相鄰紙巾界面究竟如何定義「牽引成功」、包裝內共同環境怎樣造成正相關、連鎖尾部如何受剩餘張數截斷,以及如何把分離設計的收益與成本連成可重現的決策問題。本文的數學工作集中在這些問題,沒有冒稱上述文獻已經在完全相同產品上給出答案。
3. 研究問題、假設與可否證命題
研究問題 RQ1 是:已知單一固定傳遞概率 p 及有限容量 m,能否完整確定連抽數量 N 的分布、期望和極端事件概率?其零基準 H1 是條件獨立的逐界面傳遞機制,直到第一次斷開或抽空包裝為止。任何觀察到的實際連鎖張數若無法由此分布合理描述,便是提示模型不足的直接訊號。把 H1 稱為假設尤其重要,因為「一次抽取」內的每個界面不一定有相同接觸面積或封口阻力。
RQ2 問:在相同的邊際傳遞概率下,若每包的隱藏 p 存在變異,是否會增加至少三張及更多張的抽出概率?H2 指出,當該隱藏參數並非退化常數,且相鄰接觸事件在給定 p 後獨立,從第三張開始的尾部機率會因冪函數的凸性而不低於固定平均的結果。值得區分的是,抽出第二張的概率只取決於 E[p],所以兩個模型對最常被問的「會不會多出一張」可以完全一致,卻對「會不會連出五張」給出相差數倍的估計。這一看似矛盾的關係,是本文最重要的可檢查數學命題。
RQ3 問:若界面力的產生與消失取決於含水量、表面接觸和封口抵抗,是否有可能出現非單調的連抽機率?H3 並不聲稱真實樣本必然如此,而是提出具體的反例構造,證明單調性不能單靠「液體有黏附作用」推得。日後實驗可以測試假設的曲線是否存在峰值;若資料在所有控制條件下均嚴格單調,則應拒絕所提形狀,改用更適合的力學或經驗模型。
RQ4 是:增加分離裝置的強度 d 時,浪費紙張及極端連鎖風險可能下降,但分離設計也可能耗費材料或使用力度,在明確成本函數下是否存在內部最優點?H4 只在指定的損失權重、控制效率和概率轉換公式下進行定量比較。若缺乏真實設計成本估算,就不能把最小化合成函數所得的 d 值當作生產建議;相反,應報告最適值對參數與風險權重的敏感性。
以上假設的證據層級有別。H1 和 H2 屬於可精確推導的概率模型;H3 屬於物理啟發的候選函數;H4 屬於人工效用設定下的最適化。它們可以透過解析式、數值積分和程式執行檢查數學一致性,卻不能僅以數值重現便聲稱實際消費者行為獲證實。所有定量結果的條件邊界將在方法、結果和限制中重複標示,以防讀者將看似精密的小數位誤認為量測的精準度。
4. 理論框架:界面閾值、共同環境與有限連鎖
一次完整的濕紙巾抽取,至少包括抓取、滑移、界面力傳遞、封口邊緣阻擋和相鄰紙張分離等程序。若用連續力學描述,每張紙巾都可能有不均勻形變,水膜可能沿纖維滲流,局部摩擦和黏附力也可能隨時間改變。由於本文完全沒有獲得這些物理參數的測量,若立即建立精細有限元素模型,只會把未知因素藏在更多假設之中。因此我們選擇最小但明確的二元決策:當一張紙巾被拉動時,它能否把下一張越過出口?每個相鄰界面都可產生一個答案為「是」或「否」的傳遞事件,這些事件按照紙巾由上往下的順序排列。
將第 j 個界面的實際傳遞力記為 T_j、封口及折疊造成的分離閾值記為 R_j。只有在 T_j>R_j 時,下一張才會被牽出。這個簡化可能忽略慣性與紙張斷裂,卻提供了概率模型的物理解釋:傳遞概率 p 是在指定操作條件下 P(T_j>R_j)。如果不同紙張的接觸狀態和阻力相同且獨立,便有單一固定 p;如果同一包中具有共同的濕潤程度或壓縮歷史,則 T_j 的分布可能共享一個潛在狀態,導致不同界面傳遞事件出現正相關。在這一層次上,概率不是魔法數字,而是未知力學變數超過閾值的機會。然而本文沒有量測 T_j 與 R_j,也沒有證明任何指定的機率分布是材料真相。
模型中最重要的兩個層級不能混淆:一個是單個界面是否成功傳遞;另一個是整包共同環境如何改變所有界面的傳遞機率。設 Z_j=1 表示第 j 個界面成功把下一張牽走,Z_j=0 表示斷開。若所有界面都具有固定 p,則每個 Z_j 是獨立 Bernoulli(p)。但在 Beta 混合模型中,每次抽取首先抽取一個隱藏共同參數 P;條件在 P=q 時,每個 Z_j 是獨立 Bernoulli(q),而若不給定 P,事件不再獨立。這是層級概率模型,不是聲稱濕度可以被一個單一實體讀數完整表示。可能還有不同紙張方向、摺疊幾何和先後順序的作用,本文以其差異作為隨後擴展的研究問題。
「共同風險」特別容易在日常敘事中引起誤解。假設某一次抽取發現前面三個界面都會牽連,並不表示第三張的拉力使第四個界面實際變得更黏;即使每個界面在給定 P 後完全獨立,觀察到連續三次牽引成功,也會使我們更相信正在抽取的是一包本來就容易黏連的紙巾。這是一種貝氏條件選擇或存活者效應,跟真正由拉扯產生的新形變、濕度再分配或連鎖反應不同。若未來研究把兩個機制混為一談,便可能在設計干預措施時找錯物理原因。本文會以離散危險率說明這項推理上的差別。
除了界面黏連,包裝內的剩餘張數也是另一項必要限制。設開始時尚有 m 張完整紙巾,N 只能取 1、2、…、m。到達最後一張時,連鎖是因為庫存耗盡而被迫停止,並非觀察到一次真正的「成功分離」。統計學上,這個情況是容量截斷造成的尾部事件匯集;不能把 N=m 直接當作最後一個界面斷裂,也不能用普通未截斷幾何分布的概率質量套入最末項。尤其當共通 P 接近 1 時,抽空包裝的概率可能明顯大於固定平均模型,必須把最後一格的概率寫成存活機率。
我們亦把使用者損失拆成三個部分。第一是每多抽出一張的預期代價,近似浪費、整理或再次放回包裝的負擔。第二是嚴重連鎖事件的額外風險成本,允許對五張或以上的事件附加較高權重。第三是加強分離設計的努力成本,例如更窄的出口、更強的分片結構或使用者需付出的拉力。這些成本在本研究中全部是無量綱的人工單位。若某項分離設計降低連抽卻顯著提高完整紙巾撕裂的概率,現有成本函數就會遺漏重要風險。因此最佳化結果必須理解成條件性的數學答案,而不是一項已評估安全與使用體驗的產品設計。
5. 研究方法與可重現計算設計
研究採用三層核對。第一層是封閉形式解析推導:在固定 p 下推得截斷幾何分布,在 Beta 混合下利用 Beta 函數的比值求出存活概率、機率質量、平均值及方差。第二層是確定性數值積分:對干預後不再是多項式的概率轉換,使用 Gauss–Jacobi 節點及歸一化權重計算 Beta 分布期望,再以有界一維最佳化搜尋最小成本。第三層為固定種子的 Monte Carlo 模擬:先為每個合成抽取事件產生共同傾向 P,再逐界面擲出條件 Bernoulli 事件,直到斷鏈或庫存耗盡。三層方法會產生不同形式的數值證據,能用來辨識程式錯誤,卻不會把人工模型變成實地實驗。
基準容量為 m=12 張,平均傳遞概率 μ=0.28,共同環境相關係數 ρ=0.18;這些數字全由研究者設定以展示差異,沒有使用產品廠商、消費者或任何網絡評論的數據。相應 Beta 參數由平均值與相關性反推為 α=1.2755555556、β=3.28。固定機率比較模型以 p=0.28 表示相同的邊際牽引率;兩者的第一個界面成功概率完全一樣。為評估尾端,定義 P(N≥5) 為其中一個主要指標,另記錄抽出至少兩張、整包十二張全部被帶出、期望多出張數和方差。研究報告始終一併提供完整的概率質量,避免只報告對模型有利的一種尺度。
每個合成情境共產生 180,000 次單次抽取,以整數種子 2026101617 初始化 NumPy 的隨機生成器。對每一次抽取,只產生一個隱藏 P;對最多十一個界面按序抽樣,停止後即使後面界面仍存在,也不再產生能改變抽出數量的傳遞。這裏的「樣本量」是程式抽出的獨立合成事件數,絕不是招募了 180,000 名受訪者或量測 180,000 包真實紙巾。高精度數值與理論吻合,只是說明演算法在所寫的模型下工作正常。正因來源完全人工,本文沒有宣稱任何 p 值、顯著性檢定或真實產品的信賴區間。
在不同異質程度的敏感度分析中,固定 μ=0.28,讓 ρ 從 0 到 0.45 改變,並比較期望抽出張數和五張以上概率。ρ=0 表示 P 退化為常數,作為固定 p 的解析極限,並非直接呼叫無法定義 α、β 的 Beta(∞,∞)。當 ρ 接近 1 時,模型表示非常劇烈的共同變異,但數值不應外推為任何真實包裝的最大可行相關程度。研究選用較溫和的顯示範圍,以便觀察同一平均率下風險曲線如何變化,並不假設現實濕紙巾的 ρ 必然落在這個區間。
最佳化部分採用分離強度 d∈[0,1]。d=0 代表沒有額外分離干預,d=1 代表本文設定的最大干預強度。干預會使給定 P 的傳遞勝算乘上一個隨 d 下降的因子,衰減係數設定為 2.3。每單位額外紙巾成本為 1,五張及以上事故的額外權重為 0.55,分離設計努力成本為 0.20d²。三種異質情境 ρ∈{0.08,0.18,0.35} 使用同一組成本,令不同結果可以歸因於模型內共同傾向的變化,而非偷換懲罰函數。所有權重都是單位化的示例,未做問卷、製造成本核算或拉力試驗。
圖像採用五個互補視角:第一幅將尾部存活率畫在對數尺度,方便比較罕見長連鎖;第二幅把每個抽出張數的機率質量與 Monte Carlo 結果放在一起;第三幅比較共同變異與平均張數、極端事故風險的關係;第四幅將優化成本隨分離強度的變化畫成曲線;第五幅說明一個假設性、非單調的濕潤–黏附反例。圖一至圖五均由程式 analysis.py 生成,資料表、種子、參數與輸出摘要放在 data/,不依賴私人資料、未公開模型權重或外部雲端模擬服務。
本研究以可重現性作為最低門檻:解析概率總和必須為一、所有概率必須非負、固定模型與混合模型的第一個牽引概率必須同為 0.28,混合模型的長尾不應違反 Jensen 不等式,模擬平均與理論值的差距須在可由抽樣變異解釋的範圍內。程式內設有自動 assert,遇到明顯不一致即停止輸出正式報告。這些檢查不保證研究問題的生態效度,卻可以降低由下標錯誤、最後一格質量漏算、隨機種子遺失或最佳化目標方向弄反而導致的數學錯誤。
6. 數學模型與主要推導
6.1 固定黏附概率與截斷幾何分布
設包內原先有 m≥1 張紙巾,P(Z_j=1)=p,所有可以到達的界面傳遞事件在固定模型下獨立。若最終抽出 k<m 張,代表前 k−1 個界面全部成功傳遞,而第 k 個界面失敗。因此 k<m 時的概率質量為 (1-p)p^{k−1};若 k=m,則只需要前 m−1 次均成功,因為後面已無紙巾可牽出,故概率為 p^{m−1}。這項末端質量是容量右設限,並非普通的幾何失敗事件。
用等比級數檢查歸一化:(1-p)∑_{k=1}^{m−1}p^{k−1}+p^{m−1}=1。當 p=0 時永遠只有一張;當 p=1 時每次都抽盡 m 張;中間的所有 p 均給出有效的概率分布。若沒有把最後一項設為 p^{m−1},便會把包內全部紙巾被牽出的事件錯誤分配給一個不存在的第 m 個失敗界面。此處的尾部觀點尤其簡潔:N≥k 當且僅當前 k−1 個界面均傳遞成功,所以 P(N≥k)=p^{k−1},對 1≤k≤m 成立。
任何只取正整數值的隨機變數都有尾部加總恆等式 E[N]=∑_{k=1}^{m}P(N≥k)。代入幾何尾概率,可立即得到有限容量的平均抽出張數。這個公式比直接對每個 k 的機率質量求加權總和更容易檢查,亦方便擴展到非固定機率情況。對 p∈[0,1) 而言,等比級數給出下式;p=1 時取連續極限 E[N]=m。
定義 W=N−1 為額外抽出的張數,E[W]=E[N]−1。此處把所有額外抽出的紙巾都稱為「浪費」仍只是成本模型的簡稱:現實中多出的紙巾可能可以放回、交給另一人使用或已被污染而不得重用。純機率變數只描述張數,不會自行決定物品是否真的被丟棄。若每張額外紙巾損失 c,則期望線性損失是 c(E[N]−1);若大型連鎖有額外整理時間,就要另加非線性或閾值懲罰。
6.2 二階矩、方差及極端連鎖風險
從整數恆等式 n²=1+3+5+…+(2n−1) 得到 E[N²]=∑{k=1}^{m}(2k−1)P(N≥k)。代入固定 p 即為 ∑{j=0}^{m−1}(2j+1)p^j,方差等於 E[N²]−E[N]²。這個推導無須引用未截斷幾何分布的方差公式,因此能正確處理剩餘庫存不足的情況。若 p 很接近 1,N 幾乎總是 m,於是方差應該縮小到零;直接使用無限幾何的 p/(1-p)² 則會錯誤地發散,反映出忽略容量約束的問題。
若研究者特別關心至少五張,則 p≥0 的固定模型給出 P(N≥5)=p⁴,只要 m≥5。整包被牽盡的概率是 p^{m−1};即使 p 不高,連抽尾端也有明確的指數衰減。這些公式提供容易記憶的直覺:從第一張算起,每希望再多牽出一張,就必須再成功跨過一個界面。但是在共同異質性模型中,每次成功傳遞會使條件抽取事件傾向落在較高 p 的包裝,因此同樣的單張邊際率可能不再決定尾部衰減速度。
6.3 Beta 共同傾向與包裝層級相關性
用 P~Beta(α,β) 表示一次抽取事件所處包裝的隱藏傳遞傾向,令條件 Z_j|P=q~Bernoulli(q) 並互相獨立,α>0、β>0。Beta 平均值 μ=α/(α+β),變異數 μ(1−μ)/(α+β+1)。對任意不同界面 j≠l,無條件 E[Z_j Z_l]=E[P²],而 E[Z_j]E[Z_l]=μ²;所以 Cov(Z_j,Z_l)=Var(P)。由於每個 Z_j 無條件均是 Bernoulli(μ),其變異數為 μ(1−μ)。因此界面間的相關係數可以寫成 ρ=1/(α+β+1)。這裏的正相關只來自共享 P,並未加入紙張受力後的直接物理回饋。
在給定 μ=0.28、ρ=0.18 時,總濃度 α+β=4.5555555556,因而 α=1.2755555556、β=3.28。與固定模型相同,第一個界面成功的邊際概率仍是 E[P]=0.28。差異只在於多個界面成功事件的聯合機率:若要連過 j 個界面,條件於 P 的概率是 P^j,整體機率則是 E[P^j]。Beta 分布的原點矩可透過 Beta 函數 B(·,·) 計算,亦可表示成上升階乘。這給出一套沒有必要對每張紙巾逐一做高維積分的精確解析框架。
在混合模型中,尾機率 P(N≥k)=t_{k−1};k<m 的概率質量是 t_{k−1}−t_k,最末格 k=m 的質量是 t_{m−1}。這些公式自然同時兼顧包裝共同環境、條件獨立與容量截斷。由於 0≤P≤1,矩序列 t_j 必然非增,因此每個機率質量均非負;望遠鏡加總又證明所有概率質量總和為一。這些結構比只靠模擬圖形看起來合理更有說服力,也為程式檢查提供了明確不變量。
6.4 混合後的平均值及方差
將混合尾部 t_j 代入前述恆等式,得到 E[N]=∑{j=0}^{m−1}t_j,以及 E[N²]=∑{j=0}^{m−1}(2j+1)t_j。這不是「先計算固定 μ 的平均,再讓 μ 隨機」;真正的混合平均應是 E[(1−P^m)/(1−P)],其結果一般不等於 (1−μ^m)/(1−μ)。先平均再代入非線性函數,與先代入函數再平均的次序不同,正是異質性造成差異的數學根源。
由於 x^j 對 j≥2 且 x∈[0,1] 是凸函數,Jensen 不等式保證 E[P^j]≥(E[P])^j=μ^j。對 j=1 兩者相同;只要 P 非退化並且 j>1,通常便有嚴格大於。結果是混合模型對 N≥2 的機率沒有改變,但對 N≥3、N≥4 以至更大連鎖的尾機率,皆不低於固定平均模型。只要 m≥3,平均抽出張數亦因此不低於固定模型。這個結論不需要 Beta 分布的特殊形狀,對任何定義於零至一的隱藏機率混合都成立;Beta 的作用是讓我們能以簡短公式計算具體大小。
6.5 自我選擇的長連鎖與危險率
假設某次抽取已跨過 j 個界面而仍未斷開,研究者應如何更新對下一個界面斷開機率的判斷?在固定 p 模型下,任何歷史都不改變下一次斷開概率 1−p,這就是幾何分布無記憶性的具體含義。Beta 混合模型則不同:觀察到連續 j 次成功,會把原先 Beta(α,β) 的隱藏 P 後驗更新為 Beta(α+j,β),因此下一次成功的預測概率上升為 (α+j)/(α+β+j),下一次斷開的條件概率相應下降。
這個遞減危險率表面上像是「抽得越長越容易繼續抽」,但模型完全沒有假設已發生的抽取令接觸界面受力變強;現象純粹由高黏附包裝在存活樣本中逐漸佔優而產生。因此我們不能從一條長連鎖推斷紙張在拉動途中一定形成了新液橋,也不能只根據連抽次數就分辨共同環境異質性和真正的歷史依賴。若將來有逐張拉力測量,可比較危險率在控制當前界面參數後是否仍隨歷史變化,才較有機會識別物理回饋。
6.6 無限容量近似為何可能失效
若包裝容量 m 趨向無限,固定 p<1 時 E[N]=1/(1−p);對 Beta 混合,無限容量的平均值須對 1/(1−P) 取期望。在 β>1 時,積分結果為 (α+β−1)/(β−1);當 β≤1,無限容量平均值會發散,即使 E[P] 仍小於一。這不代表一包實物可以抽出無限張,而是說混合分布若容許足夠多接近 P=1 的共同環境,理論尾端會很重。有限 m 的模型總有 E[N]≤m,從而避免把這個數學奇異性誤當成產品會無限連抽。
容量越小,分布最末格就越易累積概率質量;容量越大,長連鎖尾端則更完整地顯示高 P 事件的影響。因而比較不同包裝尺寸時,若直接比較平均抽出張數,還須留意可能的右設限偏差。尤其「十二張全抽出」與「二十張全抽出」所要求連續成功的界面數不同,兩者不能只按未截斷模型的期望作評價。研究所使用的十二張是示範設定;真實紙巾包裝有不同容量、抽取孔與折疊結構,後續實驗要先確定使用的是開封後哪個剩餘容量,而非只記錄產品標示的原裝張數。
6.7 濕潤程度與界面力:一條明確標示為假設的反例
為展示為何「越濕必越黏」並非數學上必然,令無量綱濕潤程度 w∈[0,1],假設有效黏附指標由基線 0.13 加上一項隨濕潤建立液橋、又隨過度濕潤衰減的乘積構成:F(w)=0.13+1.55(1−e^{−6w})e^{−2w}。其中前面的增長因子可理解為形成有效橋接的比例,後面的衰減因子僅作為可能的潤滑或橋接幾何改變之示意。此函數不是從文獻曲線擬合,所有係數均由研究者主觀設定,不具牛頓單位。把傳遞力與閾值的差距送進 logistic 函數,得到 p(w)=1/[1+exp{−(F(w)−0.48)/0.15}],只作敏感度構造。
對乘積求導,極大值條件是 6e^{−6w}−2(1−e^{−6w})=0;故 w*=ln(1+6/2)/6≈0.231049。因為 logistic 函數嚴格單調,p(w) 亦在相同位置取得極大值。這只是一個反例:存在合理形式的可微濕潤機制,使中間濕潤程度比極乾或極濕更容易傳遞界面力。未來若要檢驗這個說法,必須量測含水率、接觸角、粗糙度、抽取速度與拉力,亦要評估不同界面與材料的變化。單憑圖五的漂亮曲線,不能宣稱找到任何濕紙巾產品的最佳濕度。
6.8 干預後的機率與最適分離強度
考慮額外分離強度 d∈[0,1],假定給定隱藏 P=p 時,分離裝置使傳遞勝算比 p/(1−p) 乘上 exp(−2.3d)。於是干預後的傳遞概率為 q(p,d)=p exp(−2.3d)/[1−p+p exp(−2.3d)]。這個假設相當於將 logit(p) 向左平移 2.3d,確保輸出始終落在 0 至 1 之內。它並非聲稱現實世界增加封口摩擦必然符合 logistic odds 公式,而是建立一個可微、可控制且對所有樣本有效的研究用反應函數。
以每次干預後的平均額外抽出張數與五張以上概率作結果,定義人工成本 J(d)=E[N_d−1]+0.55P(N_d≥5)+0.20d²。前兩項是不同形態的連抽代價,最後一項代表分離裝置的材料、力氣或操作複雜度;三者比例純由本文設定。期望值是對隱藏 P 的 Beta 分布取積分,不能僅把平均 μ 放進 q(p,d) 再當作最終答案。當 d=0 時,此成本退化為原始模型的平均額外張數加上事故懲罰;隨 d 增加,風險可能下降,但最後一項必然上升。因此最小值可能在內部,也可能落在 0 或 1 的邊界。
我們以 96 點 Gauss–Jacobi 權重對 Beta 分布取期望,並使用有界一維數值最小化,在 [0,1] 上尋找 J 的最小值。由於 q(p,d) 含有指數與分式,對 P 而言不再是有限次多項式,Gauss–Jacobi 在此是高精度數值求積而非絕對精確的封閉解。研究亦應比較更高節點數的結果以評估積分誤差;若數值最小化落在局部波谷,則需檢視完整網格成本曲線和兩個端點。本文保存網格及最小化結果,讓未來研究者可直接更換假設成本並觀察最優值如何轉移。
7. 數值結果與模型檢驗
7.1 固定平均概率並不足以決定長連鎖
所有結果首先以同一組人工參數為比較起點:m=12、μ=0.28、ρ=0.18。固定模型的期望抽出張數為 1.3888885664,而 Beta 共同環境模型是 1.5443138843;差異為 0.15542531797 張。若只看每包平均多抽出多少,差異似乎不算巨大;但比較五張及以上長連鎖,固定模型給出 0.00614656,混合模型則給出 0.0324279577,後者約為前者的 5.28 倍。這並非同一包真實紙巾突然變成五倍危險的實驗結果,而是同一邊際牽引機率在不同相關性假設下的解析比較。
兩個模型的 P(N≥2) 均為 0.28,說明為甚麼只收集「一次會否多帶出至少一張」的二元使用紀錄,可能完全看不出包裝異質性的影響。在混合模型中,P(N≥3)=E[P²] 比 μ² 大,隨後連續冪的差距又更明顯。假如品質管理只以「雙張率」作為合格指標,兩款具有相同平均傳遞率但不同包裝差異的系統可能拿到相同分數,卻在嚴重抽取事故的概率上不同。本文的數學命題強調,風險尾部並非平均值的普通附屬數字,而是另一種須獨立量度的品質面向。
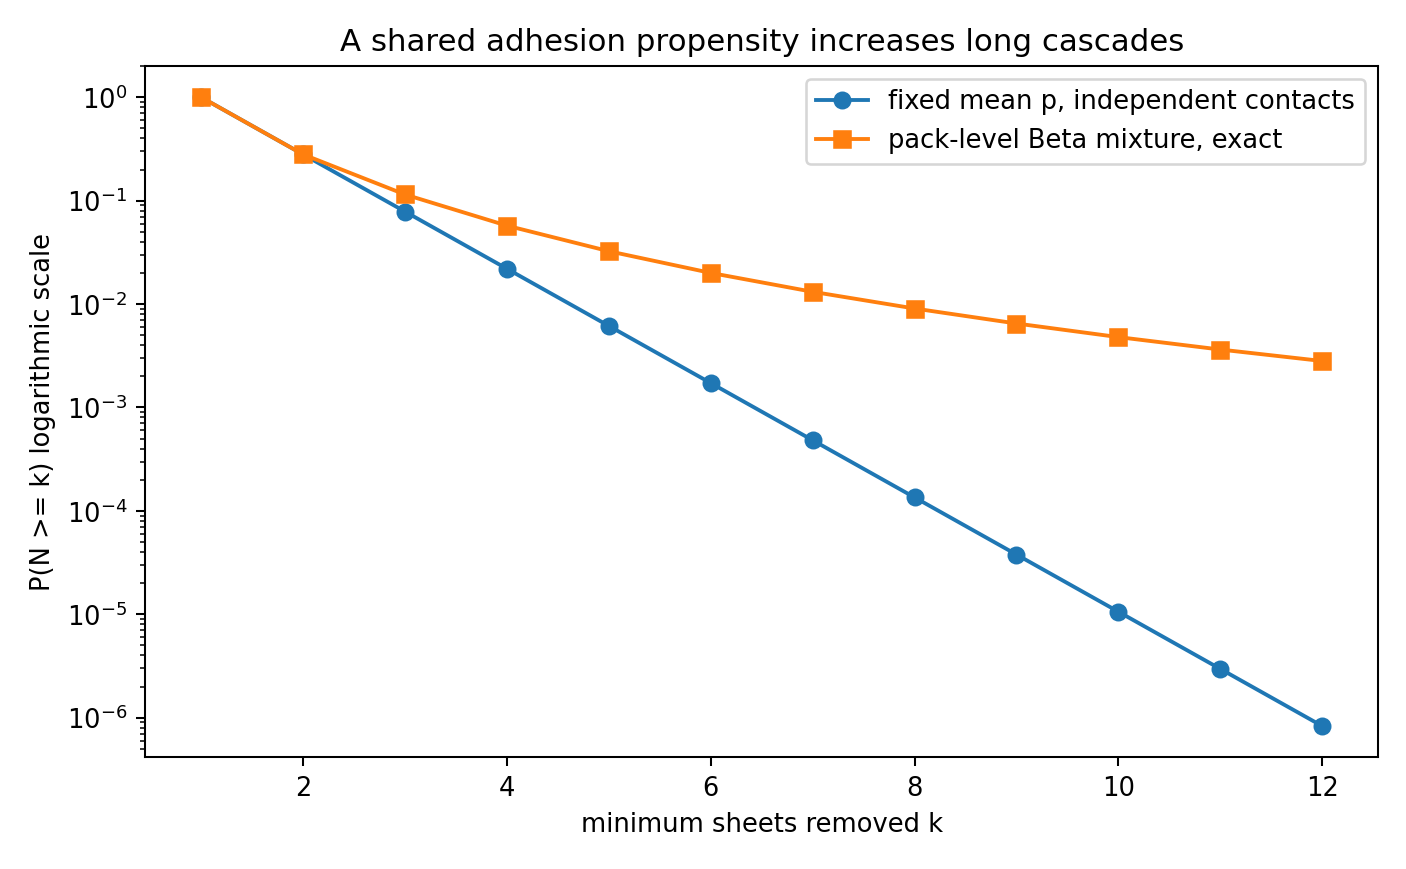
圖 1. 十二張容量下兩種人工模型的抽出張數存活函數;縱軸採對數尺度以呈現罕見長連鎖。所有點由解析式生成,並非實驗頻率。基準 μ=0.28、ρ=0.18。
在整包被帶出的極端事件中,差距更大:固定 p 模型的概率是 8.2935094675×10⁻⁷,Beta 混合模型約為 0.0028120845。該比較對先驗分布靠近 P=1 的形狀非常敏感,也受到包裝容量 m 的強烈影響,因此不宜把兩者的巨大比例看成可套用到其他產品的穩健估計。正確的解讀是,共同環境容許罕見高黏附事件支配尾端,而固定平均模型把所有抽取嘗試視為相同狀態,因而無法呈現相同形式的極端異質性。
從二階矩觀察,同一人工設定下固定模型的方差約 0.540116,而混合模型約 1.590064,顯示總抽出張數的分散程度也有明顯增加。平均數的增加和變異數的增加並不由相同簡單公式決定:均值可以由各尾機率加總,但方差還涉及二階矩和均值平方之差。若用固定模型反推真實量測所得的連抽平均,有機會把異質性造成的尾部效應錯誤歸因於平均牽引概率太高。研究設計因此應同時保留每次實際抽出張數,並對包裝之間的差異分層,而非只計算整體「合格/不合格」比例。
7.2 解析概率質量與模擬互相比對
為獨立檢查機率推導是否能由條件 Bernoulli 過程重現,我們生成 180,000 次合成單次抽取。每次先抽一個 Beta 共同概率,再按照前一界面是否成功決定會否嘗試下一界面。分析所得模擬平均值為 1.5446444444 張,與解析平均值 1.5443138843 張相差約 0.0003305601;模擬平均值的標準誤約 0.0029893 張,故差異只是標準誤的一小部分。每一張數類別的模擬機率與理論機率,最大絕對差約 0.000916211。這項一致性是模型程序的內部驗證,並不是對現實濕紙巾黏附機率的估計精度。
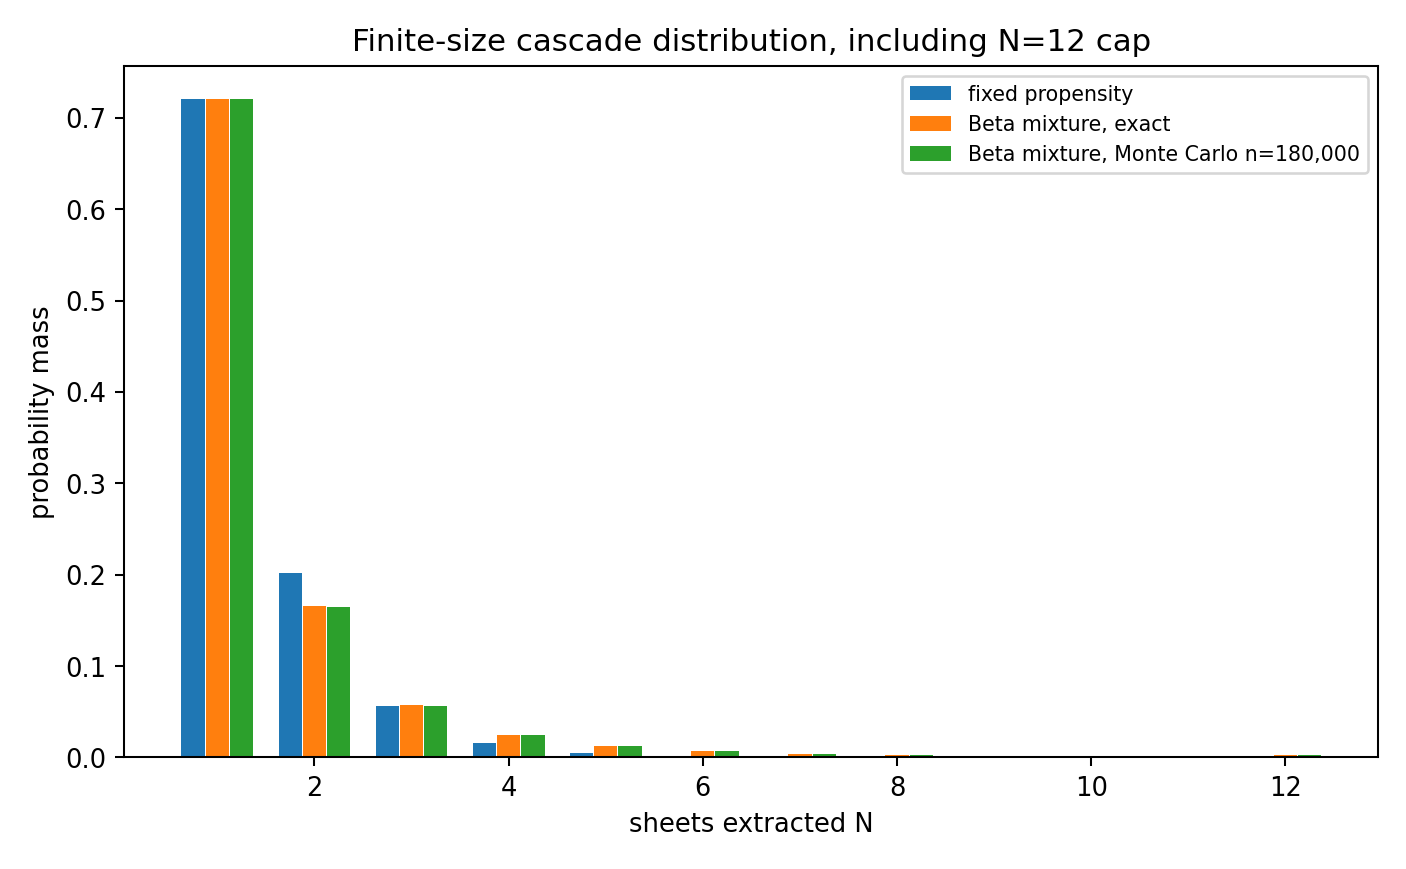
圖 2. 固定機率、Beta 混合解析式及 180,000 次合成模擬的十二張截斷概率質量。最後一格累積了容量截斷事件;模擬隨機種子為 2026101617。
圖二的最後一格尤其值得檢查:N=12 表示前十一個界面全部傳遞成功,並沒有實際觀察到第十二次傳遞後才停止。若程式誤把最後一格寫成 (1−P)P¹¹,其質量總和會小於一,且極端連抽的機率被錯誤低估。Python 的解析分布在固定及混合兩種情況下均通過質量歸一與非負檢查;蒙地卡羅程序也沒有在成功抽走最後一張後繼續增加張數。這種看似簡單的邊界條件,正是日常應用模型中最容易因故事直覺而被忽略的數學細節。
7.3 包裝共同變異的敏感度
圖三保持 μ=0.28 不變,只更改由 ρ 表示的共同環境變異。當 ρ=0 時模型回到固定 p;隨著 ρ 增加,Beta 分布的總濃度下降,更多概率質量分散到極低或極高牽引傾向。高牽引狀態雖然不一定常見,卻對需要連續成功很多次的尾端事件具有較大影響。由 Jensen 不等式可知,至少三張的尾機率相對固定模型不會下降;對有限容量的平均值,這些非負差異逐項加總,便形成系統性增加。圖中展示的是同一模型參數路徑,而非從多個真實品牌樣本計算的經驗回歸關係。
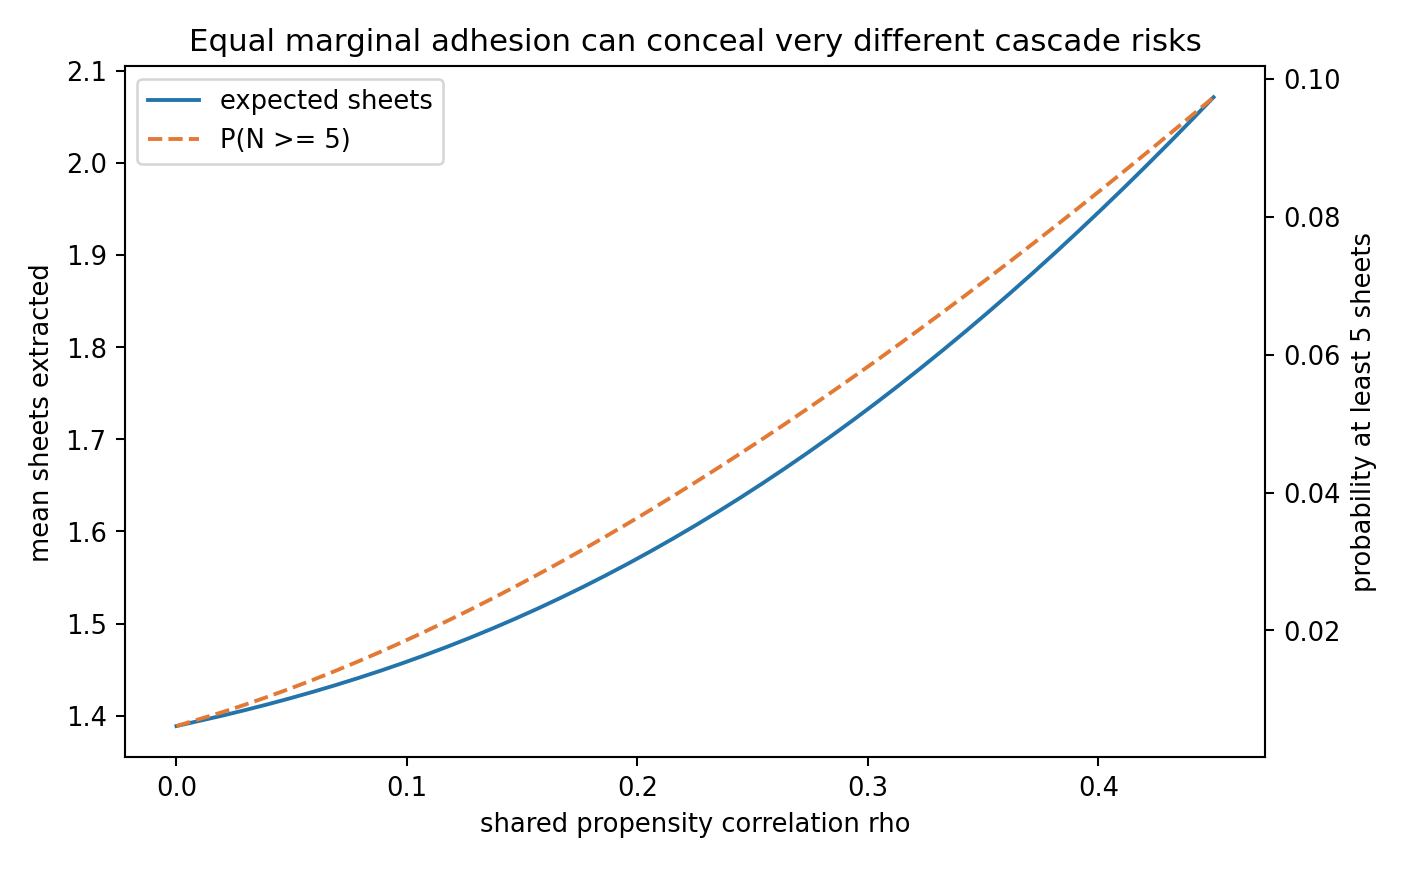
圖 3. 共同傾向相關係數 ρ 對理論平均張數與五張以上尾部事件的影響。兩條線用不同縱軸,讀圖時應留意兩個量的尺度;數據全為解析式。
共同變異可能來自原料批次、包裝壓縮程度、含液均勻度或開封後的儲存條件,但這些都是未經檢驗的可能來源,而非本文發現的因果機制。即使量測出正相關,也不能自動判斷其中有多少來自共同濕度、多少來自接觸幾何或前後紙巾相互牽動。在模型的嚴格意義下,ρ 只是隱藏概率變異的再參數化;要做物理歸因,仍需要對每個界面的力學狀態與抽取前史進行獨立測量。圖三提供的是「值得量測包裝差異」的理論理由,而不是包裝差異已經被本研究實測的證據。
7.4 分離強度最佳化結果
在成本 J(d)=E[N_d−1]+0.55P(N_d≥5)+0.20d² 下,三個共同變異程度給出不同的數值最小值。ρ=0.08 時最適 d 約 0.617828,目標值 0.183359,未干預的目標值為 0.450495;ρ=0.18 時最適 d 約 0.680866,目標值 0.210343,未干預目標值 0.562149;ρ=0.35 時最適 d 約 0.858394,目標值 0.313135,未干預目標值 0.871903。這些結果顯示,在本文指定的成本和反應函數中,包裝異質性較高的情境傾向需要較強的分離干預;但當成本權重改變,最適排序不一定保留。
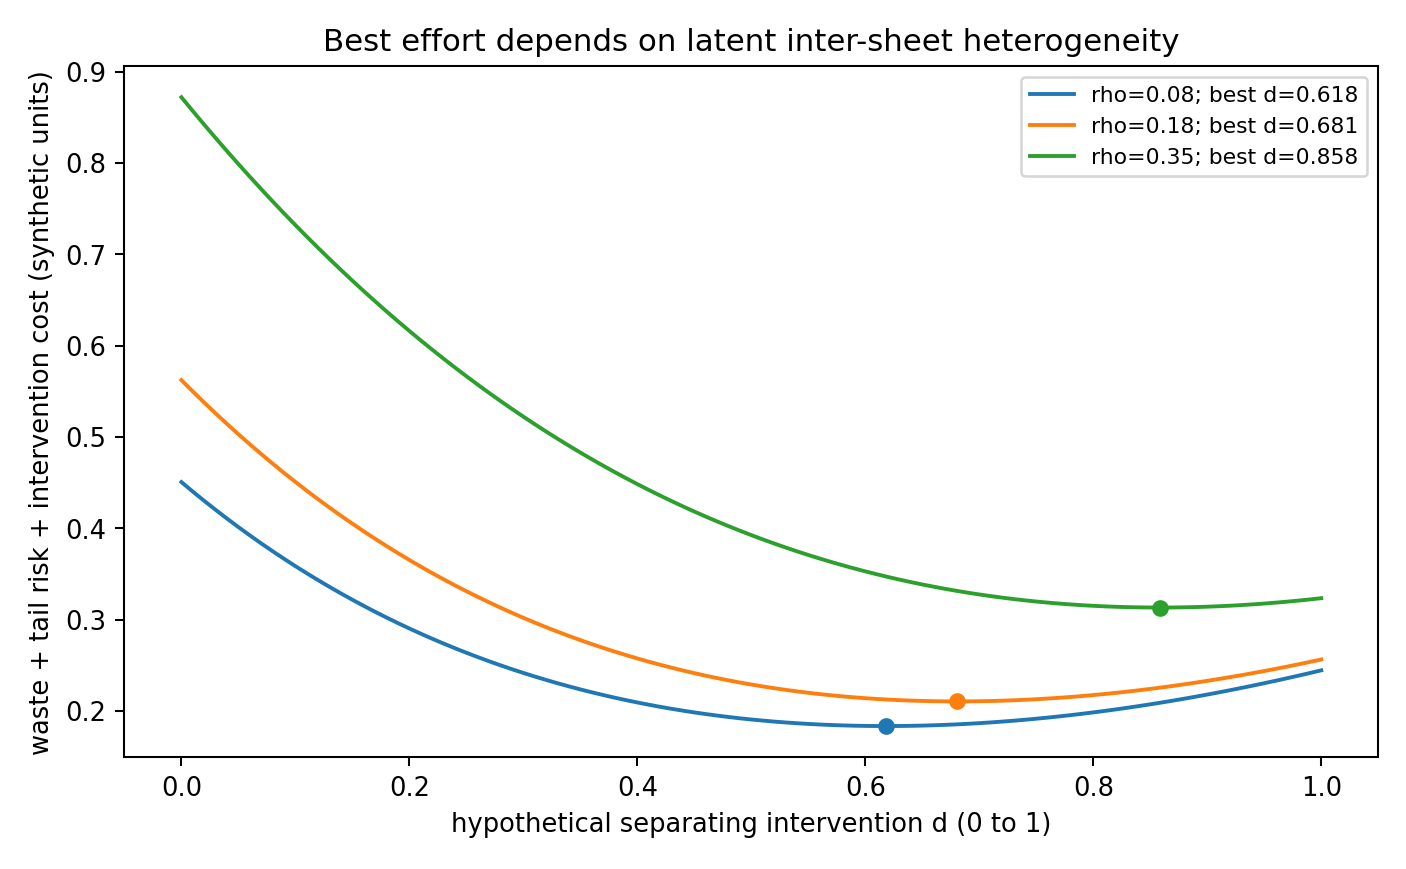
圖 4. 三種人工共同變異程度下,合成成本隨無量綱干預強度的變化。圖中標出每種情境的有界數值最小值;成本包含線性額外張數、五張以上風險及二次分離努力項。
最佳化圖不能直接回答「消費者應該用多大力拉」;d 不是牛頓值,也不對應任何指定機構的幾何開孔尺寸。若分離努力成本提高,最適 d 會下降;若大型連抽的損失權重提高,最佳設計可能偏向更大強度;若實際分離裝置容易撕破紙張,還要加入撕裂風險才可合理比較。圖四的用途是顯示一項真正的決策程序:明確列出控制變數、給定有效反應、量化多項損失、再以可重現的最佳化找出最小值,而不是先以直覺宣稱「出口越窄一定越好」。
7.5 非單調濕潤函數的反例及識別問題
圖五由 F(w)=0.13+1.55(1−e^{−6w})e^{−2w} 生成,其中液橋建立和衰減的乘積使曲線在 w≈0.231049 取得最大值。對數勝算轉換不改變最大值的位置,因而假設的牽引概率亦先增後減。這個反例的重點,是表明「增加某一類黏附作用」並不足以推斷「整體抽取風險必隨含水程度單調增加」。當摩擦、潤滑、表面接觸、形變和界面斷裂同時存在,具競爭性的機制可能產生不同形狀的合成函數。
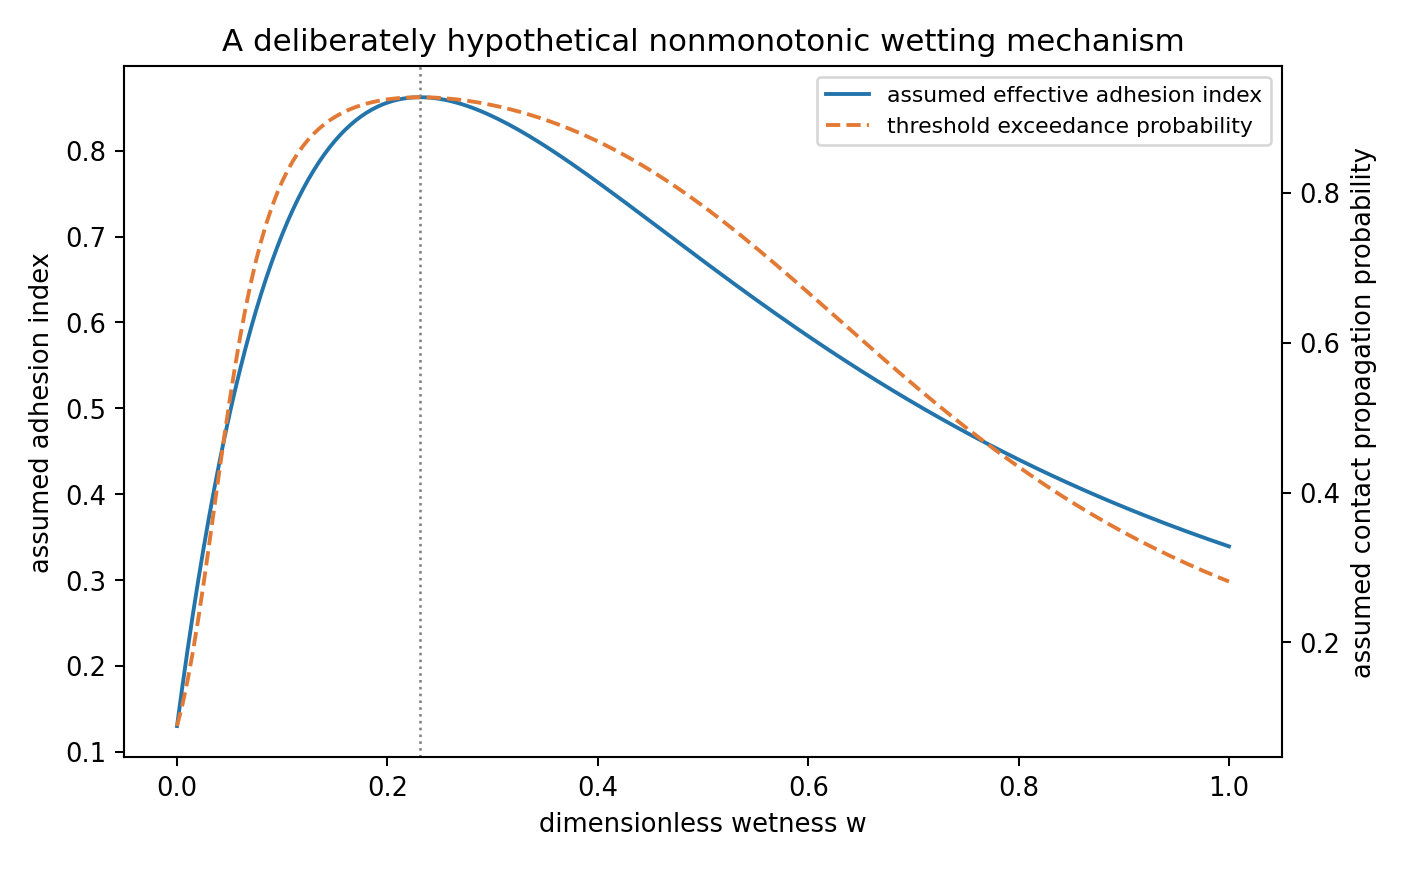
圖 5. 純假設的濕潤—有效黏附—傳遞概率函數。最大值位置由函數推導得出,不代表任何實測紙巾含水量的最佳值或失效臨界點。
如果未來有實驗測量,不能單看 p 隨 w 的橫截面形狀來判斷機制,因為濕度同時影響紙張的抗拉強度、吸液膨脹、接觸幾何及包裝內壓。實際測試應將封口尺寸、抽取速度、作用方向和紙巾材料保持盡可能一致,再單獨調整含水程度;亦要計算同一包的多次抽取之間是否存在時序關聯。把沒有控制的濕度差異全部歸因於液橋,只會使模型從抽象故事變成錯誤因果故事。現階段圖五應被視為可供檢驗的函數家族,並非新發現的材料定律。
8. 討論:日常怪事對可靠度工程的啟示
8.1 為甚麼「平均表現一樣」仍可能差得很遠?
一個出乎直覺的結果是:固定模型和共同環境模型在「有沒有把第二張也帶出」的概率完全相同,卻對長連鎖風險給出顯著不同的答案。這不是統計矛盾,而是測量指標的信息不足。P(N≥2) 只涉及第一個界面的邊際概率 E[P],P(N≥5) 卻需要四個界面連續成功,其期望為 E[P⁴]。後者受到概率分布高端形狀的強烈影響,不能由平均值還原。用戶只問「這包會不會黏」,廠商只報「平均連出幾張」,兩者都可能錯過極端但討厭的連抽事件;若要設計風險導向指標,必須收集完整的抽取張數分布和包裝層級差異。
Beta 混合中的共同狀態也提示,單次長連鎖不能被草率解釋為「每次都越拉越黏」。模型中的每個界面在給定 P 後仍是相同概率的獨立試次;觀察者更新的是自己對隱藏狀態的判斷,而非紙張的物理結構。這和序貫可靠度測試的概念相似:連續觀察到同類結果,可能只是辨識出某一批產品處於高風險狀態。實驗上若想識別這個效應,可以把不同包裝分成多個獨立群組,在每包內重複抽取、記錄位置和時間,並用階層模型估計包裝差異;還要處理每次抽取都會改變剩餘容量的偏差。
8.2 相關性、稀有事件與品質規格
傳統品質規格有時偏好單一容易溝通的平均指標,但罕見事件的成本可能並非線性。使用者偶爾多拿一張,可以順手使用;一次拉出十二張則可能令紙巾受污染、失去濕度或需要重新整理包裝。即使本文沒有消費者成本數據,這種非線性成本的可能性仍足以支持在模型中同時報告平均數與尾部風險。倘若某設計使平均連出張數減少,卻增加嚴重事故概率,單一平均損失指標可能給出相反的優先排序。研究者須預先定義究竟要優化資源浪費、事故概率、使用時間、紙巾完整度,抑或多項指標的權衡。
從工程可靠度角度,額外紙巾的出現是一種序列傳播事件,而非一個平面的同時故障集合。只要第一個界面已斷開,後續界面再黏也不會在同一次抽取中被啟動;因此傳播路徑具有方向與先後順序。這正是截斷幾何模型適合做初始近似的原因。若把所有紙巾兩兩之間都設置可以傳播的邊,就會得到網絡或分枝模型,卻同時假設了非相鄰紙張有機會在同次抽取中互相牽引;沒有實際折疊結構的資料,這種額外複雜度未必合理。對一條實際的 interfolded 折疊路徑,模型拓撲應由材料疊放和抽取次序而定,而不是為了引入更高級的圖論而任意添加分枝。
8.3 同一現象的兩類相關性
包裝內共同異質性與抽取過程中的時序相關性需要分辨。本文的模型先固定一次抽取的 P,令各界面條件獨立;它沒有描述某一次傳播使後面的界面黏附力真的增強、減弱或隨速度改變。若材料存在被拉伸後重新接觸的效應,便可能需要一個隨界面位置而改變的狀態 P_j,以及 Markov 或受力歷史方程。屆時簡單的 Beta-geometric 尾部不一定成立,但可用作一個清楚界定的基準。把原模型和複雜模型一同提供,能檢查是否真的需要額外狀態變數;若現有數據尚不足以辨識這些變數,使用更複雜模型反而可能降低可理解性。
另一些影響可以在包裝間發生。開封後第一天、第二天或不同存放方向,整包的平均黏附傾向可能改變;即使每次抽取只存在小幅度相關,長期使用資料亦未必能當作獨立同分布樣本。要估計真實不確定性,應在統計分析中保留包裝的群組標籤,而非把同一包抽取二十次視為二十個完全獨立的產品樣本。本文的 180,000 次模擬將每次事件獨立抽取 P,因此其標準誤只反映人工資料生成的程序,而沒有包含真實產品批次效應、量測誤差和結構模型誤差。即使模擬次數增加到一億,也無法消除這些非抽樣的不確定性。
8.4 產品設計必須考慮替代失效形式
如果分離裝置強到幾乎不可能牽出第二張,乍看已經完美解決問題;但若第一張更容易撕裂、出口難以抓取、包裝密封失效或剩餘紙巾乾燥,總體品質未必改善。最適化不應只把「抽出多張」當作唯一目標;需考慮正確取得一張完整可用紙巾的成功率、每次操作所需時間、材料使用量及回收性。本文的合成損失函數刻意只涵蓋三項可計算成本,並在圖四展示最優值對共同變異的變化。真正的工程決策還須將破裂、拉扯力度、密封性能、制造成本和使用者可及性納入同一分析框架。
物理文獻對接觸角、表面粗糙度、毛細力及濕紙強度已有研究,卻無法取代針對指定產品機構的因果試驗。一個可行的實驗設計是將同種材料、同一尺寸的片材置於可控濕度的測試盒,隨機化封口阻力、抽取角度及速度,並利用測力計同步量度每張紙巾被牽出的瞬間力。如此可先估計單界面閾值分布,再檢查 Beta 混合假設的尾部預測;如有足夠資料,便比較是否需要更複雜的序列狀態模型。沒有這類資料,本文最多只能提出可操作的測試框架,不能宣稱已提出經實證優化的封口尺寸。
9. 研究限制與外部效度
第一項限制是全部參數均為假設數字。μ=0.28、ρ=0.18、m=12、各項成本係數及分離效率都不是由商品規格、物理測試或消費者調查推得。它們選自能夠清楚展示機率差異的示範情境;即使計算結果精確到小數後十位,也不代表現實事件概率具有相同精度。研究沒有設置人類受試者、材料拉力測試、影像分析或隨機化產品比較,故任何以「本研究發現某品牌紙巾有百分之幾機會連抽」為形式的說法都不成立。
第二項限制是界面事件過度簡化。紙巾具有彈性、纖維方向、折疊複雜度與不均勻濕度,抽取時的速度和方向也會影響接觸受力;將每個界面映成二元事件會遺失漸進滑移、局部剝離、撕裂和封口滯後等現象。本文沒有描述液橋形成的時間尺度,也沒有導入流體動力學方程。如果兩張紙巾之間不只一個有效接觸界面,或者抽出第三張需要繞過不同折疊路徑,單一路徑的 N 分布便可能不適用。這不推翻解析公式在既定假設下的正確性,但限制它對實物的預測能力。
第三項限制是對相關性的具體來源缺乏識別。Beta 隱藏傾向可以數學上造成正相關及遞減的觀察斷鏈危險率,但同樣形狀的資料也可能由真實的受力歷史、不同紙張材料、批次差異甚至抽取操作方式造成。若只有每次抽出張數的分布,便很難將這些潛在機制完全拆開;文中的 ρ 不能在沒有額外資訊時直接解釋成「濕度相關係數」。更重要的是,Beta 混合不是對所有概率分布異質性的普遍真相,而是一個方便解析、可被未來研究拒絕的候選模型。
第四項限制是文獻外推邊界。本文核對了十項 DOI 的出版元資料及可取得的來源頁面,部分來源有摘要與公開全文,但並沒有對全部付費全文、原始實驗資料及每個作者研究步驟完成獨立複核。濕紙、纖維黏附、柔性表面液橋和粗糙固體摩擦之間存在材料差異;本研究只把它們視為機制背景,並無引用其中任何未查證的濕紙巾連抽機率、抽取速度或包裝成本。引述真實材料文獻,不等於合成參數取得實證背書。
第五項限制是對成本函數的偏好設定。對抽出五張以上附加 0.55 的損失權重,只是展示風險敏感度的算術裝置;不同使用者對浪費、整理時間、環境成本或紙巾完整度可能有不同權重。最佳分離強度必然受這些主觀權重影響,亦可能隨設計成本形狀改變。當使用者的真正目標尚未明確時,「最佳」一詞只指給定 J(d) 的數學最小值,而不是所有使用者都認可的最佳產品設計。
10. 未來研究:把漂亮的尾部分布變成可以否證的實驗
下一階段應建立標準化的抽取測試台,保存完整的紙巾材料、批次、含液狀態、折疊方式及包裝開口尺寸。以可重複的線性或旋轉驅動控制拉取速度和方向,透過測力與影像同步判定每次界面傳播、紙張破裂及完整抽出的時間。應將每一次抽取的剩餘張數記錄下來,避免容量截斷被錯誤地當成自然斷鏈;同時保存每包多次抽取的順序,以檢查是否存在乾燥、壓縮或反覆開合造成的歷史依賴。只有這樣才能將本文的虛構 μ 與 ρ 替換成真實估計,亦才有資格比較不同設計的外部效度。
統計方面,宜先預註冊主要指標,例如平均額外張數、P(N≥3)、P(N≥5) 和紙張撕裂率,再分層隨機抽取多個實物包裝。若資料足夠,可比較固定 p、Beta 混合、位置特定 p_j、Markov 狀態模型及根據濕度和速度建立的層級回歸模型。模型預測宜在獨立測試批次上檢查,避免在同一批抽取資料上既估計參數又誇大預測成功。對罕見長連鎖,樣本量設計尤為重要:若事件概率很低,少量測試即使沒有觀察到一次長連鎖,也不能證明它不存在。
機械方面可探討界面力如何隨濕潤、折疊互鎖、開口阻力和使用者施力方向改變,並以實驗測得的閾值分布反推傳遞機率。優化方面則須聯合考慮材料成本、使用力度、完整紙巾取得率及封口保存水分的效能;可採用 Pareto 前緣或多目標限制式,而非任意把所有項目壓縮成一個沒有來源的主觀權重。本文的圖五特別適合用來設計否證試驗:若實驗數據始終支持單調濕潤效應,就應直接放棄示例中的非單調形狀,而不是為了保留故事趣味硬把資料套入模型。
另外值得研究的是消費者如何判斷連抽事件的嚴重程度。若一次連出七張的記憶遠比多次連出兩張鮮明,主觀抱怨頻率未必與客觀事件頻率一致。這可以透過真實但獨立取得的行為資料測量;但需要清楚的同意程序、資料匿名及避免因研究者假設而引導受試者回答。此方向屬於心理學與人機互動的後續課題,不能在本文未招募任何人的情況下預先聲稱已有認知偏誤的實證結果。
11. 結論:紙巾隊伍背後的有限概率問題
本文把「抽一張濕紙巾卻帶出多張」拆成可定義的相鄰界面傳遞事件,以有限容量截斷幾何分布描述單一路徑連鎖,再用 Beta 混合模型刻畫包裝共同黏附傾向。主要數學結論是:當各界面的邊際牽引概率保持不變時,共同環境異質性仍可藉由冪函數凸性提高三張及以上的連鎖尾部概率;抽出第二張的機率則可能完全沒有改變。這解釋了為甚麼一個看似合理的「平均牽引率」指標,未必能概括令使用者最頭痛的極端連抽情境。
在十二張容量、平均傳遞率 0.28 及共同相關係數 0.18 的純人工設定下,解析期望張數由 1.388889 增至 1.544314,五張以上概率由 0.006147 增至 0.032428;180,000 次合成模擬與解析結果一致。其他兩項研究結論同樣必須維持條件性:非單調濕潤曲線只是一個可反駁的假設反例;最佳分離強度只是在指定成本函數及 logistic 控制效率下的數值解。本文沒有任何實測資料足以證明真實紙巾具有相同曲線、概率或最佳設計。
因此,嚴謹地研究荒誕日常事,最重要的不是為日常抱怨找一條華麗公式,而是把日常直覺分成可以驗證的變數、限制及因果假設。紙巾抽得越長是否因為越黏?或只因為高黏附包裝在連鎖中更容易存活?這個區別要求真正的資料才能回答。本文提供明確、可重現、可供日後測試否證的數學起點,並把所有未知之處留在應有的位置:未測量的物理機制,仍然是未測量的物理機制。
12. 參考文獻(Crossref 出版元資料核對,APA 7 風格)
Belle, J., & Odermatt, J. (2016). Initial wet web strength of paper. Cellulose, 23, 2249–2272. https://doi.org/10.1007/s10570-016-0961-7
Borri, C., Paggi, M., Reinoso, J., & Borodich, F. M. (2016). Adhesive behaviour of bonded paper layers: Mechanical testing and statistical modelling. Proceedings of the Institution of Mechanical Engineers, Part C: Journal of Mechanical Engineering Science, 230, 1440–1448. https://doi.org/10.1177/0954406215612502
Butt, H.-J., & Kappl, M. (2009). Normal capillary forces. Advances in Colloid and Interface Science, 146, 48–60. https://doi.org/10.1016/j.cis.2008.10.002
Colbeck, S. C. (1997). Capillary bonding of wet surfaces – the effects of contact angle and surface roughness. Journal of Adhesion Science and Technology, 11, 359–371. https://doi.org/10.1163/156856197X00750
Daniels, H. E. (1961). Mixtures of geometric distributions. Journal of the Royal Statistical Society: Series B (Methodological), 23(2), 409–413. https://doi.org/10.1111/j.2517-6161.1961.tb00423.x
Ha, J., & Kim, H.-Y. (2020). Capillarity in soft porous solids. Annual Review of Fluid Mechanics, 52, 263–284. https://doi.org/10.1146/annurev-fluid-010518-040419
Peng, L., Hsia, F.-C., Woutersen, S., Bonn, M., Weber, B., & Bonn, D. (2022). Nonmonotonic friction due to water capillary adhesion and hydrogen bonding at multiasperity interfaces. Physical Review Letters, 129, 256101. https://doi.org/10.1103/PhysRevLett.129.256101
Persson, B. N. J., Ganser, C., Schmied, F., Teichert, C., Schennach, R., Gilli, E., & Hirn, U. (2013). Adhesion of cellulose fibers in paper. Journal of Physics: Condensed Matter, 25(4), 045002. https://doi.org/10.1088/0953-8984/25/4/045002
van de Ven, T. G. M. (2008). Capillary forces in wet paper. Industrial & Engineering Chemistry Research, 47(19), 7250–7256. https://doi.org/10.1021/ie800423r
Wexler, J. S., Heard, T. M., & Stone, H. A. (2014). Capillary bridges between soft substrates. Physical Review Letters, 112, 066102. https://doi.org/10.1103/PhysRevLett.112.066102
13. 附錄:重現參數、運算核對與可延伸問題
A. 環境與再現命令。 使用 Python 3、NumPy、SciPy 與 Matplotlib。由研究所根目錄執行 python3 Cycle_003/Paper_017/analysis.py,程式會在 figures/ 儲存五張圖,在 data/ 儲存機率質量、尾機率、共同相關敏感度、干預成本及濕潤示例曲線,以及 summary.json。在模型內部,合成事件數固定為 180,000,NumPy 種子為 2026101617,容量 m=12,平均 p=0.28,相關 ρ=0.18。
B. 資料狀態。 本研究沒有來自實物包裝的連抽記錄、使用者調查、現場照片或物理試驗。所有分布、圖、模擬結果都屬假設參數的數學推論,不能作為產品品質的經驗證據。Crossref 書目核對結果以 data/verified_reference_metadata.json 儲存,其用途和檢索限制另記於 Reference_Check.md。
C. 數學與模擬的交叉檢查。 以尾部累積公式計算的理論平均及方差,需與直接生成連鎖的 Monte Carlo 結果相符;固定 p 模型及 Beta 混合模型在 N≥2 的邊際概率必須一致;輸出的離散機率分布總和為一;干預 d=0 時應回復沒有分離裝置的基準成本;所有顯示的「最優」都只針對有限區間 [0,1] 及本文指定權重。
D. 後續實證設計備忘。 建議最少紀錄每次抽取的包裝 ID、批次、剩餘張數、含水量、抽取角度與速度、作用力、是否撕裂及實際抽出數量。若資料無法支持估計共同環境變異,應如實呈報識別不足,而非強行擬合 Beta 分布或虛構精確的 ρ 值。