摘要
多人在聚會中共同點歌,看似最民主的做法是按投票數讓熱門歌優先播放;但若新點歌持續抵達,熱門歌的插隊可能使冷門歌等待很長時間。本研究將每首歌視作單一伺服器的工作,假設熱門與冷門請求分別按率 0.68 與 0.24 每歌曲時槽的 Poisson 過程抵達,單首播放時間固定一時槽,總負載為 0.92。以 M/D/1 排隊模型推導先到先播(FIFO)的平均排隊等待 5.75 時槽,以及非搶佔式熱門優先下熱門與冷門的解析平均 1.4375 與 17.96875 時槽;這些是模型穩態理論值。接着採用固定隨機種子 2026102501 生成 185,000 個合成點歌請求,在相同到達序列上比較 FIFO、熱門優先、九比一權重抽籤、十二時槽老化保護與兩熱門一冷門公平配額。排除暖機與終端樣本後,熱門優先的合成冷門平均等待約 18.88 時槽,公平配額約 4.49 時槽,兩者均不代表真實聽眾所經歷的時間。本文以等待時間、二十時槽內開始播放的概率及兩類滿意概率的 Jain 指數分析「公平」的不同定義,並區分有限時間窗未被播放、負載接近一時等待增長和數學上的永久飢餓。結論是:表決權重反映偏好強度,卻不自動保證每位請求者可在合理期限內獲服務;在模型假設成立時,保護性配額與等候老化可以減少冷門歌曲的等待尾部,但服務品質仍涉及未建模的音樂偏好及曲目長度。
Abstract
A vote-ranked shared playlist appears democratic, yet continuously arriving popular requests can delay rare selections. We study a hypothetical nonpreemptive M/D/1 song server with independent Poisson arrivals of 0.68 popular and 0.24 rare requests per one-slot song. The exact FIFO mean queue delay is 5.75 slots. Strict popular-first priority gives exact popular and rare mean delays of 1.4375 and 17.96875 slots, respectively, under stationarity. A seeded synthetic experiment with 185,000 requests compares FIFO, strict priority, a 9:1 weighted lottery, twelve-slot aging, and a two-to-one service quota on identical arrival streams. In the specified finite analysis window, rare requests wait on average about 18.88 slots under strict priority, compared with about 4.49 slots under the quota. We report class-sensitive delay tails and probabilities of starting playback within twenty slots, with a Jain index calculated on those class-level probabilities. We explicitly distinguish finite-horizon nonservice from literal infinite waiting, and model results from observational claims. All numerical observations arise from synthetic requests; no real listeners were studied.
關鍵詞: 點歌系統;非搶佔式排程;M/D/1;嚴格優先權;等待尾部;有限期限公平;Jain 指數;合成數據;公平配額
1. 引言:被投票制度忘記的一首歌
在學生宿舍、朋友聚會或共同工作空間播放音樂時,大家往往希望每人都有提議歌曲的權利。然而,「任何人均可點歌」與「每個人的歌都有相近機會在今晚播到」是兩項不同承諾。假如播放清單永遠以讚好數排序,而受歡迎的曲目又不斷加入,某首只有一票的歌曲可能在清單上反覆下沉。介面仍顯示它已進入候播名單,提出者卻可能在離場前都沒有聽到。這個小型社交困局與電腦系統的資源分配問題高度相似:一個服務台有有限容量,具有不同優先權的工作源源不絕抵達,排程規則決定誰先得到服務。
同一首歌可以是不同人眼中的熱門曲目。本文不替音樂建立客觀的審美等級,也不假定少數派必定有較高的道德權利。為了讓問題可被演算,我們把新點歌請求分成兩類:熱門類代表在投票排序中較有競爭力的請求;冷門類代表較容易被後來者越過的請求。兩類都具有相同播放時長。這種抽象省略了歌手、歌單重複、主持人跳歌、情緒氣氛、投票作弊等複雜因素;其價值在於讓「規則本身會否製造系統性等待差距」成為可檢查的研究問題。
有兩種容易混淆的公平觀念。第一種是程序平等:所有人都能提出一首歌,平台沒有從入口拒絕誰。第二種是結果機會:提交之後能否在可接受時間內聽到該首歌。熱門優先政策可能在程序上完全開放,卻在結果上高度不均;反過來,固定輪流政策可能延長熱門選擇的等待,卻改善少數曲目的可預期服務時間。本研究將兩種準則分開,拒絕把「民主」當成無條件優越或必定不公平的標籤。
研究還面對一個重要語義陷阱。「等了很久」和「永遠不會播」不同。在總到達率小於播放能力的穩定排隊系統中,嚴格優先權可以造成很大且偏斜的等待,但典型條件下兩類仍會幾乎必然獲服務。只有當系統持續超載,或排程規則明確拒絕某類服務,才可能產生真正的永久飢餓。日常口語把今晚沒播到稱為「永遠不播」,研究則必須給出時間界限或無窮時間的嚴格定義。
本文先以排隊理論取得三個可驗算基準,再設計五項不同的服務規則,在完全相同的合成到達序列下觀察平均延誤和兩類分配。主要關心的是機制、可檢查性與適用邊界。只要讀者替換到達率、歌曲時間或配額,就能用附帶程式重新測試結論;但在沒有真實點歌紀錄前,不能宣稱任何實際平台存在本文計算出的冷門歌等待時間。
2. 文獻:排隊、公平分享與可量化的分配
排隊理論將「到達、排隊、服務、離開」描述為概率過程。Kleinrock(1975)的著作提供了服務台、負載、等待和穩態分析的系統背景;Harchol-Balter(2013)則說明如何把計算系統的效能與排程問題聯繫起來。兩者並不研究本篇假設的音樂活動,本文亦沒有將教科書的一般結論錯認為「聚會點歌已被實測」。本研究採用固定一首歌一時槽的理想化服務時間,對應數學上單服務台 M/D/1,因為到達是記憶無關的 Poisson 過程,D 代表確定的服務時間。
在互聯網路由器中,資料封包也會在有限容量的服務設備前排隊。Demers、Keshav 與 Shenker(1989)探討公平排隊演算法,並以分析和模擬比較服務規則。Parekh 與 Gallager(1993)分析一般化處理器分享及其延遲保證;這些理論提醒我們,僅讓一類資料永遠插隊未必符合每個使用者的服務保障。然而,路由器的流量單位與歌曲並非一一對應:資料封包可能很短,可細分和搶佔;歌曲播放往往涉及完整段落、情緒連續性和主持人選曲,因此本文只採用「有限服務能力下的類別配額」作為概念類比。
Shreedhar 與 Varghese(1995)提出 deficit round robin 演算法,為不同流量分配服務機會提供實用思路。本文的「兩熱門、一冷門」只是簡化的兩類配額循環:當兩類均有人排隊時,按兩比一選擇下一次服務;某一類沒歌時立即服務另一類。這個做法並非完整的 deficit round robin,沒有可變封包大小、赤字計數器或網絡頻寬的逐位公平性;把它描述為「受公平排隊啟發的可理解基準」較為準確。
公平性還需要可計算的指標。Jain、Chiu 與 Hawe(1984)的技術報告提出通用公平指數,常用形式是各群體收益總和平方,除以群體數量和收益平方和。指數接近一代表被納入計算的群體收益大小接近,但它無法判斷所有人是否都得到足夠服務:兩類成功率同時低至百分之十,仍可能得到等於一的公平指數。因此本文把 Jain 指數放在二十時槽內獲服務概率旁,並同時呈報各類概率和平均等待,避免以單一漂亮數字掩蓋實際的不方便。
現有方法學文獻沒有直接告訴我們該不該優先播最多票歌曲;這屬於帶有社會偏好的設計問題。我們從理論中借用可重現的運算概念,而最終「公平」必須回到具體承諾:是否每次請求均有開始播放的時間保證?是否允許熱門群體按偏好佔較高比例?是否為準備離場的少數聽眾保留合理期限?只在明確說出這些目標後,才有可能對制度作出有意義的比較。
3. 研究問題、假設與判準
本研究第一項問題(RQ1)是,當整體點歌到達率仍低於單播放器容量時,熱門優先是否可能使冷門請求的平均等待遠超熱門請求?對應的 H1 是:在固定熱門到達率、服務時間及非搶佔條件下,嚴格熱門優先的兩類等待公式存在分母差異,冷門平均等待對總負載更敏感。這個假設可由 M/D/1 優先排程公式推導,並以另一份合成實驗獨立檢視。
第二項問題(RQ2)是,不同「民主」規則是否在同一批到達請求下產生不同的可及性?H2 認為,九比一加權抽籤和嚴格熱門優先在冷門請求等待上不一定相同,而老化保護與公平配額能改變兩類等待的分布和二十時槽內開始播放的比例。由於抽籤帶有額外隨機性,單次實驗只能呈現指定種子下的情境,不能以小幅均值差異直接宣稱政策具有普遍的統計優勢。
第三項問題(RQ3)是,「飢餓」應如何可檢查地定義?本文定義有限期限服務失敗事件為 W>h,其中 W 是提交後至開始播放的排隊等待,h 設為二十個歌曲時槽。另一個更強定義是 W=∞,即在無窮長時間也得不到服務。二者的概率及適用條件不同,不能以二十時槽的未播放率替代永續飢餓概率。在研究結果中,「今晚仍未播」應當翻譯為具時長的失敗事件。
第四項問題(RQ4)關乎價值判斷:單看整體平均等待,能否看出少數派受損?本文採用兩類平均、尾部分位數、服務成功率及類別公平指數組合判斷,而不單看所有請求合併後的平均。若熱門請求佔較大比例,一套令熱門請求很快、冷門請求極慢的規則,仍可能獲得看似尚可的合併平均。公平分析必須具類別敏感度,否則研究會把正要解釋的問題在平均化過程中消去。
所有假設均以指定的 M/D/1 單服務台、固定到達率、共同合成輸入及未經實測的類別劃分為條件。本文不進行顯著性 p 值檢定,因為數據完全由已知隨機生成規則創造,重點是推導和可重現的政策對照。若日後取得真正的曲目到達紀錄,估計誤差、選擇偏差和不同社交場合的差異都需重新處理。
4. 模型世界:兩類點歌只共用一個播放器
設連續時間變數 t 的單位為歌曲時槽,一時槽等於一首歌的假想固定播放時間。熱門類 H 與冷門類 L 的獨立請求流各為 Poisson 過程,強度分別記作 λ_H 與 λ_L。疊加後總到達率 λ=λ_H+λ_L。每首歌服務時間 S=1,播放器只可播放一首,且一旦開始播放就不會為更受歡迎的新歌而中斷。這是非搶佔式、單服務台、先進先出或優先排程的共同環境;所有策略都在同一組到達時間下比較,以減少輸入隨機波動對策略比較的干擾。
基準參數取 λ_H=0.68、λ_L=0.24,所以 λ=ρ=0.92。其社會含義並不是「每個人一分鐘提出零點幾首歌」,而是當一首歌長度被標準化為一時槽後,平均每時槽會收到 0.92 個新請求,其中約 73.91% 標作熱門,約 26.09% 標作冷門。平均到達率小於服務率一,理論上容許穩態;但 0.92 已相當接近容量上限,隨機短期擁塞仍可能大幅延長等待。選這組參數是研究設計上的壓力測試,沒有以任何平台統計報表作校準。
服務時間設定 S=1 令歌曲長度不成為干擾變項,讓排程類別而非曲長成為比較焦點。真實歌長差異顯著,若慢歌、串燒或現場版在某類請求中較常見,等待時間就同時受到服務變異影響。在 M/G/1 的一般條件下,服務時間二階矩 E[S²] 會進入平均等待公式;即使平均曲長相同,變異較大的歌單亦可能有不同的等待尾部。本研究使用 S=1 僅作為公平機制的基準,不把此假設宣稱為普遍的音樂播放習慣。
另外,模型把同一曲名由兩人各點一次當作兩個獨立工作。現實平台可能合併重複點歌、增加票數、限制一人多次點歌,或因有人離開而刪掉請求;每個設計都改變工作數與到達過程。本文保留全部已抵達請求,直至獲服務,不設插隊付費、主持跳歌、容量拒收或請求取消。這樣的假設刻意讓排程效果最清楚,亦意味著結果不能直接代表提供取消或合併功能的真實服務。
5. FIFO 基準:服務順序不分聲量
先到先播的規則非常直接:請求按照抵達時間排序,下一首必定是尚未播放而最早抵達的一首。由於類別標籤不參與決策,熱門與冷門在條件相同的到達時刻、服務需求下具有相同的穩態平均排隊等待。這不代表單次熱門歌與冷門歌等候相同;不同人可能剛好在隊伍堆積或清空時加入。其數學平等性是對類別標籤的交換不變性,而非對每一次個案的絕對平均分配。
由 Pollaczek–Khinchine 平均等待恆等式,在工作守恆、Poisson 到達且服務時間二階矩有限的 M/G/1 單服務台中,FIFO 穩態平均排隊等候為 λ E[S²]/[2(1−ρ)]。因本文 S=1,得出 λ/[2(1−λ)]。這裡的等待 W 只計排隊至開始播放之前的時間,不包括歌曲本身的一時槽服務時間。這個區分很重要:若把歌曲播畢時間當作等待,就會每首多加一時槽,令模擬與理論出現一個恆定偏差。
這個公式的關鍵是分母。當負載接近一,服務容量和輸入強度之間的「安全緩衝」只剩極小差額,平均等待便會快速增長。若 λ 由 0.92 降至 0.70,同一理論式的等待會變成 0.7/(2×0.3) 約 1.1667 時槽。這說明聽眾抱怨排隊長,不一定來自演算法歧視;也可能單純因為所有人同時點太多歌。因此研究任何公平規則以前,必須先檢查總到達負載是否有足夠容量支撐。
FIFO 的公平代價是,它不理會歌曲的受歡迎程度。若一首票數極高的新歌在一堆舊請求之後抵達,亦只能排到最後。對重視即時氣氛的派對而言,這可能被視為浪費現場偏好訊號。可是,正正因為 FIFO 不會容許後來者單憑聲量越過前面的人,它天然保護早已提交的少數請求。這不是所有場景的最佳社會政策,只是具有明確可證明特性的理論基準。
6. 熱門優先:兩條看似相同的隊伍變得不相同
嚴格熱門優先政策在每次上一首歌播完時檢查候播名單:只要存在熱門請求,下首一定從熱門類中挑最早到達者;當熱門隊伍清空後才會挑冷門類。播放途中不會中斷,故即使某個熱門請求剛剛抵達,也不能強迫正在播放的冷門歌曲停下。這個非搶佔限制既比較符合播歌直覺,又令熱門類仍會受到當前歌的殘餘時間影響。若誤用可隨時切歌的搶佔模型,便會得到另一組等待公式。
對兩級非搶佔優先的 M/G/1 系統,令 W0=λ E[S²]/2。熱門類平均排隊等待為 W0/(1−ρ_H);冷門類平均為 W0/[(1−ρ_H)(1−ρ_H−ρ_L)]。直覺上,熱門請求只需和其他熱門請求爭奪服務機會,並承受當前正在播放歌曲的殘餘時間;冷門請求則除了原本已存在的工作外,還要等待在它排隊期間後來抵達、仍可優先服務的熱門請求。後者多了一個與總負載有關的分母,接近容量上限時會成為巨大等待差異。
把 λ_H=0.68、λ_L=0.24、ρ=0.92 代入,W0=0.46,得熱門平均 0.46/0.32=1.4375 時槽,冷門平均 0.46/(0.32×0.08)=17.96875 時槽。兩者的比值為 12.5。這個差距並非來自對冷門歌採用較長的服務時間,也不是冷門請求自然比較難處理;它完全源於排序權利的不同。這使得排程成為可研究的規範選擇:平台即使宣稱「所有人均可點歌」,依然可能因持續給熱門請求優先權而造成可預期的長時間差。
從穩態概率角度看,只要總負載仍嚴格低於一,兩類在標準模型下都沒有必然永久不獲服務。等候很長不是永久無窮。單憑「低優先權」三字就把永續飢餓概率寫成一,是數學上不負責任的推論。真正需要警惕的情形是高優先流本身達到或超過播放器容量;例如 λ_H≥1 時,即使不計冷門請求,熱門流已無法穩定消化,新請求長期積累,冷門類也就失去可用的剩餘服務率。這時不存在本文公式要求的穩態等待分布,不能繼續把分母公式套到超載狀況。
用一個日常場景檢查:假設一首冷門歌剛好排在隊頭,上一首歌播完前又湧入數首熱門請求。熱門優先容許全部熱門歌先播,冷門歌再等待。若下一次播完時又有熱門請求,過程便可重演。有限時間窗內沒有播到的事件,並不需要所有人都故意排擠冷門歌,只需要在系統負載較高時持續到達且規則從來不要求照顧低優先權。這是集體結果與個人意圖可以分離的典型例子。
7. 五種政策的操作性定義
政策 A 是 FIFO,總隊伍按抵達時間排序。政策 B 是 Popularity first,兩類各自維持 FIFO,但每次選歌時只要熱門隊伍非空就先服務熱門。這兩套規則可以用上節公式與電腦結果交叉校驗。兩者都屬 work-conserving:只要有任何候播請求,播放器便立即開始下一首,不會為了堅持某種形式公平而主動空置。故在相同到達序列和固定服務時間下,其長期總吞吐不應由排序規則本身改變,差異主要落在個別請求等待誰承擔。
政策 C 是 Vote lottery (9:1)。每到一個選歌時點,若熱門與冷門隊列都非空,就以概率 0.9 抽選熱門、0.1 抽選冷門;選中類別內仍然服務該類最早請求。若只有一類候播,就無條件播放該類。這個權重是研究假設,不來自實際歌曲的票數紀錄。它將「選擇有偏好」轉化為隨機機制,但也說明抽籤不一定十分公平:抽籤給冷門歌正概率,不代表在二十個時槽內必定成功,尤其在重負載下小概率多次落空會形成長尾。
政策 D 是 Aging 12。在兩類同時有人候播時,若冷門類最舊請求已等待至少十二時槽,下一首就服務該冷門請求;否則優先服務熱門類。若只有一類候播,立即取該類隊首。老化是用等候時間積累的「補償權」抵銷既有投票權重,使長期等待者在下一個決策點獲保護。這不是對每首歌作出絕對十二時槽保證:如果當前歌尚未結束、先前已存大量冷門請求,或同類較舊者正輪候,實際 W 仍可能高於十二。標籤中數字是啟動保護的門檻,不能偷換成確定的最長等待。
政策 E 是 Fair 2:1。兩類都非空時,按熱門、熱門、冷門的循環次序選下一首;若某類暫時沒有歌,就立即選另一類,不讓播放器空轉。這種服務配額不要求即時投票勝負決定每次選歌。它給冷門類周期性的保護機會,代價是部分熱門請求需要等候較久。這種簡化類別配額與網絡公平佇列的思想有關,但它並不按個別聽眾實行輪候,也不控制相同人多次提交;因此只可以稱為類別層面的排程公平。
不同政策共用完全相同的 Poisson 到達時刻和熱門/冷門標籤。除加權抽籤需要額外亂數外,其餘選歌決策都是當前隊伍、閾值與政策內部狀態的確定函數。這種 common random numbers 設計能令不同排程策略的差異更集中於規則,而不是因每次重新抽到不同程度的尖峰流量。當然,單一共享隨機軌跡仍只是一次合成實驗,若要為小幅排序差距推導置信區間,需跨多組獨立種子與較嚴謹的穩態批量均值方法。
8. 模擬事件、實驗窗口與可重現性
合成到達序列以 NumPy 亂數生成器和種子 2026102501 產生。由於兩個獨立 Poisson 流疊加後仍是 Poisson 流,程式先用強度 λ=0.92 的指數分布產生相鄰請求到達間隔,逐次累加為連續時間到達時刻,再以 λ_H/λ 作為熱門類別標籤概率。這等價於在各類別互相獨立的 Poisson 流下產生整體到達與類別標記。做法避免把到達固定在整數時間,因為這會變成另一種離散時槽模型,難以與連續時間 M/D/1 解析式作直接比較。
事件模擬中的時鐘在播放器完成當前歌曲後向前推進一時槽。每次需要選歌,先把截至當前時點已抵達的全部請求放入候播結構,再依政策抽出下一個工作。如果等待結構為空,時鐘才跳到下一個新請求抵達時點,令播放器在有工作時不會刻意閒置。記錄某請求開始播放時點 t_start 和抵達時點 t_arrive 的差,得到 W=max(0,t_start−t_arrive);歌曲播畢時間沒有被誤當成排隊等待。
每種政策處理同一組 185,000 個合成請求。正式報表只分析索引自 15,000 起至 170,000 前的 155,000 個請求,前十五千作為暖機緩衝,最後十五千作為終端效應緩衝。程式會在到達結束後清空所有隊伍,但清空階段的尾部請求不納入均值,減少刻意停止產生新請求造成的人工加速。這個窗口仍不保證完全消除自相關或穩態誤差,尤其接近滿載時隊伍會有較長的相關時間,應以多個獨立種子作後續穩健性研究。
對每項策略,儲存熱門與冷門的平均等待、中位、九十、九十五和九十九分位、超過二十及五十時槽的經驗比例,以及二十時槽內開始播放的經驗概率。並報告合併等待均值和兩類成功率的 Jain 指數。單位清一色是 song slots;如果一首歌長四分鐘,可以把理論時槽換算成分鐘作直觀比較,然而並不能因這個換算推論真實歌曲都長四分鐘。實驗紀錄 data/summary.json 保存全部設定、策略名稱、分析窗口和數字;另一個抽樣 CSV 只用來人工抽查個別請求,沒有被冒稱為完整資料集。
為了提供程式錯誤檢查,腳本在同一次運算中求出 FIFO 與嚴格熱門優先的解析基準,並設定容許有限樣本誤差的核對斷言。相同到達時刻應令總工作負載一致,但不表示各類平均等待必然精確等於理論公式;理論平均屬於無限時間穩態,合成樣本則具有時間截斷與高度相關的繁忙周期。這點在接近 ρ=1 時尤為重要,不能因一組數字接近理論就把模型視為現實已驗證。
9. 理論檢查:同一服務能力的代數結果
表一列出兩種可解析政策的排隊平均時間。由 M/D/1 理論,FIFO 不區分類別,兩類平均一樣是 5.75 時槽;嚴格熱門優先的兩類平均分別是 1.4375 和 17.96875。若所有工作只有一時槽,規則並沒有創造任何額外的播放容量:它只改變誰在高峰期間佔據服務順序。這個結果可理解為短期不便重新分配,而不是排程策略憑空增加或減少播放時間。
| 政策 | 熱門穩態平均 W_H | 冷門穩態平均 W_L | 理論適用範圍 |
|---|---|---|---|
| FIFO | 5.7500 | 5.7500 | M/D/1,ρ=0.92 |
| 嚴格熱門優先 | 1.4375 | 17.96875 | 非搶佔式兩級優先,ρ=0.92 |
解析值不能直接延伸到九比一抽籤、等候老化與二比一配額,因為三種規則的服務決策額外依賴隨機抽選、隊首等待歷史或循環狀態;把它們當作簡單固定優先級會得出錯誤公式。本文針對這三種政策使用事件模擬作探索,並以相同到達序列消除一部分輸入變異。尤其九比一抽籤不是「給熱門類九成總播歌量」的保證,因為當熱門隊列為空時,冷門類自然取得全部當次服務機會;兩類分流的實際比例由到達和排程互動決定。
穩態利用率相同亦不足以保證少數類別感受相同。觀察理論分母就能明白:ρ_H=0.68 代表熱門類本身的工作已耗去約六成八容量,而整體只剩 0.08 容量餘裕。冷門請求既承受熱門類的干擾,又依賴系統整體清空能力;因此微小的總負載變化能造成它的平均等待劇增。這個數學非線性,就是「明明每個人都可以點歌,某些歌卻始終排在很後」的核心機制之一。
政策間平均值可比較,卻不等於每一次請求都依此順序受益。某首冷門歌可能剛抵達時熱門隊列恰好為空,於是幾乎立刻播放;另一首可能碰上長期高峰而延遲很久。平均等待既受繁忙周期影響,也與分位和超期限概率有所差別。因此研究不能以一項平均公式取代完整的服務機會描述,更不能把十八個時槽的群體平均誤讀為每首冷門歌都必然要等待十八首歌。
10. 五種政策的合成等待結果
同一批合成到達請求在 FIFO 下的熱門及冷門平均等候約為 6.05 時槽,兩類幾乎一致,略高於理論 5.75 時槽。由於觀察窗口有限且繁忙周期之間不獨立,這種偏差不能簡化為一個小數位的數值錯誤。當政策改為嚴格熱門優先,熱門類合成平均約 1.44 時槽,冷門類約 18.88 時槽;理論分別預測 1.4375 及 17.96875 時槽。熱門均值與解析值十分接近,冷門均值亦在重負載、尾部高變異與有限樣本背景下合理地接近理論。兩條路線互相核對,支持程式對排隊機制的實作具有內部一致性。
| 排程策略 | 熱門平均等候(時槽) | 冷門平均等候(時槽) | 核心規則 |
|---|---|---|---|
| FIFO | 6.053 | 6.046 | 任何類別先到先播 |
| Popularity first | 1.440 | 18.883 | 只要熱門有歌就先播 |
| Vote lottery (9:1) | 2.102 | 17.041 | 雙類均有歌時九成機率選熱門 |
| Aging 12 | 5.327 | 8.065 | 冷門最舊請求等待至少十二時槽則獲保護 |
| Fair 2:1 | 6.612 | 4.492 | 雙類均有歌時兩熱門一冷門循環 |
表二所有數值均是固定種子產生的合成資料、有限窗口的經驗均值,並非實際點歌平台統計。九比一抽籤把熱門類平均等待由嚴格優先下的 1.44 提高至約 2.10,冷門類由 18.88 降至約 17.04,說明給予少數類別小量抽選機會可能有幫助,但在此組參數下仍存在相當大的平均等待差距。只按「是否有機會被抽中」這個程序標準來評斷,很容易忽略冷門類收到的機會可能在重負載下非常稀薄。
老化保護政策把冷門合成平均降至約 8.07,熱門類增至約 5.33;兩比一配額則令冷門平均進一步降至約 4.49,熱門類約 6.61。這些數字可解讀為在同一服務能力下改變時間成本的分攤。熱門派並沒有被完全取消點歌權,而是由最優先變成較接近其他人的輪候;冷門派也沒有免費獲得容量,只是在高人氣請求持續加入時得到可預見的服務機會。此結果只顯示本次負載、配額、到達比例和隨機種子的情況;若把熱門/冷門到達比例對調,或把公平配額由二比一改成九比一,排序可能改變。
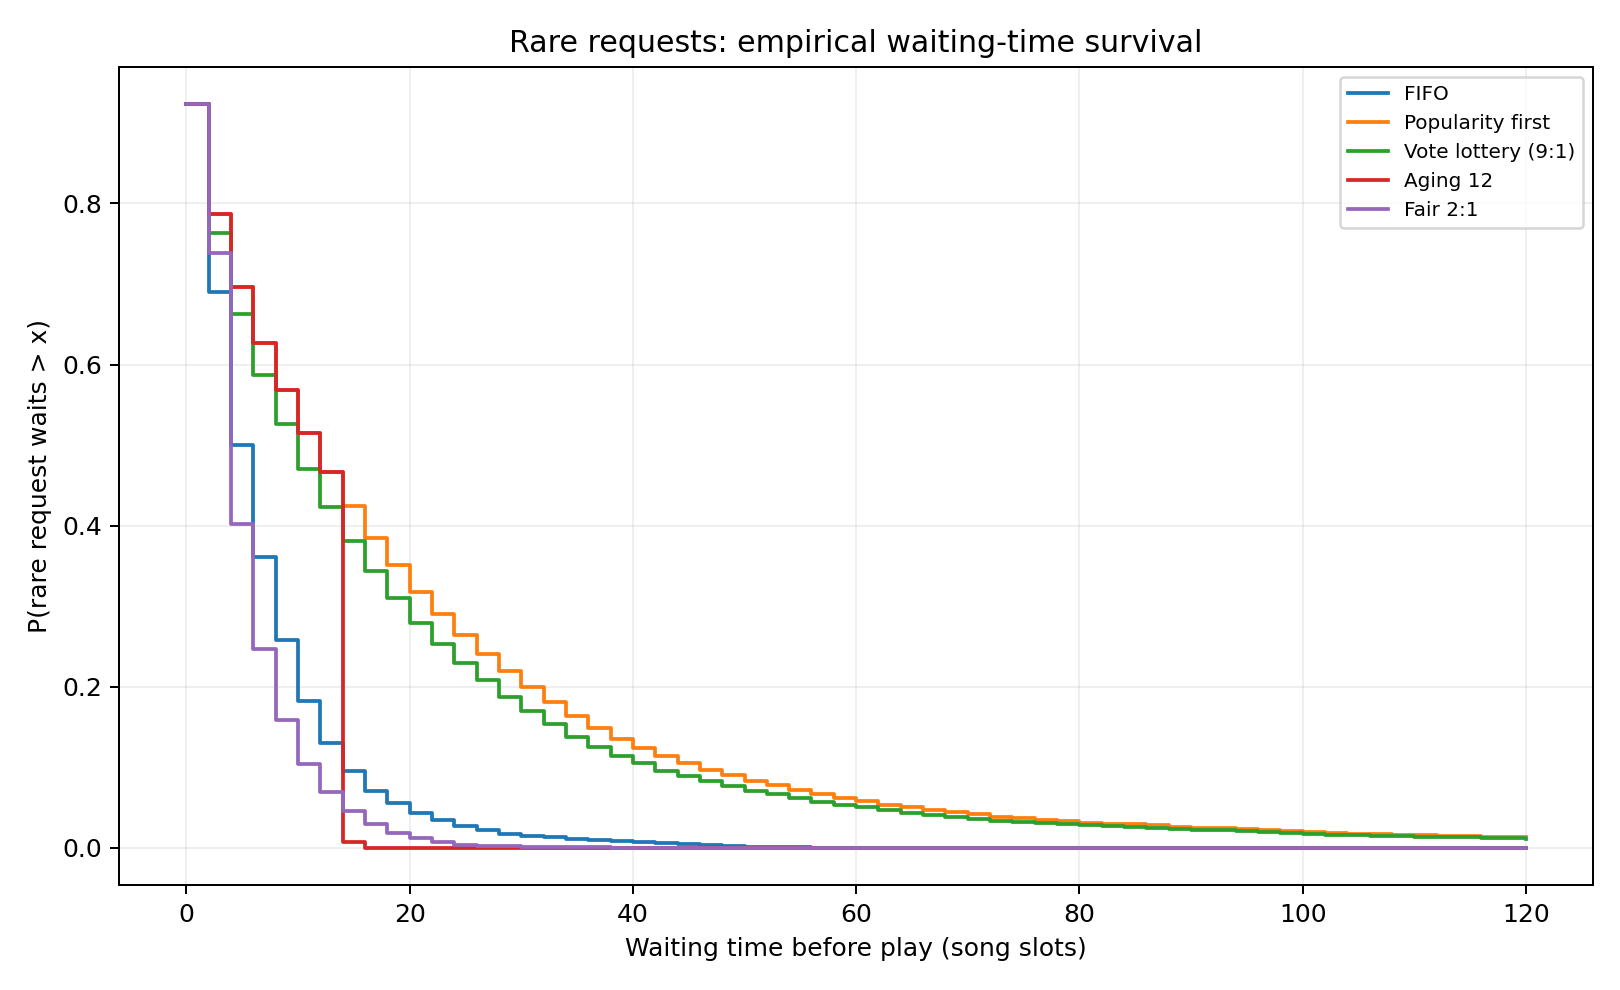
圖一使用觀察窗口中的冷門請求,對每個橫軸時槽 x 計算超過該時長仍未開始播放的比例 P(W>x)。這是合成樣本的經驗存活函數,橫軸不是歌曲的總播放長度,縱軸也不是「永遠不會播」的概率。圖中可直接看到各策略尾部如何衰減:以最受歡迎為唯一優先條件時,冷門請求較容易落在長等待區域;加入老化或配額後,尾部分布形狀改變。要評估某種「今晚來得及播」的規則,尾部曲線往往比合併平均更切題,因為它直接告訴我們在不同可接受時長下尚未獲服務的請求比例。
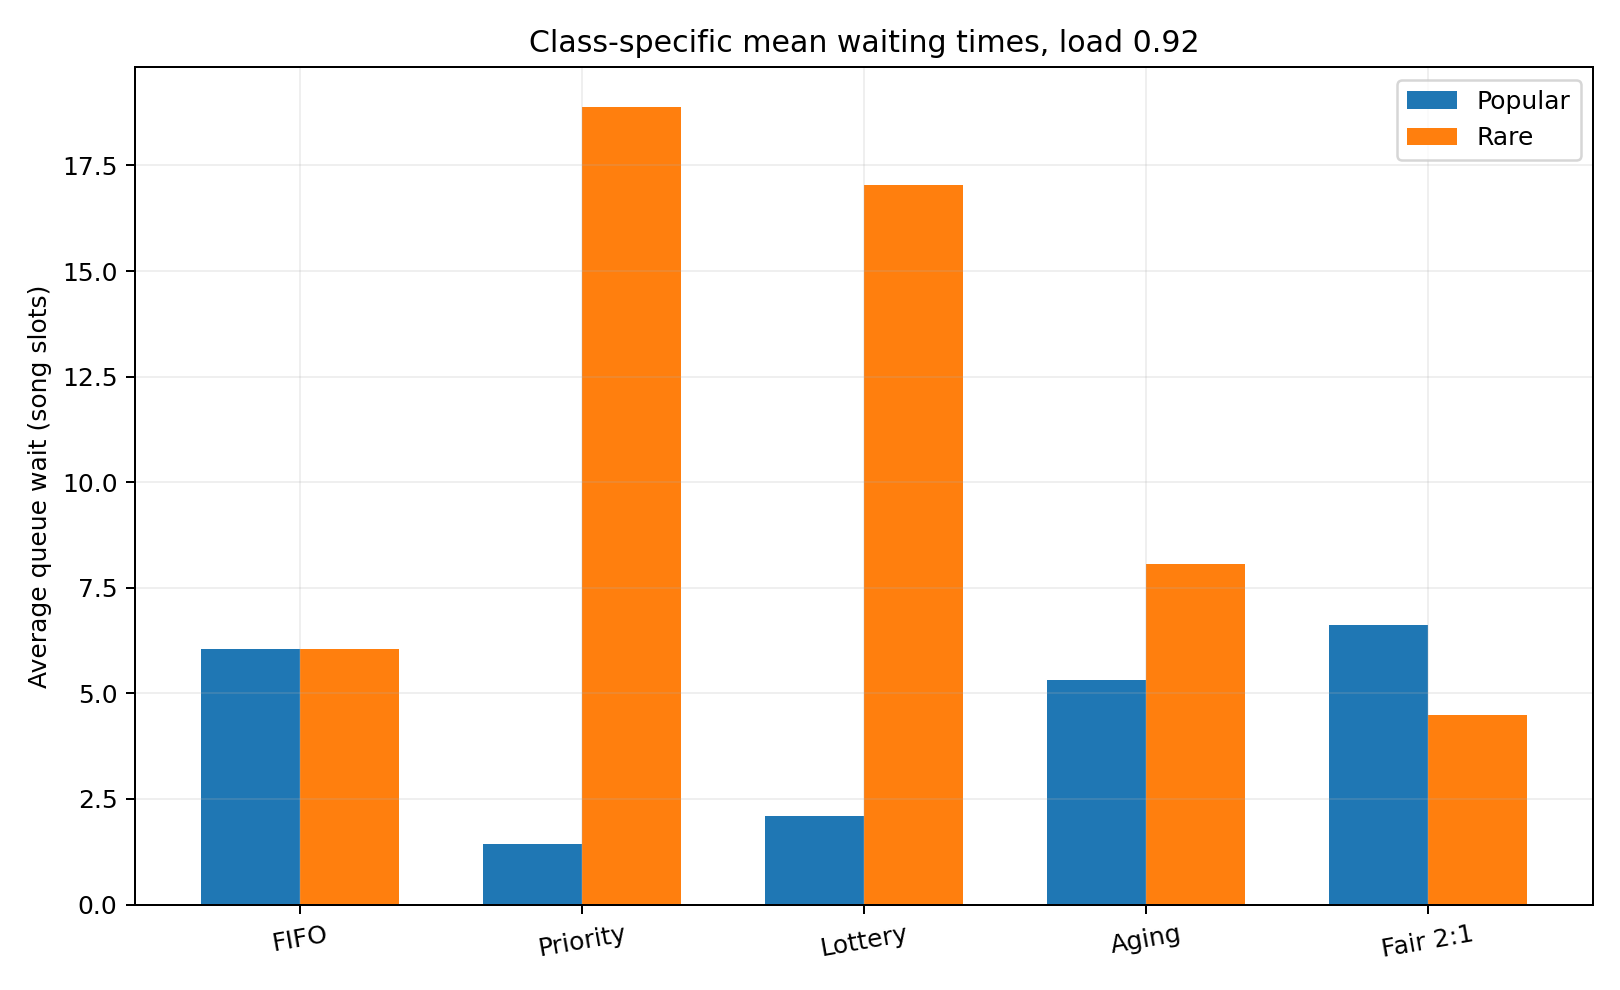
圖二以並列長條表示五項政策在同一資料窗口下的兩類平均,刻意不把所有請求合為單柱。使用全部請求的平均作為唯一成績單,熱門請求因本來數量較多而具有更高權重,於是冷門等待惡化可能被熱門等待改善抵銷。反過來,均等對待兩類的平均也未必等於「每個人公平」,因為一類內部可能包含不同點歌人數、重複提交和票數分布。本文只提出類別層面的診斷,並將個人層面差異留待獲得真正點歌身分匿名資料後再研究。
11. 二十時槽內能否播到:有限期限的服務可及性
把等待轉成可及性時,先定義一個事先指定的期限 h=20。若某首歌在抵達後不超過二十時槽開始播放,就記為成功;若 W>20,就記為有限期限內未獲服務。這個界線具有任意性,不同聚會可能有不同時長和聽眾耐性;但只要研究者公開 h,指標便可以客觀計算及重現。相比籠統指控某演算法「永遠無視冷門歌」,用明確期限可免除語義誤導。
其中 g 可為 H 或 L。p_g(h) 是從該類請求均勻抽出一項,於指定期限前開始服務的機率;s_g(h) 是該類的尾部失敗率。兩者之和為一,卻不能直接轉換成期望等待,因為平均是整個分布的積分,某個單點的尾部概率只刻畫指定時間。也不能拿 p_g(20) 說成「某首歌聽完的概率」;研究事件是開始播放,播完還要另加一時槽。
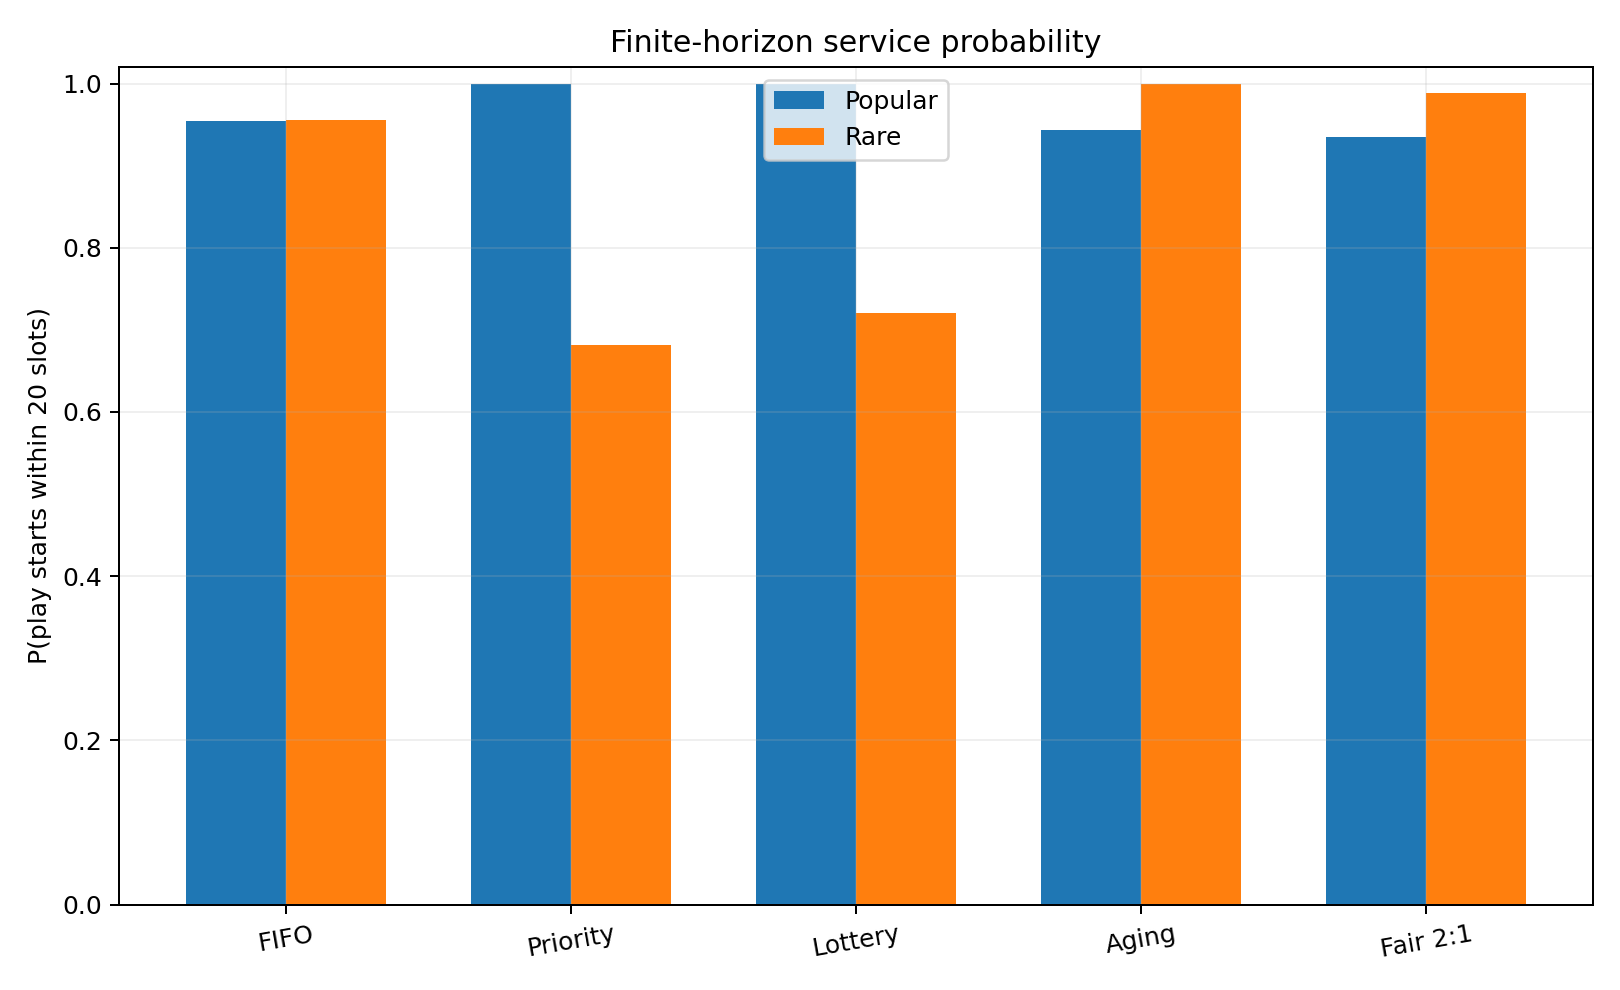
圖三把熱門與冷門的限期服務概率並列,使讀者能看見不同策略的機會分配。嚴格熱門優先令熱門歌較快被選中,而冷門歌的期限失敗事件更值得關注。老化保護將一部分服務決策交回等候時間,配額則在雙類均有請求時定期服務冷門隊首。此處不要把圖三理解成保證:即使某策略的成功比例較高,仍可能有個別請求因偶發繁忙周期而遠超期限;機率改善不能變成每項服務的最長等候承諾。
假如活動只有十個時槽長,使用二十時槽指標本身便不切實際;若活動可以持續數百個時槽,二十時槽可能又過於嚴苛。因此用一條完整的 P(W>x) 曲線搭配一個具有明確場景意義的標記期限,比只報單一百分率更負責任。真正部署系統前,應先與參與者商議何種期限可以接受,並把主持人是否會取消仍未播放的請求納入研究。本文僅以二十時槽作可重現的數值示例。
如果有人說「熱門的歌有九成機率被抽到,已經夠民主」,這句話還混淆兩種事件。九比一抽籤表示當兩類隊伍同時非空、播放器正要選下一首時,有九成概率從熱門隊列取一首;它沒有指定任何特定請求能在二十個時槽內開始播放的概率。選類別、選歌曲、服務時點與到達流量相互關聯,把單次類別抽籤概率直接當成個人服務概率,是排程分析中必須避免的邏輯跳躍。
12. Jain 公平指數的用途及陷阱
對類別層面的二十時槽服務成功率 p_H 與 p_L,定義 Jain 指數為兩者總和的平方,除以兩倍平方和。由基本代數或 Cauchy–Schwarz 不等式可知,兩類皆有正服務成功率時指數介乎二分之一與一之間;當兩類成功率相等時取一,若一類為零而另一類正值則取二分之一。這個定義沒有把熱門請求數量直接作權重,因為此處希望觀察兩個群體的待遇差異,而非把群體人數差異混入指標。群體權重的選擇是規範決策,不能說本設定就是公平的唯一形式。
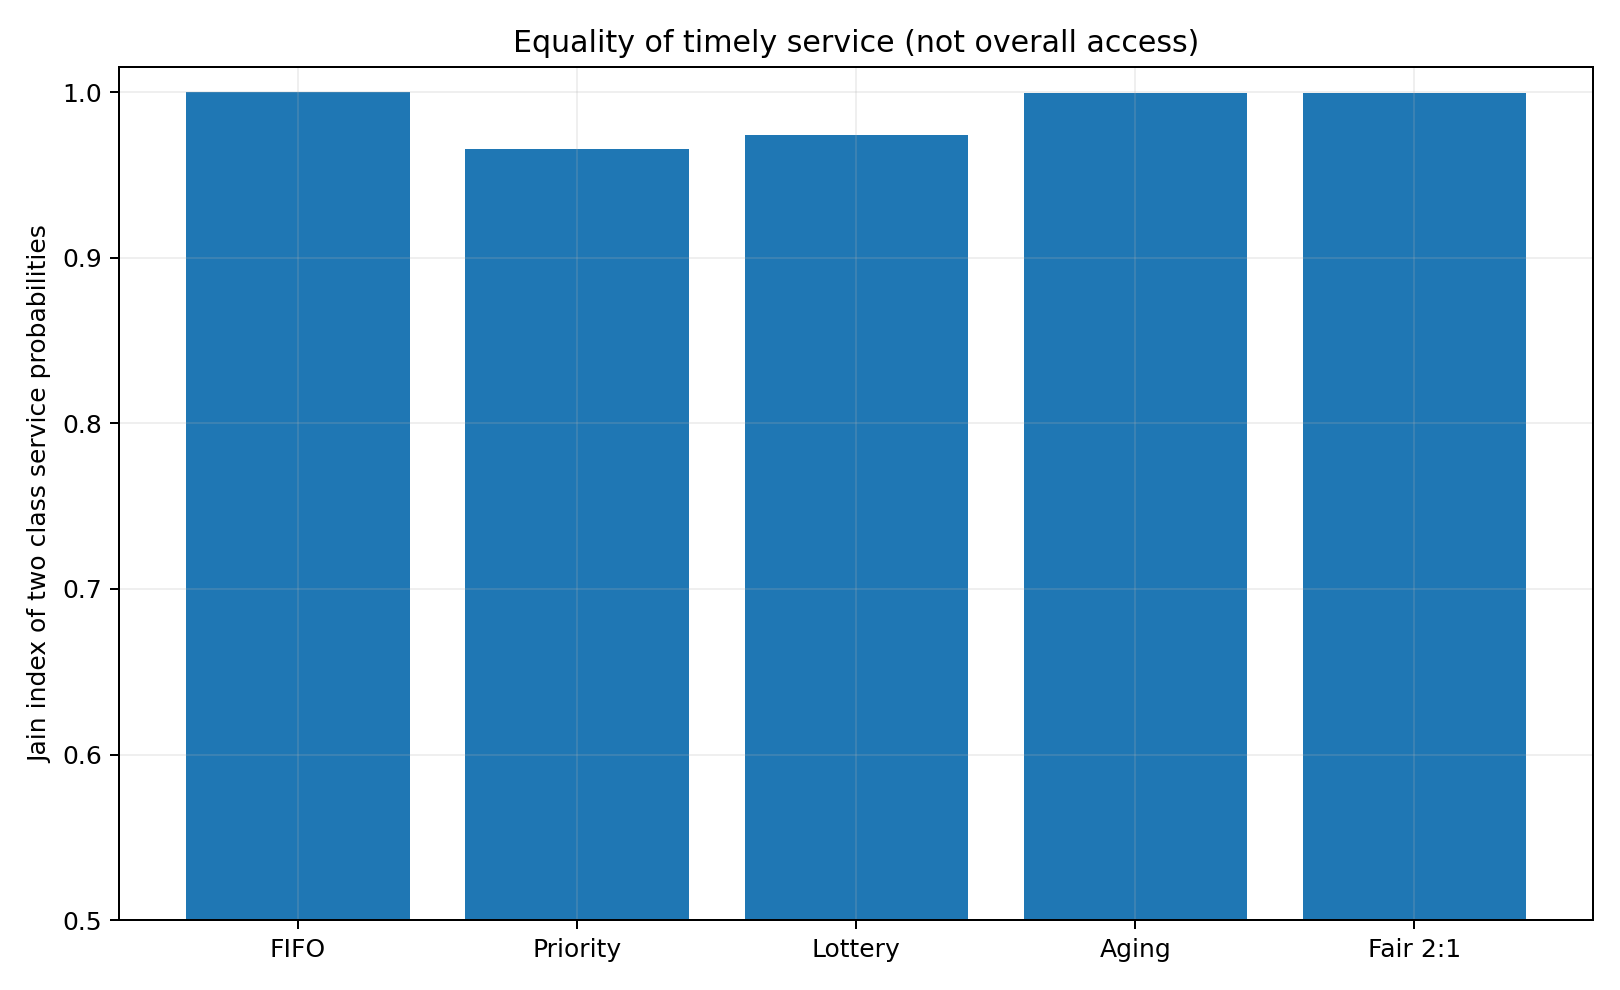
圖四提供不同策略下兩類成功率接近程度的摘要,但這只是眾多公平指標之一。假設兩類的服務成功率都只有 0.05,J 仍然等於一;這種系統雖然對兩類同樣糟糕,卻不會因指數低而被警示。反過來,若熱門為 1.00、冷門為 0.80,指數可能仍接近一,但兩成冷門請求錯過期限的情況對某些參與者已相當嚴重。因而每次引用 Jain 指數必須同時提供原始類別成功率或足以重建它們的數據。
另一個限制是把每個人等同於其歌曲類別。熱門類可能只有少數人重複點很多次,冷門類則包含許多只點一次的人;即使兩類各自的服務概率接近,個人的平均等待仍可能不均。又或者某人連續提交一百首歌,排程器按請求公平分配,該人仍可能獲得不成比例的注意力。若研究的規範目標是「每位參與者至少播一首」,就應建立以點歌人而非熱門標籤為索引的公平指標,並加入每人的提交上限。這些問題在本篇缺乏人員資料的模型中沒有被偷渡為已解決。
圖三和圖四應合併閱讀:圖三回答每類有多少請求在期限前獲服務,圖四回答兩類成功率相差多少。前者關乎充分性,後者關乎均等性;缺少任何一項都會令公平討論過度簡化。若制度設計重視播放者滿意度,還需要觀察歌曲質素和受眾分布;如果重視點歌者參與感,便須另外量度提議被接納的機會。本模型從來沒有把這些未量度的價值直接折算成一個公式。
13. 負載敏感度:接近滿載時的非線性代價
平均等待中最具戲劇性的項目是總負載接近一時的分母。為了讓這種關係不依賴單一模擬樣本,圖五將總到達率 ρ 從 0.55 連續改至 0.98,同時保持熱門比例為基準的 0.68/0.92,使用 M/D/1 理論式計算 FIFO、嚴格優先熱門和嚴格優先冷門的平均等待。圖中每一點均為解析公式的代入值,並非從真實歌曲紀錄擬合出的回歸曲線,亦不是另一次新的模擬實驗。
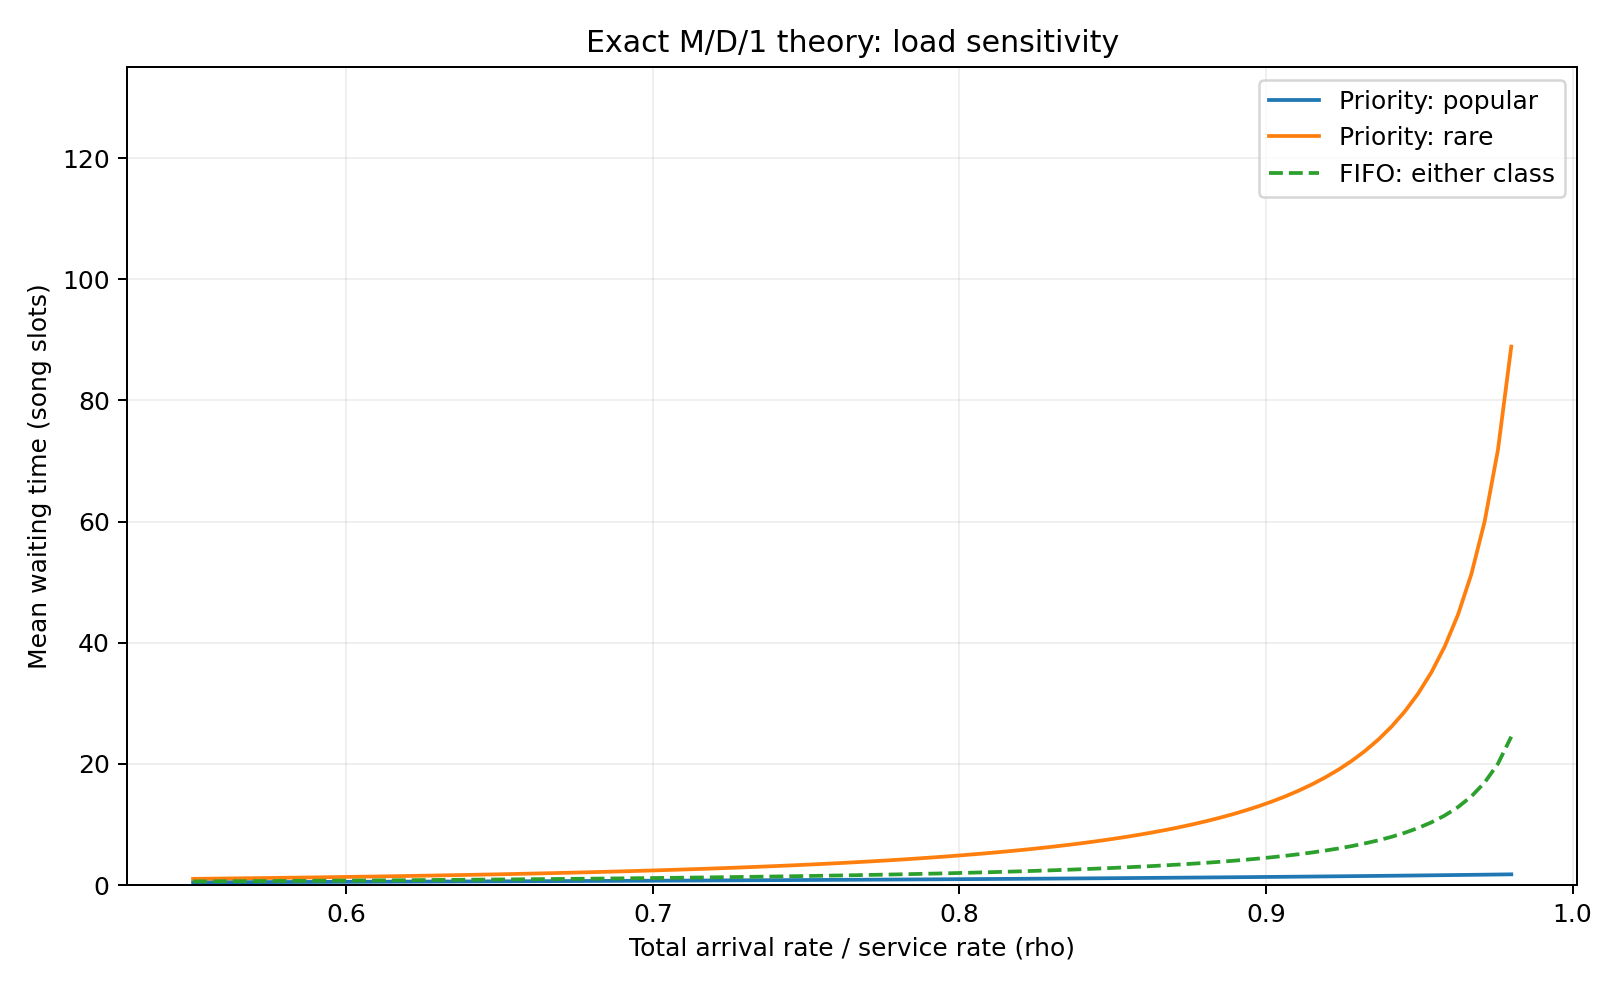
從公式可見,當 ρ→1 而熱門比例固定小於一時,FIFO 平均等待與 1/(1−ρ) 同階增長;嚴格優先冷門平均還帶有 1/(1−ρ_H) 因子。如果熱門佔比也同時逼近一,冷門類的雙重分母可能令不利條件更嚴重。這種敏感度提醒我們,政策優劣不應僅在輕載時測試:在負載很低的清單中,幾乎所有請求都可快速播放,各種策略的差別自然很小;真正有爭議的情況往往是所有人同時點歌、很少有空閒服務時段的聚會。
然而,接近滿載並不等於系統已經不穩定。ρ=0.92 雖然可能產生較大尾部,仍滿足 M/D/1 的一般穩態條件。只有當 ρ≥1,工作平均到達速度不低於最大服務速度時,普通穩態等待分析的前提才失效。對某段有限長度的活動,任何負載都會有有限筆已產生請求,但不代表無窮時間下能形成穩定分布。若用有限模擬長度算一個平均值,再把它外推到超載系統的長期極限,便是在未說明條件下交換兩種不相容的問題。
圖五亦說明「服務能力」本身可以是設計變數。若播放系統只可連續播歌,便無法無中生有增加歌曲時間;但可以透過限制每人可提交請求數、設定投票/候補開放時間、避免重複計算同一首歌、或預先安排輪候時段來降低工作量。這些治理措施改變到達率,與單純在隊列內調整順序不同。若總需求遠超可用播歌時間,任何公平排程都只能重新分配稀缺,而無法令所有人的歌曲在今晚全部播到。
值得留意,如果需求較高的熱門類本身到達率已達一首/時槽或以上,嚴格優先之下即使冷門類只有少量工作,也可能長期無法得到正的剩餘服務率。此時討論不再是穩態下的長平均,而涉及系統是否有可持續服務機會。本文沒有為這種超載情境計算虛假的穩態成功率;真正的無窮時間飢餓必須在明確的到達、服務、棄單與排序政策條件下另行分析。
14. 研究限制、反例與潛在反向解釋
首先,模型的熱門和冷門分類由程式指定,沒有個體音樂偏好基礎。現實聽眾可能同時喜歡多種曲風,一首在某次活動中冷門的歌在另一場合可能壓倒性地受歡迎。票數也不是獨立到達的穩定標記:歌曲播出、社交談話、群體氣氛及演算法推薦都可能改變後續投票。本文獨立 Poisson 到達與固定類別機率的假設忽略這些回饋,因此最適合用來檢查規則機制,尚不適合做真正娛樂平台的性能預報。
其次,將每首歌都設為一時槽,令理論簡潔卻忽略服務時長分布。某些舞曲長八分鐘,片段式點歌可能只播放三十秒;一首歌亦可能在中途被切換。這些都會改變忙期長度和優先排程的代價。由於等待平均可能受 E[S²] 而非僅 E[S] 影響,把本研究的 18.88 時槽直接乘某個平均歌長,未必能重現真實分鐘分布。日後需要實際服務時間、不同類別曲長以及歌曲被跳過的記錄,才能建立可校準的 M/G/1 或更複雜的服務系統。
第三,本文在個別政策內使用固定機率抽選,並以同一個隨機種子控制輸入;結果的精確數字仍會受到有限樣本與政策內部隨機數影響。程式以共同到達流改善對比的可讀性,但沒有將相關觀測誤當成獨立樣本進行簡單 t 檢定,也沒有聲稱這一組種子的每個均值差異都具有統計顯著性。在重負載下,等待序列會因繁忙周期而高度自相關;要作政策置信區間,應使用獨立重複、再生周期或批量均值方法。
第四,研究只比較五個刻意指定的策略,並未對所有可能排程進行最佳化。兩比一配額在本次合成資料中的冷門表現較好,不代表所有場合都應使用它。若冷門類的到達率大幅增加,公平配額可能使熱門請求長時間等待;若聽眾更重視即時票選結果,較高的熱門權重或適度保留熱門插隊可能更合乎集體目標。排程選擇涉及社會偏好,理論能顯示後果,卻不能替使用者自動決定價值排序。
第五,服務成功率與滿意度並非同一件事。某人聽到一首不合場景的冷門歌,可能因為氣氛變化而不開心;另一人雖然自己的歌未播,卻仍十分喜歡別人的選擇。這些效用外部性、社交關係及時間偏好都不在本模型內。本文的「公平改善」特指類別請求的等候及限期服務機會,不能擴張為「整個聚會更快樂」。要判斷社會福利,需明確測量或經過授權收集人類偏好,並將匿名與資料保護納入設計。
最後,制度可以被使用者策略性回應。當熱門優先造成冷門歌等得太久,點歌人可能選擇把冷門歌改名、要求朋友集體投票、重複提交,或轉移到其他播放平台;這些行為會改變類別和到達率。純外生排隊模型不會自行生成策略性投票,因此即使完全重現本文圖表,也不能用來預言存在博弈回饋時的均衡。這是一個重要的反例:原本「公平」的配額也可能因大量重複請求而被少數人佔用,必須結合個人配額才能避免新形式的壟斷。
15. 討論:把「民主」改寫為具體的服務承諾
如果一個點歌系統只向用戶說「投票最高者優先」,它清楚承諾的是偏好累積能影響排序,並沒有承諾每個提議在合理時間內獲服務。這種規則在某些社交活動可能完全符合參與者的選擇,尤其當活動目標是盡量迎合多數人;但若宣傳口號改成「人人有機會參與播放」,便應公開少數請求在高負載下可能面臨的長期等待。本文的數學結果鼓勵制度設計者把口號拆成可檢查指標,例如接受請求的資格、最晚開始播放的時間、每位參與者的配額及取消請求的條件。
在數學上,熱門優先把短等待的好處集中給大量熱門工作,代價由較少的冷門工作承擔。單看總吞吐量,系統仍可保持播放器忙碌;這可能使表面性能儀表板顯得正常。正因整體容量沒有損失,更需要採用分群等待分布,才能看出受影響者是誰。用兩類平均和二十時槽成功率共同檢驗,可以避免把成功播放的熱門請求當成整個服務已公平的證據。
一個具可操作性的政策折衷是公開一個基本 FIFO 隊列,另設有上限的熱門優先插隊次數,並允許已等待超過門檻的請求進入保護隊列。這種混合制度能把人氣訊號與時間保障分開:熱門票數決定某些短期順序,老化門檻限制低優先者被無限新請求越過。本文的 Aging 12 只是保護機制的一個簡單示例,沒有對最優門檻作求解;實際部署應依活動長度、可容納曲目數與參與者偏好調整。
對公平配額而言,機制應處理隊列為空與參與者重複提交兩個邊界條件。如果冷門隊列暫時沒有歌,為了堅持兩熱門一冷門而讓播放器空閒,反而會增加所有人的等待;本研究採用工作守恆規則,避免這個非必要的效率損失。若每位聽眾可以無限制提交歌單,類別配額也未必保障個人公平,因為同一個人可以佔據多個類別內位置。未來系統若宣稱保障個人參與,就應讓規則的最小保障單位對應到真正的參與者,而不是只對應抽象歌曲類別。
「今晚沒有播到」的抱怨通常還包含心理因素:看見自己的歌不斷下跌,可能比一開始就知道需要等很久更令人不滿。本研究沒有量度失望感,但可以為日後行為研究提供一個準確的處理變數:預告等待時間、可見排序和被後來者越過的次數。相同的實際等待 W,在不同預期與透明度下可能產生不同滿意度。排隊理論可先確定客觀等待,再由實驗檢查主觀感受,兩者不應混寫為一個沒有證據的結論。
16. 結論與未來研究
本文把「民主點歌為何可能讓冷門歌播不到」轉化為有限容量下的明確排隊問題。對獨立 Poisson 到達、固定一時槽服務、總負載 0.92 的 M/D/1 模型,FIFO 穩態平均等候為 5.75 時槽;嚴格熱門優先則使熱門與冷門的解析平均分別為 1.4375 和 17.96875 時槽。這組公式直接證明同樣的服務能力下,排程權重可以製造很大的類別等候差異,即使每項請求都成功進入候播清單。
固定種子的合成事件模擬在相同到達序列下比較了五種策略。嚴格熱門優先的冷門合成平均約 18.88 時槽,兩比一公平配額約 4.49 時槽;熱門類則因配額失去部分原先的即時優先地位。圖表同時展示冷門等待尾部、兩類限期服務成功率及服務機會均等性。這些結果與解析基準互相一致,惟只對所述參數和生成規則成立,不能聲稱真實平台已出現同等差距。
數學上更需要清晰區分的是:「二十時槽內未播放」不等於「無窮時間都播不到」。在總到達率低於一且標準排隊穩定的條件下,非搶佔優先可以令冷門類等很久,但並不自動令其永久沒有服務;若高優先工作本身持續佔滿播放器容量,穩態分析亦不再適用。這項區分令文章的荒誕標題保持幽默,而其所含的概率命題仍然可證、可反駁。
後續工作應先取得經當事人授權及匿名處理的真實點歌請求資料,包括時間戳、匿名參與者、歌曲長度、最初排序、投票變化、取消及實際播放時刻。其次比較隨機抽籤、個人輪流、曲目類別配額、門檻老化及帶有最高等待保證的混合規則,並做跨場景、多個種子的穩態統計。第三,將演算法評估與真實參與者的等待容忍度、音樂偏好和公平感連結,從「誰得到服務」擴展至「服務是否符合當事人的價值」。在取得這些實證之前,本論文只提供一個可重現、可供批判的數學起點。
參考文獻
Demers, A., Keshav, S., & Shenker, S. (1989). Analysis and simulation of a fair queueing algorithm. Proceedings of the Symposium on Communications Architectures & Protocols, 1–12. https://doi.org/10.1145/75246.75248
Harchol-Balter, M. (2013). Performance modeling and design of computer systems: Queueing theory in action. Cambridge University Press. https://doi.org/10.1017/CBO9781139226424
Jain, R., Chiu, D.-M., & Hawe, W. R. (1984). A quantitative measure of fairness and discrimination for resource allocation in shared computer systems (DEC Research Report TR-301). Digital Equipment Corporation. https://www.cs.wustl.edu/~jain/papers/fairness.htm
Kleinrock, L. (1975). Queueing systems: Volume I. Theory. John Wiley & Sons. https://www.wiley-vch.de/en/areas-interest/mathematics-statistics/queueing-systems-978-0-471-49110-1
Parekh, A. K., & Gallager, R. G. (1993). A generalized processor sharing approach to flow control in integrated services networks: The single-node case. IEEE/ACM Transactions on Networking, 1(3), 344–357. https://doi.org/10.1109/90.234856
Shreedhar, M., & Varghese, G. (1995). Efficient fair queueing using deficit round robin. Proceedings of the Conference on Applications, Technologies, Architectures, and Protocols for Computer Communication, 231–242. https://doi.org/10.1145/217382.217453