摘要
有限的校本數學評核時間迫使教師在課程技能覆蓋、不同學生能力輪廓的可觀察作答機會,以及超時風險之間進行配置。已有自動化組卷、機會約束組卷及穩健次模最佳化研究,惟各框架對「技能是否真正可觀察」、「群組差距如何計算」和「時長上限是否具有可檢驗保證」的建模選擇,往往需要在具體教學情境重新說明。本文針對香港高中數學延伸部分單元二(M2)的假設校本短測,提出一個透明的、以明確方法給分技能為基礎的模型。先以研究者編碼的有向無環圖描述題目先修關係,再以獨立伯努利機率的至少一次可觀察成功事件建立群組技能覆蓋函數;對長方形區間不確定集取最不利成功率,並以 Hoeffding 有界獨立隨機變數不等式推出足以控制超時機率的決策證書。本文形式化證明:每個群組的覆蓋函數單調且次模;群組最低覆蓋的點態最小值一般不具次模性;截頂後的群組平均函數仍次模,且可精確表示同時達標的可行性。進一步推導已知限制下的邊際覆蓋率、題目支配刪減條件及有限題庫的完整搜尋判準。以 11 道虛構題目、7 個可評核技能、3 種假設輪廓與 20 分鐘上限作 2¹¹=2,048 個題組完全枚舉,其中 201 組通過 10% 超時風險的保守證書。以最低群組覆蓋最大化的題組得分為 0.746674,若改以預設輪廓權重最大化總體平均,最低覆蓋下降至 0.668897(差 0.077777),但加權平均提高約 0.011671。另發現單純按平均時長選題的最優題組在本研究獨立兩點式時間例子下超時機率恰為 25%,不符 10% 風險目標。全部結果可由公開原始程式與參數重現。本文成果是結合既有最佳化理論的具體模型、命題與透明反例,並非現行香港公開試的實證結論;外部新穎性審查、評分者研究及真實學生資料驗證仍待完成。
關鍵詞: 香港數學教育;延伸部分單元二;校本評核;試題組卷;機會約束;次模函數;穩健最佳化;學習機會
Abstract
Time-limited school mathematics assessments require explicit trade-offs between curriculum coverage, opportunities to demonstrate distinct skills, and uncertainty in item completion times. We formulate a reproducible illustrative model for a Hong Kong senior secondary Mathematics Extended Part Module 2 (M2) quiz. Each hypothetical item includes a set of explicitly marked observable skills organized along a researcher-specified prerequisite directed acyclic graph. For each of three hypothetical performance profiles, normalized coverage measures the probability that each skill is successfully demonstrated at least once. Rectangular intervals for item–skill probabilities yield a tractable conservative lower-envelope objective. Independent and bounded response times permit a sufficient duration-risk certificate via Hoeffding's inequality. We prove that profile-specific coverage is monotone submodular, while the minimum across profiles need not be submodular. We derive a capped-sum feasibility representation, a dominance rule, and precise conditions for applying cardinality-based greedy bounds. Exhaustive enumeration of 2,048 subsets of eleven invented items identifies 201 certified sets under a 20-minute duration limit and a 10% exceedance-risk requirement. The certified max–min solution achieves a minimum normalized profile coverage of 0.746674; optimizing a separately specified weighted average reduces this minimum to 0.668897 while increasing pooled coverage by 0.011671. In a separate independent two-point time illustration, the max–min design that merely respects mean duration has a 25% probability of exceeding the limit. These values are properties of declared hypothetical inputs and provide no evidence of empirical differences among Hong Kong students or of existing HKDSE marking practices. The paper contributes an auditable assessment-design example and model-specific deductions built on established automated test assembly, concentration inequality and robust submodular optimization results.
Keywords: Hong Kong mathematics education; Module 2; school-based assessment; automated test assembly; chance constraints; submodularity; robust optimization; assessment opportunity
1. 引言
1.1 香港高中數學評核的具體情境
香港高中數學課程包含必修部分以及延伸部分單元一(M1)和單元二(M2)。教育局的數學課程文件及高中數學課程與評估指引就數學理解、解題、推理與表達提供教學方向;考評局則按年度公布文憑試數學科評核大綱(教育局,2017;考評局,2026)。現行的課程安排並不意味著所有數學技能都可由同一題目充分評核,亦不意味著只靠總答對題數便能判別學生是否掌握各個先修概念。
在一個研究者構造的校本 M2 短測中,教師可能希望同時觀察「基本代數操作、函數表達、基本微分、鏈式法則、駐點判斷、不定積分、定積分」等七種技能。考慮時間限制:若增加一題綜合題,通常會同時增加不同技能的覆蓋機會,但題目完成時間可能偏離預期;若完全採用最短題目,可能又無法觀察較深層的推理。更複雜的是,不同假設能力輪廓對不同題型的成功機率可能不同。僅最大化加權平均覆蓋,並不必然最大化覆蓋最低輪廓的學習機會。
在本文中,「群組」並非按性別、收入、語言、學校類別等真實人口變項劃分,而是模型用來分析設計穩健性的三組虛構參數。它們也不代表真實的個別考生。本文既不設定香港學生實際達標比例,也不對任何教育群體作能力標籤;甲、乙、丙僅用於證明數學模型在目標函數改變時可能出現不同答案。單元二的課程關聯是技能範例背景,並不等於本文的假設短測是官方 M2 試卷。
1.2 四個研究問題
問題 RQ1: 如何精確定義多題組的「技能覆蓋」,使它反映每項有明確評分證據的技能至少一次被觀察到,而不把題目包含的全部先修知識自動視為已測量?
問題 RQ2: 在題目作答時間只有均值和有界幅度、缺乏確切概率分佈的情況下,能否寫出可逐個題組檢查的超時風險充分條件?
問題 RQ3: 不同輪廓的平均覆蓋、最差覆蓋與群組同時達標的條件,有何次模結構及最佳化上的限制?
問題 RQ4: 在完全公開的有限假設題庫中,若採用不同目標及不同時間可行性定義,選中的題組與覆蓋差距會出現甚麼變化?
1.3 研究貢獻與概念邊界
這是一篇理論研究工作論文。新加入的研究內容包括:為 M2 校本題目明確區分「先修技能」及「評分規準中可觀察的技能」;定義長方形成功率不確定集下的輪廓最低覆蓋目標;將可證明的時長機會約束用作題組篩選器;針對這一指定模型推導覆蓋邊際式、支配替換規則及達標等價判準;最後給出可完全枚舉的反例與數值比較。
須明確界定: 自動化題組配置、Set Cover、次模最大化、截頂飽和技巧及 Hoeffding 不等式全部已有成熟文獻(Hoeffding, 1963;Nemhauser et al., 1978;Wolsey, 1982;Krause et al., 2008;Spaccapanico Proietti et al., 2024)。本文不得把這些既有工具描述成首次發明。本文的特定配方及應用仍須由更完整的文獻檢索判斷是否構成學術上足夠的新穎貢獻。
2. 文獻綜述
2.1 自動化題組配置與內容約束
van der Linden(2005)比較在電腦自適應測驗下滿足內容約束的多種選題方法,討論序列式選題與同時選題的差別,以及 shadow test 對整體限制的考慮。這證明「必須同時兼顧內容、考試約束和最佳化目標」不是新的組卷問題。本文選擇固定、非自適應、規模較小的校本短測,以便把可解釋的技能目標及超時風險明確分開。本文既不估計 IRT 試題資訊函數,也不討論電腦適性測驗的暴露控制。
van der Linden、Scrams 與 Schnipke(1999)以統計作答時間模型和 0–1 線性規劃研究時間限制造成的測驗差異。與該研究相比,本文沒有個別考生實測作答時間資料,也沒有為真實群組建立反應時間分佈。本文的時間模型只給定獨立、有界及已知均值三個假設,用分佈無關的集中不等式求保守證書;其嚴格性來自假設與推導清楚,而不是實際參數已獲校準。
Spaccapanico Proietti、Matteucci、Mignani 與 Veldkamp(2024)在 Journal of Educational and Behavioral Statistics 提出機會約束的自動組卷方法,以 bootstrap 反映題目參數不確定性,並考察最差資訊量的某一分位數;研究另使用 TIMSS 資料。故機會約束本身已有正式前例。本文的機會約束是另一個參數:整份試卷作答時間是否超過預定時間,與上述試題資訊量的抽樣分位數約束不同。
2.2 次模覆蓋與穩健最差情況
Nemhauser、Wolsey 與 Fisher(1978)建立單調次模函數在基數約束下的經典貪婪近似理論;Wolsey(1982)研究次模 Set Cover 的貪婪方法。Krause、McMahan、Guestrin 與 Gupta(2008)提出 robust submodular observation selection 的演算法,其中的 submodular saturation 用於處理多個可能目標函數的最壞表現。由多個單調次模函數取最小值並不必然維持次模性;這是既有穩健次模研究必須處理的核心現象,本文不把它當作普遍首次發現。
本文以可觀察技能的「至少一次成功」表示覆蓋,此構造本身就是機率加權的 Set Cover 類函數。與抽象觀測選取不同,本文強制每個可觀察技能連接到題目可實際判分的環節,以免從概念上混淆技能先修與能力診斷;然而,這種可判分性只是示例事先規定的性質,仍需教師在真實題目作編碼一致性檢驗。
2.3 先修技能與香港數學教育
Leighton、Gierl 與 Hunka(2004)以 Attribute Hierarchy Method 討論技能層次的認知評估;Tu 等(2019)進一步研究受限 Q-matrix 下的階層式認知診斷。這些研究對「先修技能不是任意集合」提供了原有理論背景。本文使用研究者指定的有向無環先修圖,但其邊是教學設計假設,不是由考生資料估計的能力結構,亦沒有宣稱可直接用於認知診斷。
香港教育局的《數學教育學習領域課程指引》及高中數學課程材料為題目的課程關聯提供官方依據。教育局亦公布延伸部分持續優化的資料,包括自 2027 年起的部分試卷示例安排(教育局,2024–2026 官方專頁)。這提醒研究必須分辨「正式公共考試規範」與「教師自行建構的校本題組」。本文的 20 分鐘和 11 題都只供校本例子使用,不是 HKDSE 的正式考試時長或題數。
2.4 本研究尚未解決的文獻問題
雖然本輪搜尋涵蓋香港教育局與考評局、出版社 DOI 頁、JMLR 原始研究、數學最佳化期刊及相關機構存檔,但尚未全面檢索付費書章、所有會議、博士論文及繁簡雙語的非索引文獻。現階段能負責任地說明的是:本文選取一個可重現的香港校本問題設定,並對指定函數提供直接證明及反例;不能僅因尚未找到完全相同的題目標題,就認定這一問題設定此前絕無研究。
3. 理論框架
3.1 題庫、先修圖與可觀察技能
設有限題庫 V={1,…,n}、技能集合 H={1,…,K}、虛構學習輪廓集合 G={1,…,G₀}。某次校本評核選擇題目子集 S⊆V。每項技能 k 有非負規範性權重 wₖ,且 Σₖwₖ=1;在本文示例中 wₖ=1/7。
令 D=(H,E) 為無圈有向圖,a→b 表示 a 被研究者設定為 b 的先修步驟。對技能 k,A(k) 包括 k 及其祖先;對題目 i,教師若在題目評分規準中明確給每個祖先一個可評分步驟,可將所有祖先列入該題的實際可觀察技能集合 Rᵢ。本文示例採用此強假設:
其中 Tᵢ 是題目目標技能集合。對真實題目,式(1)不是必然成立:例如一題需要代數才能完成微分,並不表示老師一定為代數另設一個得分欄。真實應用時必須先以實際 rubric 分析獲得 Rᵢ,然後才可套用下文公式。
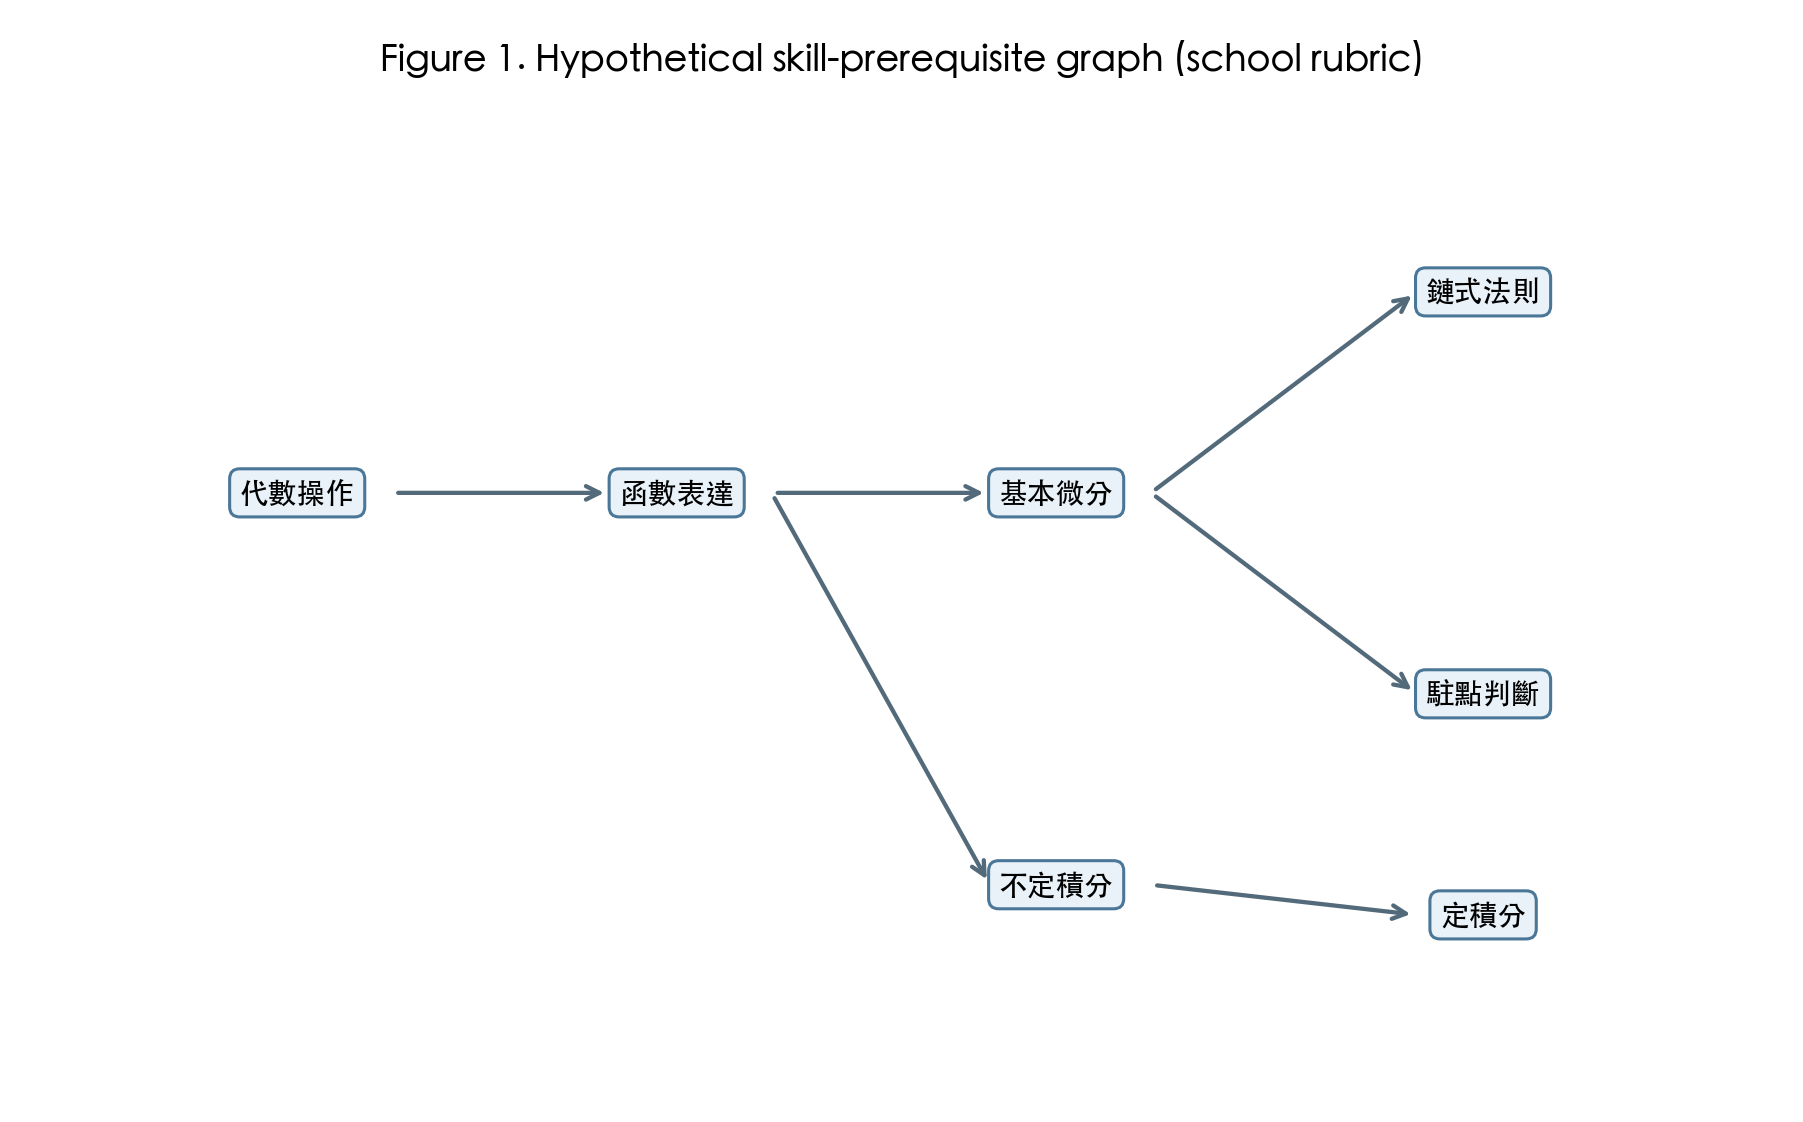
圖 1 研究者自行設置的假設 M2 校本短測技能先修圖。箭頭表示此特定教學方案採用的依賴邊;不是教育局核定的唯一技能階層,也不是由香港考生數據推估。
3.2 評分證據概率、獨立性及穩健下界
對輪廓 g、題目 i、技能 k,令 Z_{gik}∈{0,1} 表示假設隨機抽取一個符合輪廓 g 的作答情境,在題目 i 是否獲觀察到技能 k 的預設得分標準。若 k∉Rᵢ,設定 Z_{gik}=0。記真實但未知的條件機率 r_{gik}=P(Z_{gik}=1)。
假設 B1: 對固定 g,k,題目 i 間的 Z_{gik} 獨立;但不要求不同技能 k 之間、不同輪廓之間獨立。
假設 B2: 參數 r_{gik} 僅知落在長方形(逐坐標可獨立變動)的不確定集 [ℓ_{gik},u_{gik}]⊆[0,1]。
假設 B3: 各技能獲觀察一次就視為本模型的一次「覆蓋」,但一次成功不能直接證明已持久掌握技能。
在 B1 下,技能 k 在題組 S 內至少一次被觀察到的機率是
所以輪廓 g 的標準化技能覆蓋為
本研究的穩健設計目標定義為
因式(3)對每一 r 單調不減,故整個長方形不確定集的最不利情形在逐坐標取下界,得到
此結果建立在 B2 的長方形參數集上;若成功機率互有總額或相關限制,所有下界可能無法同時取到,式(5)就未必是緊的最不利值。本文程式以 ℓ_{gik} 作為透明、刻意保守的示例輸入,而非經抽樣求得的置信區間。
3.3 時間變數及機會約束
令 Tᵢ 為題目 i 的作答時長,單位分鐘;對固定題組 S,總時長 T(S)=Σ_{i∈S}Tᵢ。假設
假設 B4: 各題 Tᵢ 獨立、具有已知均值 μᵢ,且 Tᵢ∈[μᵢ−dᵢ,μᵢ+dᵢ],dᵢ≥0。
假設 B5: 題組是固定次序或允許計入總時長的完整作答集合,沒有候選人跳題後產生的內生時長模型。
設計限制: 時限 B>0、可容忍的超時機率 ε∈(0,1) 都是教師或研究者指定的政策參數。
目標是
以 Hoeffding(1963)可構造其充分條件
任何通過式(7)的集合都具有依 B4 可證明的分佈無關上界;不通過式(7)不代表一定超時或真實超時概率超過 ε。當 dᵢ 全為零時,定義平方根項為 0,式(7)退化為確定性時長限制。
3.4 研究最佳化問題
將兩種不同教育設計偏好寫成可比較的最佳化問題:
(P-F) max_{S⊆V} R(S) subject to C_ε(S)≤B。
(P-A) max_{S⊆V} Σ_g π_g F_g(S;ℓ) subject to C_ε(S)≤B,
其中 π_g≥0、Σ_gπ_g=1 是研究者自行設置的輪廓權重。兩者都使用相同的時長風險證書及技能覆蓋參數。P-F 最大化最差輪廓,P-A 最大化加權平均;哪種符合學校的評核構念,必須由課程與倫理討論決定,數學不能自動判斷它們何者「更公平」。
為展示風險限制的影響,另設僅按平均時長約束的比較基線:
(P-M) max_{S⊆V} R(S) subject to Σ_{i∈S}μᵢ≤B。
P-M 是常見但較弱的資源規劃問題,沒有提供式(6)的機率保證。
4. 方法、可重現性與分析規劃
研究先以定義及代數推導模型性質,再建構不含任何學生個人資料的有限假設題庫。對每一道題目,程式儲存其目標技能、研究者設定的先修祖先、時長 μᵢ±dᵢ、以及由「輪廓 × 技能」基礎值與「題目難度/相容度」共同決定的成功率下界。對 n=11 的所有 2¹¹=2,048 個題組,逐一計算 F_g、最差值 R、加權平均、預期時長和式(7)證書;以程式比對 P-F、P-A、P-M 的完整窮舉最優解,並按同值時較短平均時長、再按較小位元編號作決定性破同分規則。
程式另以每題「相等機率取時長 μᵢ−dᵢ 或 μᵢ+dᵢ」的明確假設兩點分佈,完全枚舉每個題組的 2^{|S|} 種時間狀態,精確求 P(T(S)>B)。兩點分佈只用來檢驗模型證書的保守性和平均時長基線的可能失敗;它並非真實作答時間模型。所有圖表標註「假設情境」,沒有把隨機生成數據偽裝成學生實測。
下面第五節逐一證明涵蓋的數學命題;第六節再報告程式結果。任何有限參數測試只是核查程式實作,不能取代一般性數學證明。
5. 數學推導與分析
5.1 命題一:成功機率不確定集的最差下界
命題 1。 在 B1–B3 及長方形不確定集 B2 下,式(5)對任何題組 S 成立,且對每個 g 有
證明。 固定技能 k,對 r_{gik} 考慮項 1−∏{j∈S}(1−r{gjk})。當 i∈S 時其單側偏導數為 ∏{j∈S,j≠i}(1−r{gjk})≥0;當 i∉S 時偏導為零。所有 wₖ 非負,故 F_g 對每個坐標 r_{gik} 單調不減。長方形不確定集容許所有坐標同時取其下界,於是式(8)取到且為最小值。取所有 g 的最小值即得(5)。證畢。
備註。 若研究者只知道每題的平均成功率,卻不知道跨題相關,式(2)不能成立,命題 1 的公式也可能不代表真正的「至少一次成功」機率。B1 及 B2 的可驗證性必須與數值結果分開。
5.2 定理一:單輪廓的次模性及精確邊際覆蓋率
定理 1。 對每個固定 g,在所有參數 ℓ_{gik}∈[0,1] 下,集合函數 F_g(S;ℓ) 是正規化(F_g(∅)=0)、單調不減而且次模的。對 i∉S,其邊際收益為
證明。 從式(3)展開加入題目 i 前後的差,某技能 k 的新增覆蓋為 (1−∏{j∈S}(1−ℓ{gjk})) 與 (1−(1−ℓ_{gik})∏{j∈S}(1−ℓ{gjk})) 的差,恰為 ℓ_{gik}∏{j∈S}(1−ℓ{gjk})。對 k 加權求和即得式(9)。每個因子非負,故邊際非負;因而 F_g 單調,且空集時乘積 1,所以 F_g(∅)=0。對任意 A⊆B⊆V、i∉B,由於 0≤1−ℓ≤1,有 ∏{j∈A}(1−ℓ{gjk}) ≥ ∏{j∈B}(1−ℓ{gjk})。代入式(9)得 ΔᵢF_g(A)≥ΔᵢF_g(B)。此即遞減邊際回報的次模定義。證畢。
可操作解讀。 在同一輪廓下,當某技能已被多道題覆蓋,再加一題提供同一技能的新增覆蓋就較小。式(9)亦讓教師解釋某題為何能補足原有題組的「未被觀察機會」,但它不是能力因果提升的估計。
5.3 反例一:最差輪廓的點態最小值一般不是次模
考慮只有兩道題 a、b、兩個輪廓 A、B 及一項權重為 1 的技能。設定 ℓ_{A,a}=1、ℓ_{A,b}=0、ℓ_{B,a}=0、ℓ_{B,b}=1。每個輪廓函數都是次模,但 R(∅)=R({a})=R({b})=0,而 R({a,b})=1。因此
這違反次模不等式,從而證明一般情況不能直接把單目標次模貪婪近似比套用到 P-F。如果把「某輪廓覆蓋最低」改稱為某種不加說明的綜合公平分數,亦不會自動保留良好的數學結構。
5.4 定理二:截頂後的同時達標判準
為研究每個輪廓是否至少達到覆蓋水平 τ∈[0,1],定義
定理 2。 U_τ 是正規化、單調、次模函數。對任何題組 S,
證明。 由定理 1,F_g 為非負、單調、次模。設 h_g(S)=min{F_g(S),τ}。對 A⊆B、i∉B,截頂後邊際可寫成
定理 1 告訴我們第一個 min 參數隨 A 擴大而不增;F_g 單調又使第二個參數隨 A 擴大而不增。故 Δᵢh_g(A)≥Δᵢh_g(B),因此 h_g 次模,且單調、非負。非負平均 U_τ 亦具有以上性質。其次,每項 min{F_g(S),τ}≤τ,若平均恰為 τ,每項必須恰為 τ,等價於每個 g 均有 F_g(S)≥τ;反方向顯然。證畢。
推論 2.1(有限題庫的精確可行性測試)。 令 𝒞_ε={S⊆V:C_ε(S)≤B},則存在滿足「所有輪廓至少 τ 覆蓋」且通過時長證書的題組,當且僅當
證明只須對式(12)取存在量詞。此為數學等價條件,不代表大型題庫可以在多項式時間內精確求解;帶有時間限制的次模覆蓋仍可能計算困難。
5.5 推論:基數限制下的截頂貪婪誤差界
為進一步解釋定理 2 的演算法用途,先另外假設只用題數限制 |S|≤k,不加入式(7)的時間限制;並假定存在一個大小不超過 k 的 S* 使 R(S*)≥τ。從空集開始,每一步挑選能使 U_τ 增加最多的題目,記第 t 步集合為 S_t(0≤t)。
推論 2.2。 設 k≥1。對貪婪法實際已執行的每一步 0≤t≤min{k,|V|},均有
證明。 因 U_τ(S*)=τ 且單調,U_τ(S_t∪S*)=τ。次模性表示加入 S* 的全部剩餘邊際總收益不超過 |S*∖S_t| 個於 S_t 的個別邊際和,而它至少是 τ−U_τ(S_t);故當 k≥1,有某個尚未選擇的元素,其個別邊際至少 (τ−U_τ(S_t))/k。每步取最大邊際,於是 τ−U_τ(S_{t+1})≤(1−1/k)[τ−U_τ(S_t)];以 U_τ(∅)=0 歸納即得(15)。另因 min{F_g,τ}≤τ,若其中最小的截頂值為 a_min,則 G₀U_τ≤a_min+(G₀−1)τ,亦即 a_min≥G₀U_τ−(G₀−1)τ。並且 R≥a_min;合併(15)及 R≥0 得(16)。證畢。
重要邊界: 當 t=k、群組較多時,式(16)的右端可能為零;故此推論不能聲稱只選 k 道題便自動滿足全部 τ 門檻。此外,式(15)–(16)只適用單獨的基數情境,不能忽略時間風險證書而把界照搬到本文 P-F 的組卷程序。此推論屬既有次模貪婪思想在本符號設定下的直接結果,不聲稱創造新近似演算法。
5.6 定理三:有界獨立時長的超時機率證書
定理 3。 若 B4 成立,則對每個題組 S 及 B>Σ_{i∈S}μᵢ,當 Σ dᵢ²>0 時,
從而 C_ε(S)≤B 蘊含式(6)的風險要求。如果 Σdᵢ²=0,則 T(S) 為定值 Σμᵢ,式(6)可直接判定。
證明。 由 B4,每個 Tᵢ−μᵢ 平均為零,取值區間長度為 2dᵢ,且對同一題組相互獨立。Hoeffding(1963)單尾不等式給出,對 t>0,
取 t=B−Σμᵢ 得式(17);令右方不超過 ε,開方移項便得到式(7)。若邊界 Σdᵢ²=0,所有 Tᵢ=μᵢ 幾乎必然成立,直接比較總和與 B 即可。證畢。
此證書是充分而非必要條件。當題目時間具有共同「作答速度」因素而不獨立,直接套用式(18)會失去理論保障;亦不應在沒有實測資料時把 dᵢ 說成由考生歷史估計的可信區間。
5.7 命題二:跨輪廓支配項的安全替換
命題 2(題目支配篩選)。 設兩道不同題 a、b 滿足:每個輪廓 g、技能 k 均有 ℓ_{g,b,k}≥ℓ_{g,a,k};μ_b≤μ_a;d_b≤d_a。對任何含 a 而不含 b 的集合 S,定義 S'=(S∖{a})∪{b},則
證明。 式(3)的每個技能覆蓋項對任何選中題目的 ℓ 坐標單調不減,故以逐坐標不小於 a 的 b 取代 a,不會減少任何 F_g。另一方面,時長證書中 Σμ 不會增加、Σd² 不會增加,且平方根函數單調,故 C_ε(S')≤C_ε(S)。證畢。
若在同一選題問題的額外規則中指定「每卷不得同時選 a、b」或題目順序、內容類別有額外限制,必須另外檢查替換是否維持那些約束;命題 2 只對本文明寫的規則有效。此命題本身不容許直接從整個題庫刪去 a:當題組原本同時包含 a、b,無法用 b 再次替換 a;兩題皆提供獨立成功機會時,保留兩題可能嚴格提高覆蓋率。例如一個輪廓、一項技能、兩題成功率同為 1/2,則單選 b 的覆蓋為 1/2,同選 a、b 的覆蓋為 3/4。故本文的「支配」是不含 b 的既有題組的安全替換規則;只有加入「a、b 不能同選」等相應約束並重新核實後,才可據此全局刪題。本示例沒有聲稱獲得某個特定運算加速率。
5.8 命題三:一般組卷的計算困難度
命題 3。 即使只考慮單一輪廓、沒有時間隨機性,而且每個 ℓ_{gik}∈{0,1},在題數上限 k 下判定是否存在 F_g(S)=1 的題組,仍可包含 NP-complete 的 Set Cover 決策問題。
證明。 由任意 Set Cover 實例:全集 H、各候選集合 Rᵢ、可挑選集合個數上限 k,建立每個技能等權、每題 i 的 ℓ_{gik}=1 當且僅當 k∈Rᵢ。則式(3)變為已選集合聯集佔全集的比例。設定每題 μᵢ=1、dᵢ=0、時間上限 B=k,則 C_ε(S)=|S|≤k。存在 F_g(S)=1 當且僅當存在最多 k 個集合覆蓋全集。轉換所需時間是輸入的多項式,因此問題至少與 Set Cover 決策同樣困難;在有限有理係數表示下可直接驗算一個候選集合,故此受限版本屬 NP-complete。證畢。
這個歸約表明 2¹¹ 完整枚舉對小題庫合理,但對大題庫不能假定具有可行的線性或多項式運算時間。次模貪婪、混合整數規劃、分支定界及穩健飽和等文獻方法是未來可能方向。
6. 研究結果:假設題庫的完全枚舉
6.1 情境與參數生成
本節是完全由研究者指定數字構成的數值實驗。沒有抽取香港學生、課堂、學校或公開考試的資料。設總時限 B=20 分鐘,最大容許超時機率 ε=0.10,所有七項技能的權重均為 1/7。輪廓甲、乙、丙分別是為測試目標差異而人工設立的「偏重積分」、「偏重微分」及「均衡」參數向量;這些標籤僅描述表內概率設定。加權平均設 π=(0.7,0.2,0.1);權重沒有聲稱反映人口構成、學校比例或教育政策優先順序。
表 1 假設題庫:題目時長與內容標記(全部研究者虛構)
| 題目 i | 目標技能代號(見下) | 時長均值 μᵢ(分鐘) | 半幅 dᵢ(分鐘) | 品質係數 qᵢ |
|---|---|---|---|---|
| 1 | 1 | 3.5 | 0.5 | 0.78 |
| 2 | 2 | 4.0 | 0.7 | 0.84 |
| 3 | 3 | 4.5 | 0.8 | 0.89 |
| 4 | 4 | 4.0 | 0.8 | 0.84 |
| 5 | 5 | 4.5 | 0.8 | 0.87 |
| 6 | 6 | 4.0 | 0.8 | 0.85 |
| 7 | 7 | 4.5 | 1.0 | 0.83 |
| 8 | 4、5 | 6.0 | 1.2 | 0.94 |
| 9 | 6、7 | 6.0 | 1.2 | 0.91 |
| 10 | 5、7 | 7.0 | 1.5 | 0.96 |
| 11 | 4、7 | 7.5 | 1.4 | 0.98 |
技能代號: 1 代數操作、2 函數表達、3 基本微分、4 鏈式法則、5 駐點判斷、6 不定積分、7 定積分。表內是目標技能 Tᵢ;實際「可觀察集合」Rᵢ 還包含按圖 1 指定的全部先修祖先,且假設每個祖先均有獨立可判分的 rubric 步驟。因此,表 1 不能用作對真實試題給分結構的描述。完整 Rᵢ 由原始程式以及輸出的 hypothetical_item_pool.csv 構造。
對每個輪廓 g 的每項技能 k,基準係數 b_{gk} 介乎 0.38 與 0.87;題目 i 的保守成功率下界按以下完全可重建的合成規則產生:
其中 a_{gi} 是人工設置的「輪廓—題目相容度」。除 a_{甲,11}=0.45 和 a_{乙,10}=0.50 之外,所有 a_{gi}=1。這兩個特設低值讓第 10、11 題在不同輪廓之間形成刻意的目標衝突;在較早、沒有這兩個差異的初步設定中,P-F 與 P-A 曾選中相同題組。因此以下結果說明衝突可能發生,而不支持它在香港學生中常見的敘述。區間上界 u_{gik} 對非零下界設為 min(1,ℓ_{gik}+0.06),非可觀察技能兩端均為零。下界不是估計得到的置信區間;區間半徑亦不是任何統計覆蓋率。
三個輪廓的完整 b_{gk}、每題 qᵢ、a_{gi}、圖 1 先修邊及全部 3×11×7 個 ℓ_{gik} 已寫入 result_summary.json 的 model 欄位,以免文字排版或小數截位阻礙再現。時間的兩點式參考分佈明定為每題以 1/2 機率分別取 μᵢ−dᵢ 和 μᵢ+dᵢ,題目之間彼此獨立。這只是額外規定的數學實驗分佈,不是推導 Hoeffding 證書所必需的分佈假設。
6.2 可行題組數量與完整最優解
11 個二元選題決策產生 2¹¹=2,048 個題組,包含空集。當 B=20、ε=0.10 時,當中 201 個滿足式(7);若只檢查預期時長,則有 406 個題組合格,當中 205 個未通過時長風險證書。證書通過率為 201/2,048≈9.814%;這是合成候選題組的比例,與學生超時的統計頻率沒有直接關係。
表 2 三種最適選題準則之完整枚舉結果(全部研究者虛構)
| 量度 | P-F:最差輪廓最佳 | P-A:加權平均最佳 | P-M:只限平均時長、最差輪廓最佳 |
|---|---|---|---|
| 選題編號 | 5、7、8 | 4、5、10 | 5、10、11 |
| 預期時長(分鐘) | 15.000000 | 15.500000 | 19.000000 |
| Hoeffding 時長證書 C₀.₁(分鐘) | 18.766155 | 19.531904 | 23.726000 |
| 輪廓甲覆蓋 | 0.774982 | 0.810092 | 0.796357 |
| 輪廓乙覆蓋 | 0.746674 | 0.668897 | 0.788268 |
| 輪廓丙覆蓋 | 0.788598 | 0.815090 | 0.896128 |
| 最低輪廓覆蓋 R(S) | 0.746674 | 0.668897 | 0.788268 |
| 加權平均 Σπ_gF_g | 0.770682 | 0.782353 | 0.804716 |
| 通過 B=20、ε=0.10 證書? | 是 | 是 | 否 |
| 獨立兩點式時間模型的精確超時概率 | 0 | 0 | 0.25 |
表 2 的 P-F 與 P-A 都是在同一組 201 個已通過證書的集合上求最優解。兩個目標使選題不同:相對 P-A,P-F 的最低覆蓋提高 0.746674222−0.668896862=0.077777360;相對 P-F,P-A 的加權平均提高 0.782352648−0.770681847=0.011670801。由於評估指標本身不同,不應將這兩個差額直接說成同一效用尺度的「淨改善」;其中 0.07778 是標準化覆蓋單位的絕對差,不是 7.78% 的學生成績增長。
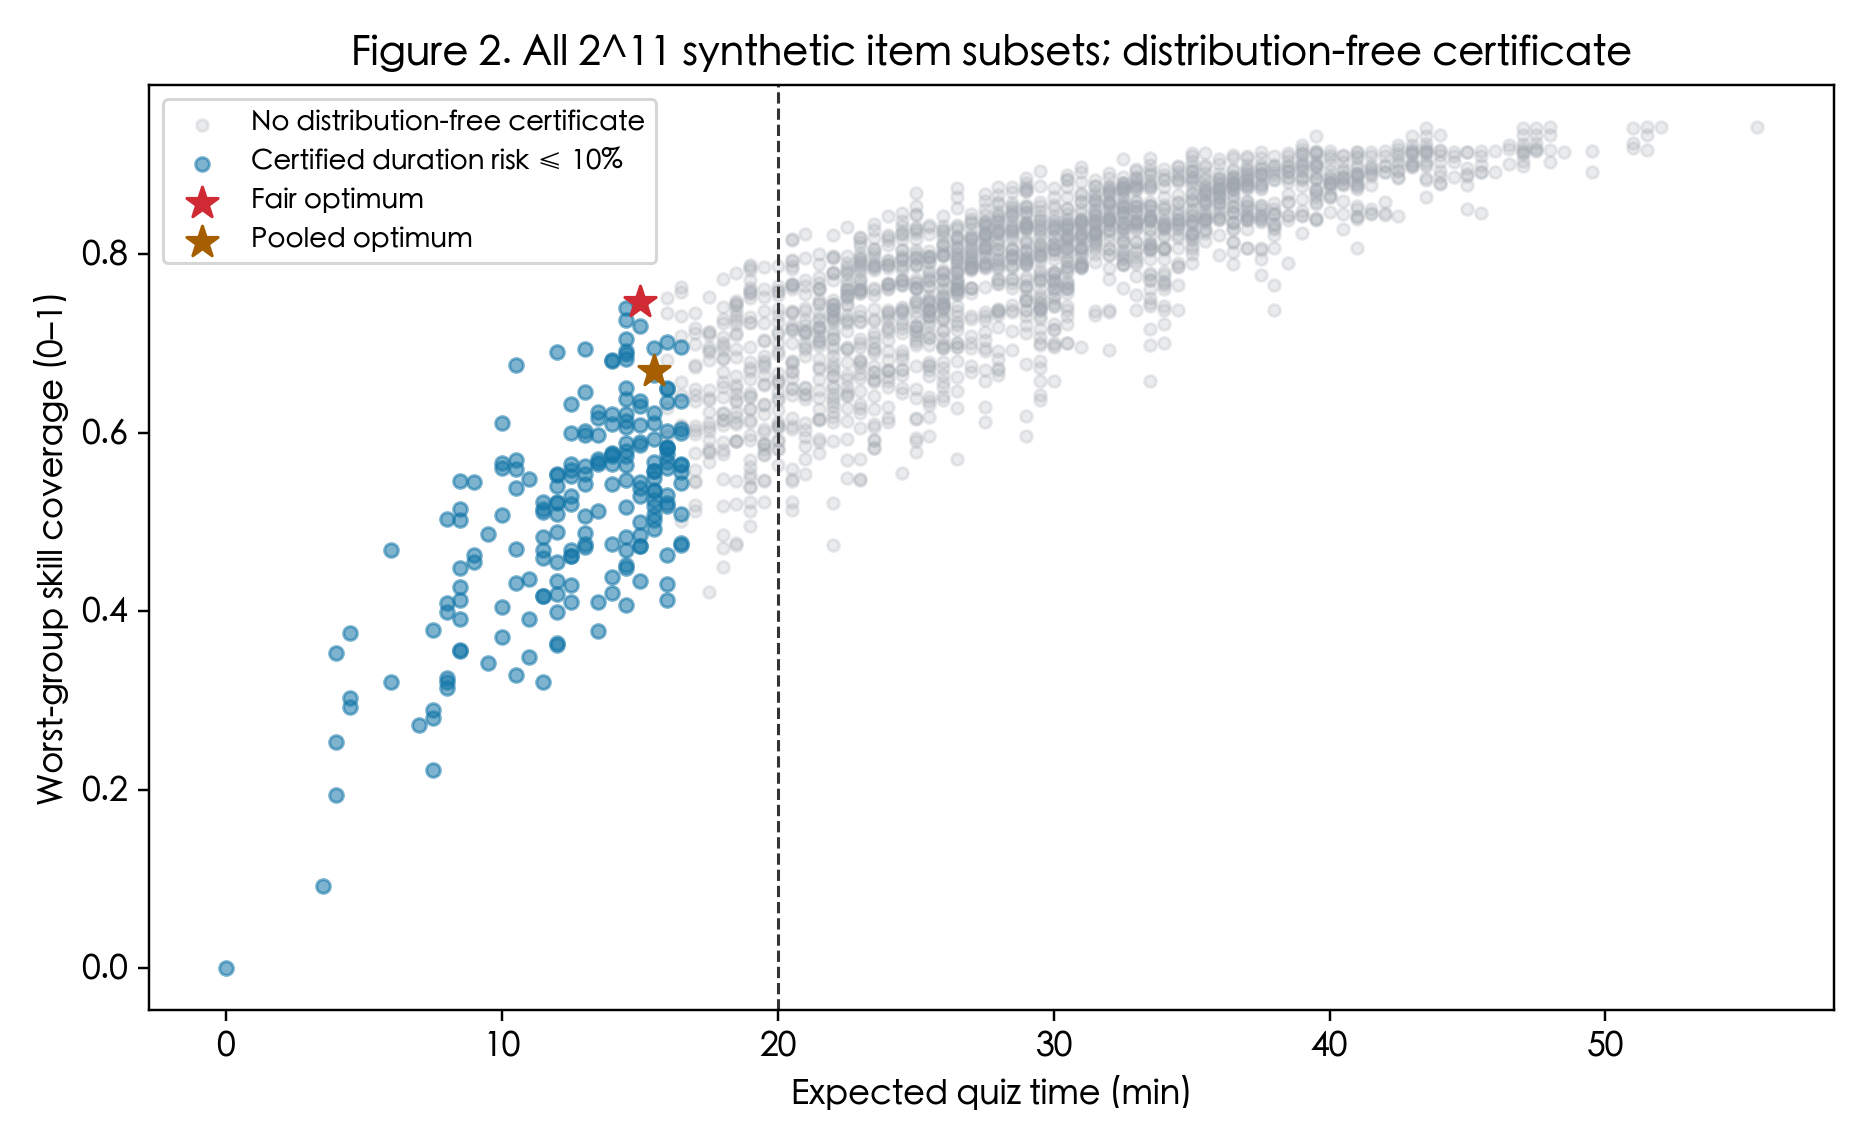
圖 2 2,048 個合成題組在「預期作答分鐘」及「最差輪廓技能覆蓋」平面的分佈;藍色表示通過 B=20、ε=0.10 的 Hoeffding 證書,灰色表示未獲該保守證書(不等於確定超時)。星號分別標示 P-F 及 P-A 最優解。圖由 code/analyse.py 自動生成;橫軸不是抽樣估計的考生作答時間。
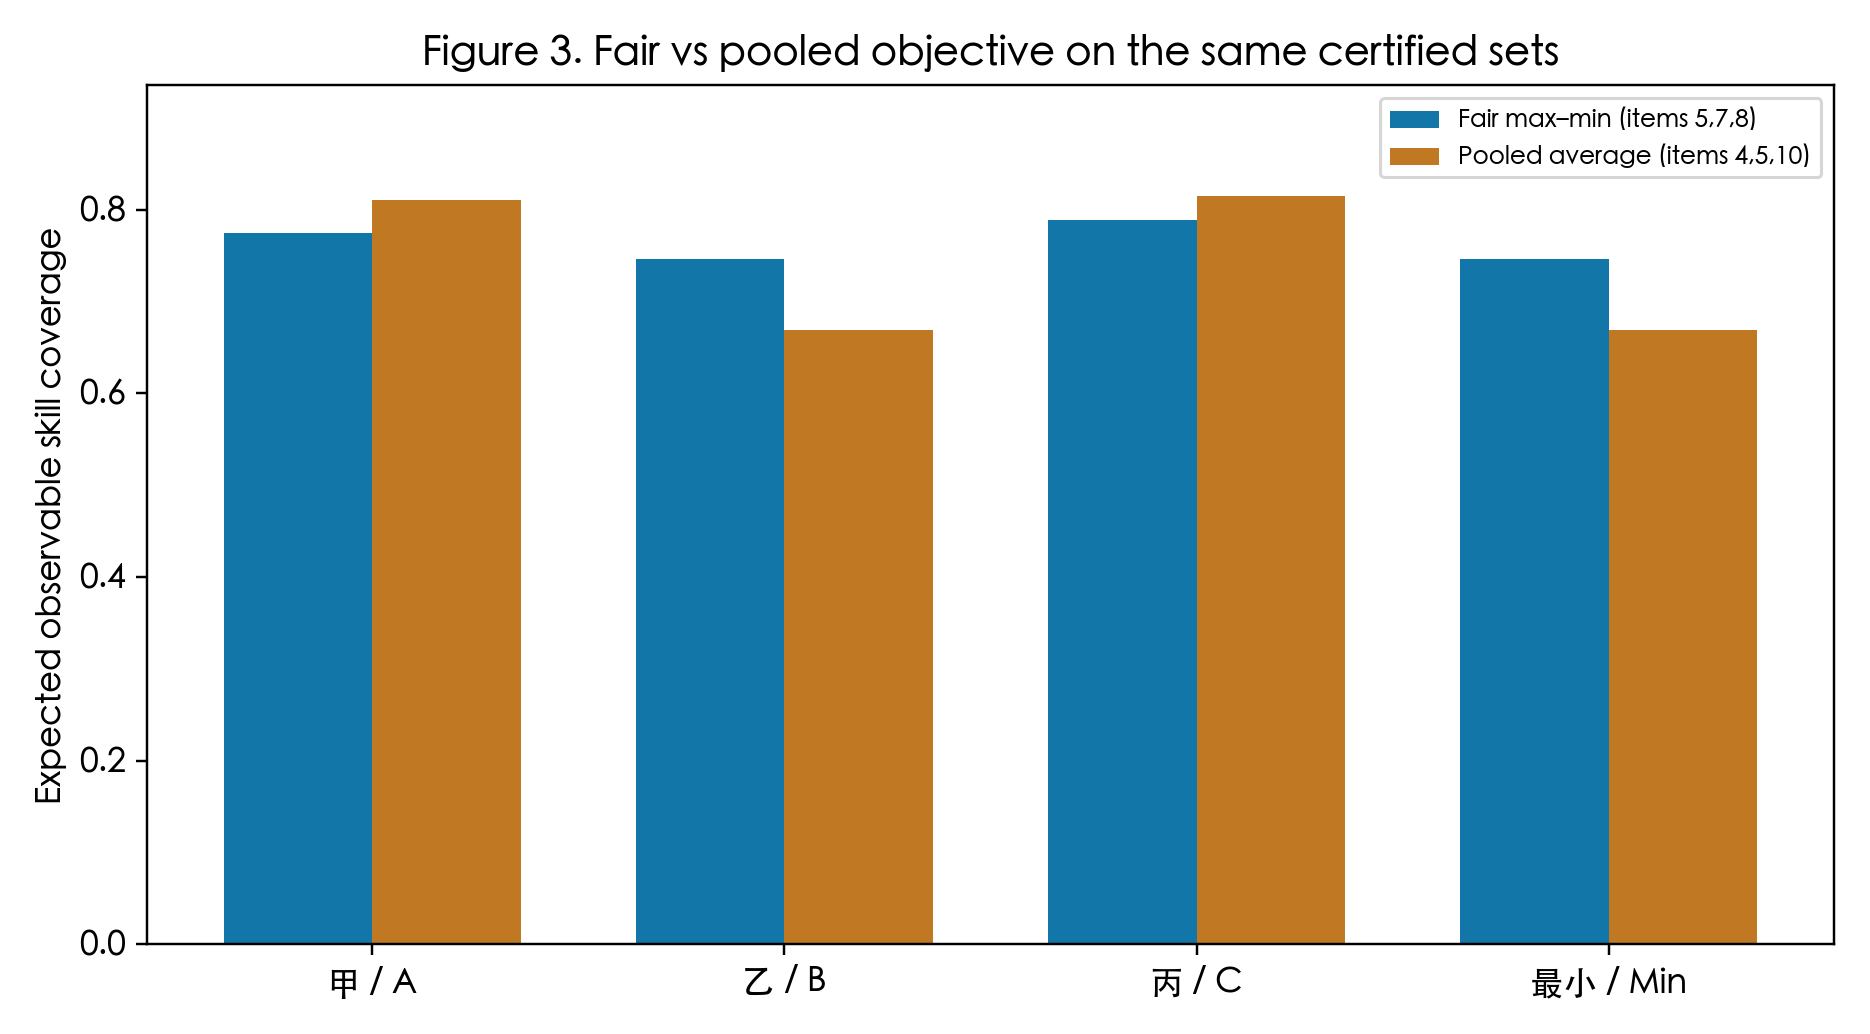
圖 3 同一保守可行集合下,P-F 與 P-A 最優選題的三個人工輪廓覆蓋及最小值比較。P-A 對甲、丙的示例覆蓋較高,而乙的覆蓋明顯較低;P-F 以部分加權平均換取最差輪廓的提升。圖沒有真實群組人口訊息,來源為合成模型之完全枚舉。
圖 2 與圖 3 同時顯示目標函數選擇的可觀察後果。圖中的「最差輪廓」只是人工參數集合內的 min;若需將它解釋為真實教育公平,必須先回答輪廓如何形成、是否可識別、權重是否有制度理據、以及覆蓋率是否符合適切的評核效度要求。
6.3 平均時長基線的風險反例
P-M 在平均時長 19 分鐘下選擇 {5,10,11},其 Hoeffding 上界要求的確保時長為約 23.726 分鐘,超出假設的 20 分鐘限制。這本身不能證明真實風險超標,因為證書僅為充分條件。為釐清此例的可行性,使用第 4 節額外規定的兩點式獨立時長分佈,對這三題共有 2³=8 個同概率時間結果逐一加總。在嚴格超過 20 分鐘的事件中,共有 2 個狀態,因此
計算用時長均值 (4.5,7.0,7.5)、半幅 (0.8,1.5,1.4),合計均值 19.0。此反例證明:只約束期望時長,不足以普遍保證風險要求。在這個特定分佈下,P-F 和 P-A 的精確超時概率都為零,說明分佈無關證書可能保守;即使概率為零,也僅對此人工設置的兩點分佈有效。
6.4 時限與可容忍風險的敏感度
為避免只報告單一設定,另以原始 2,048 個題組、同一成功率矩陣及相同時長均值與半幅,獨立計算 B∈{18,20,22} 分鐘、ε∈{0.05,0.10,0.20} 的九個組合。每組重新計算式(7)的可行集合,再重新最佳化 P-F 與 P-A。沒有重新抽樣,也沒有對各參數「估計」教育效果。
表 3 題組最佳化的時間風險敏感度(合成參數;全枚舉)
| B(分鐘) | ε | 通過證書題組數 | P-F 最優選題 | P-F 最低覆蓋 | P-A 最優選題 |
|---|---|---|---|---|---|
| 18 | 0.05 | 113 | 4、5、7 | 0.693901 | 8、10 |
| 18 | 0.10 | 123 | 4、5、7 | 0.693901 | 8、10 |
| 18 | 0.20 | 143 | 4、7、8 | 0.739590 | 8、10 |
| 20 | 0.05 | 174 | 5、7、8 | 0.746674 | 8、10 |
| 20 | 0.10 | 201 | 5、7、8 | 0.746674 | 4、5、10 |
| 20 | 0.20 | 222 | 5、8、9 | 0.757547 | 5、8、9 |
| 22 | 0.05 | 238 | 7、8、9 | 0.763172 | 5、8、9 |
| 22 | 0.10 | 274 | 7、8、9 | 0.763172 | 4、8、10 |
| 22 | 0.20 | 310 | 4、6、7、8 | 0.778940 | 7、8、10 |
對固定 B,容許的 ε 較大意味著 ln(1/ε) 較小,所以 C_ε(S) 不增,已通過證書的題組不會失去資格。對固定 ε,B 增大也只能擴大可行集合。從而兩者的可行題組數量及最優目標值必然單調不減;這是由式(7)直接得到的數學結論,而非從表 3 偶然觀察。惟選題的具體編號不具單調排列規律,也可能在某些參數門檻突然改變。表 3 的例子展示:從 (20,0.10) 到 (20,0.20),可行題組從 201 增至 222,P-F 的選題轉為 {5,8,9},且在此設定下 P-F 與 P-A 選題碰巧相同。故「兩目標必然衝突」同樣不是本文的定理。
6.5 可重現性與核驗覆蓋
主程式 code/analyse.py 產出 all_2048_subsets.csv、result_summary.json、hypothetical_item_pool.csv 和圖 1–3,並對邊際公式、單調性、相鄰集合的次模遞減邊際式、上下端點覆蓋次序、以及全部通過證書題組於兩點時間模型下的風險進行數值斷言。後者只是針對本例特定分佈的交叉檢查,不能把它解讀成對所有獨立有界分佈的電腦窮舉證明。
另以沒有匯入原程式函數的 code/independent_audit.py 只讀取存檔概率矩陣,獨立計算全部 2,048 組的三輪廓覆蓋(合共 6,144 個比較值)、加權覆蓋、最差覆蓋、時間證書及三個最優題組;與原輸出逐一比對,並產出 independent_audit.json 的九組敏感度記錄。此舉降低同一公式在呈文及主程式中被誤抄而未被發現的機會,但兩個實作均以同一組假設輸入為基礎,不屬外部資料驗證。
7. 討論
7.1 「技能機會」與「真實成就」的概念分辨
本文覆蓋 F_g 是「在固定題組內,模型至少一次可觀察到某技能達到指定 rubric 標準」的權重期望。它與學生已掌握該技能的機率、真實測驗分數、試卷鑑別度、題目信度、學習增益、或試題區分能力均非同一變數。即使在本模型下 F_g 較高,也不代表教學成效必然提高;對教育決策,教師應先判斷評分證據的可觀察性和抽題的內容效度是否成立。
先修圖與題目的評分環節須有實質對應。微分需要基礎代數,並不意味著一般微分題必然直接給代數步驟分。對真實題目,應由兩名或以上教師以事前規則編碼「可獨立觀察、可判分」的技能,報告一致性,處理分歧,再由實際 rubric 建立 Rᵢ。若只是從課綱列出所有前置知識後直接套入式(1),就會人為擴大技能覆蓋,造成虛假的可觀察性。
7.2 最差輪廓目標的規範性,而非自動公平證明
P-F 具清楚的數學政策解釋:在指定輪廓集合內,盡量避免任何一組覆蓋機會過低。P-A 則將額外權重給甲,實驗設為 π_甲=0.7。兩者只是不同的效用聚合方式,沒有證據允許把 P-F 等同於教育公平的充分定義。例如,若某真實輪廓分群方法本身排除一類學生,P-F 仍可能對未納入者不利;若某些技能是公開課程的核心最低要求,僅靠平均技能權重亦可能掩蓋特定技能的缺口。
式(12)提供較可解釋的替代提問:能否在給定分鐘數與風險上限下,讓每個預先界定的輪廓均至少取得 τ 的預期可觀察技能覆蓋?這一「是否同時達標」的問題適合與教師及評核人員討論,並能和定理 2 的截頂飽和函數連接。惟可行 τ 的選定仍須根據評核目的,而不能由演算法自行產生正當性。
7.3 與既有研究的實質關係
van der Linden(2005)已研究有內容約束的自適應題目選取;van der Linden 等(1999)曾把作答時間預測加入組卷限制;Spaccapanico Proietti 等(2024)以不確定試題參數構造機會約束自動組卷;Krause 等(2008)則建立穩健次模觀測選取及飽和策略。本文的時間不等式直接來自 Hoeffding(1963),基數近似思想來自 Nemhauser 等(1978),技能先修架構有 Leighton 等(2004)和 Tu 等(2019)的認知診斷先例。故任何把「次模」、「群組最小值」、「機會約束」或「先修圖」單獨稱為本研究首創的敘述都不成立。
本文目前可檢驗的附加價值是:將明示 rubric 可觀察技能、輪廓逐坐標概率下界、可由分佈條件支持的時長上尾證書連接成單一、能完全核算的 M2 校本假設模型;對該模型給出直接推導、可行性等價條件與反例,且公開所有 2,048 個配置的數值。與既有研究的差別主要在具體問題設定、技術透明度及教學詮釋;是否足以構成學界認可的新理論,現階段不能下結論。投稿時尤其需要進一步排查是否已有完全同型的機率覆蓋與風險配方。
7.4 時長風險證書的實際適用前提
證書(7)的便利在於只需均值和有界範圍即可逐組核算,毋須事先選定常態或對數常態分佈。不過它要求各題時長獨立,而真實學生有共享的作答速度、時間管理與認知負荷,往往令題目時長相關。若考生跳過長題、在時限下更改作答策略,甚至因先前題目的難度影響後題速度,B4–B5 就可能失效。真實課室部署時,應優先蒐集合乎倫理的匿名逐題作答時長,再根據資料選擇依賴模型或更保守的相關時長界。
兩點式模型說明保守證書可以未用盡全部允許的風險,但不表示應任意放寬時限。對已知分佈,可用其實際上尾或 Monte Carlo 誤差控制來規劃;對估計不確定的分佈,仍需將參數估計誤差包含在研究設計中。本文沒有估計 dᵢ,亦沒有估計作答速度異質性,因此研究中 0%、25% 的概率只可用於演示某一數學分佈下的風險差別。
7.5 下一階段研究與可檢驗假設
可設一項真實校本預註冊驗證:以香港高中 M2 具實際評分規準的題庫,由多位教師獨立標註 Rᵢ,量度標註一致性;以獨立校準樣本估計題目 × 技能成功率及逐題時間分佈;然後對保留測試樣本比較 P-F、P-A、P-M 在「最低事先界定輪廓覆蓋」及「實際超時比例」的表現。應預先指定如何形成輪廓,避免利用測試結果回頭調整輪廓。對於風險是否不超過 10%,需報告樣本不確定性及適當的比例信賴區間;對覆蓋差別則需報告置信區間、群組樣本量與測量效度。這些是未來實證研究方案,並非本文已完成的測試。
8. 研究限制
首先,全部題目與輪廓均是構造參數,成功率缺少實際校準,未涵蓋年級、學校、語言或真正能力群組的分布;因此本文外部效度尚未建立。刻意設置 a_{甲,11}=0.45、a_{乙,10}=0.50 有助製造可辨別的目標衝突,但亦意味著 0.077777 的差異不具有估計真實香港學生學習差距的意義。任何把此數當作學校政策效果量的做法均不恰當。
其次,式(2)對固定輪廓與技能假設跨題獨立;實際同一學生作答具有穩定能力及共同環境,故跨題成功事件可能顯著相關。式(20)把題目相容度乘到所有可觀察技能上,忽略技能之間的認知依賴及題目局部依賴;這只是便於透明展示的生成機制。對概率不確定集,採用完全長方形的笛卡兒積允許所有下界同時出現,或比真實校準所得的聯合可行集寬鬆;「對最差端點穩健」不能等同有頻率學意義的校準信心保證。
第三,圖 1 的先修圖及式(1)的可觀察祖先假設沒有經專家共識或評分者驗證,對 M2 不同單元、難度及題目類型的涵蓋亦有限。模型只最大化至少一次可觀察成功,可能鼓勵同技能重複題型;沒有明文限制實際考核中必需的題型多樣性、難度平衡、題目安全、成績鑑別度、試卷整體效度或對個別學生的題型可近用性。
第四,時間假設 B4–B5 特別強:獨立時長、確定均值、已知有界幅度、所有選題均會作答。現實中的時間分布可能有長尾、受人為選題順序影響,或受同一學生的作答速度因素共同驅動。在這些情形下,Hoeffding 保證未必適用。即使 B4 成立,式(7)仍是充分條件而非必要條件,可排除真實上尾已合乎 ε 的題組。
第五,選題結果依賴七技能等權重、三輪廓的合成設置、π=(0.7,0.2,0.1) 及 B、ε 的決策設定。表 3 只對 B、ε 變動做敏感度測試,尚未對完整概率矩陣、技能權重、先修圖誤標或時長相關係數做穩健性區間掃描。對正式建議應測試更廣的變化並估計參數不確定性;有限格點的驗證不能外推至所有可能題庫。
最後,本文完成的是作者主導的數學與程式核查,以及內部模擬評審,尚沒有獨立的外部同行評審、真實樣本驗證或全面系統性文獻回顧。既有最佳化與測量文獻廣泛,尚不能聲稱本文的新配方從未被提出過。作為研究工作論文,這一標籤會一直保留至上述必要證據到位。
9. 結論
本文建立一個可重現的香港高中數學延伸部分單元二假設校本短測組卷模型:以先修圖界定可評分技能的建模情境,以「至少一次成功可觀察」的機率覆蓋聚合技能機會,以長方形概率下界表示穩健性,並以獨立、有界時長之 Hoeffding 充分條件約束超時風險。在明列假設下,證明單輪廓覆蓋次模性、截頂群組達標等價性、題目替換的支配條件與問題的 Set Cover 困難度;同時指出最差輪廓點態最小值一般不保留次模性。
在 11 題、7 技能、3 種虛構輪廓的 2,048 組完全枚舉中,有 201 組符合 B=20、ε=0.10 的保守時長證書。最差輪廓與加權平均兩種政策目標會在指定參數下選出不同題組;平均時長合格的組合則可以在明示的兩點式時間模型下有 25% 超時概率。獨立實作確認所有有限配置、原結果及九組時限風險敏感度結果。這些結論均是指定模型條件下的理論或合成數值結論。
其教育意義在於提供一套可審核的決策表述,讓教師清楚討論「哪些技能真正給分」、「如何衡量不同預設輪廓」、「願意承受多少時間風險」以及「所報告的保證依賴甚麼假設」。要由研究工作論文進一步成為可用的香港校本評核工具,仍須進行真實 rubric 編碼、概率與時長校準、獨立外部審核、教育公平與效度評估,以及更多專項文獻比對。
參考文獻
教育局。(2017)。《數學教育學習領域課程指引(小一至中六)》及高中數學科學習內容補充文件。香港特別行政區政府。https://www.edb.gov.hk/tc/curriculum-development/kla/ma/curr/index2.html
香港考試及評核局。(2026)。2026 HKDSE Mathematics assessment framework [評核大綱]。https://www.hkeaa.edu.hk/DocLibrary/HKDSE/Subject_Information/math/2026hkdse-e-math.pdf
Hoeffding, W. (1963). Probability inequalities for sums of bounded random variables. Journal of the American Statistical Association, 58(301), 13–30. https://doi.org/10.1080/01621459.1963.10500830
Krause, A., McMahan, H. B., Guestrin, C., & Gupta, A. (2008). Robust submodular observation selection. Journal of Machine Learning Research, 9, 2761–2801. https://www.jmlr.org/papers/v9/krause08b.html
Leighton, J. P., Gierl, M. J., & Hunka, S. M. (2004). The attribute hierarchy method for cognitive assessment: A variation on Tatsuoka's rule-space approach. Journal of Educational Measurement, 41(3), 205–237. https://doi.org/10.1111/j.1745-3984.2004.tb01163.x
Nemhauser, G. L., Wolsey, L. A., & Fisher, M. L. (1978). An analysis of approximations for maximizing submodular set functions— I. Mathematical Programming, 14(1), 265–294. https://doi.org/10.1007/BF01588971
Spaccapanico Proietti, G., Matteucci, M., Mignani, S., & Veldkamp, B. P. (2024). Chance-constrained automated test assembly. Journal of Educational and Behavioral Statistics, 49(1), 92–120. https://doi.org/10.3102/10769986231169039
Tu, D., Wang, S., Cai, Y., Douglas, J., & Chang, H.-H. (2019). Cognitive diagnostic models with attribute hierarchies: Model estimation with a restricted Q-matrix design. Applied Psychological Measurement, 43(4), 255–271. https://doi.org/10.1177/0146621618765721
van der Linden, W. J. (2005). A comparison of item-selection methods for adaptive tests with content constraints. Journal of Educational Measurement, 42(3), 283–302. https://doi.org/10.1111/j.1745-3984.2005.00015.x
van der Linden, W. J., Scrams, D. J., & Schnipke, D. L. (1999). Using response-time constraints to control for differential speededness in computerized adaptive testing. Applied Psychological Measurement, 23(3), 195–210. https://doi.org/10.1177/01466219922031329
Wolsey, L. A. (1982). An analysis of the greedy algorithm for the submodular set covering problem. Combinatorica, 2(4), 385–393. https://doi.org/10.1007/BF02579435