摘要
香港中學文憑試數學科要求考生以合適的數學技巧解題、運用符號並以數學方式表達論據。對涉及多個前後相依步驟的題目,錯誤若出現在較早階段,可能影響其後的計算結果或判分。本文把「每一步的方法是否正確」與「從題首至該步是否全部正確」區分為兩種不同的可觀察判分事件,建立可調節的局部—鏈式混合計分模型。研究在明確的獨立伯努利假設下,推導期望分數、完整的分數方差、各步驟成功機率的偏導數,以及評分位置敏感度的解析式。對等權線性解題鏈,本文證明:只要鏈式依賴仍在評分中佔正比重,較早步驟的邊際影響必然嚴格大於較後步驟;這一差距不能透過對所有步驟採用相同正權重而消除。本文進一步求出,在指定成功機率區間及位置差距上限下,局部給分比例的最小可行閉式解,並將結果推廣至任意有限有向無環先修圖。六步題的完全枚舉計算(共 64 種假設成功/失敗模式)與所有解析結果一致。當各步成功機率為 0.70、總分六分時,純鏈式與純局部方式的期望分別為 2.058819 及 4.200000;若要求在 p ≤ 0.90 時首末步驟的邊際敏感度差不超過 1,模型給出的最小局部比例約為 0.755806。這些結果揭示評分依賴結構可能造成的位置放大效應,但並不直接證明任何現行考試存在不公平。模型供學校設計、審視與預試數學評分規準之用;後續仍須蒐集實際答卷並驗證模型假設。
關鍵詞: 香港中學文憑試;數學教育;多步解題;部分給分;位置敏感度;先修依賴圖;評核效度;數學建模
Abstract
Constructed-response mathematics items often involve a sequence of dependent operations. An error in an early operation can affect later numerical answers even when the later methods are meaningful. This working paper distinguishes local methodological correctness from correctness of the complete prerequisite chain and defines a mixed scoring rule interpolating between the two. Under explicitly stated independent Bernoulli assumptions, we derive the score expectation, variance, positional derivatives, and a closed-form robust constraint for limiting the sensitivity gap between early and late steps. For equally weighted linear chains, any positive dependence on cumulative correctness generates a strictly greater marginal score sensitivity for an earlier step than for the next one. We extend the sensitivity representation to arbitrary finite prerequisite directed acyclic graphs and examine boundary and counterexample cases. An exhaustive enumeration of 64 hypothetical success patterns for a six-step item reproduces the formulas. At step-success probability 0.70, the expected scores under pure cumulative and pure local scoring are 2.058819 and 4.200000, respectively. A sensitivity tolerance of one point for every p in [0, 0.90] requires a minimum local component of approximately 0.755806. The proposed measure describes structural amplification rather than educational fairness or the marking practice of the Hong Kong Examinations and Assessment Authority. Empirical calibration, rubric reliability, and the feasibility of awarding local credit remain future tasks.
Keywords: Hong Kong Diploma of Secondary Education; mathematics assessment; partial credit; multistep problem solving; positional sensitivity; prerequisite graph; scoring rubric; mathematical modelling
1. 引言
1.1 香港數學教育的問題背景
香港教育局於《數學教育學習領域課程指引》(2017)及高中數學科補充課程文件中,將數學概念、知識、解題能力和數學溝通置於課程架構之中。香港考試及評核局的《2026 年香港中學文憑考試數學科評核大綱》亦列明,必修部分旨在評核考生對數學概念、原理、符號的掌握,以及運用數學技巧解題與表達論據的能力;延伸部分則包括單元一「微積分與統計」及單元二「代數與微積分」(教育局,2017;考評局,2026)。因此,一份數學作答可同時包含「選擇概念」、「執行計算」與「解釋結果」等不同認知成分。
設想一題教學示例:學生先求函數導數,再找出駐點,最後利用導數符號判斷極值。假如第一步的導數算錯,後續運算可能在錯誤輸入下保持邏輯一致。若評分規準只承認由始至終完全正確的運算鏈,第二、三步將可能因第一步的錯誤而同時失分;若評分規準容許獨立核對每步的方法,後續步驟則可能仍能獲得相應方法分。這是兩種研究上的抽象評分制度,不是對香港考評局實際評分指引的描述。
學生之間的差異可能表現在何處?一名考生可能理解較後的解法,卻在前面的代數運算出錯;另一名考生則可能在早期運算正確,但缺乏後續解釋能力。將全程完全正確視作唯一成功事件,會隱去這種差別。相反,完全獨立的步驟給分又可能忽略「正確完成整個推導」這個重要評核目標。研究的核心問題因而是:在兩者之間,評分位置及評分依賴究竟如何改變每一步成功機率對期望總分的影響?
1.2 研究目的與問題
本文處理四個精確問題:
- 對一條前後相依的數學解題鏈,局部判分、鏈式判分及其混合形式的期望與變異數為何?
- 在各步成功機率相等、各步權重相等時,最前與最後步驟的邊際分數敏感度有何精確關係?
- 假設學校願意保留一定程度的鏈式評分,又希望在指定機率範圍內控制位置差距,能否求出最小局部給分比例?
- 當解題結構由線性步驟變成多條支線匯聚的先修關係時,上述量度如何推廣?
本文以可證明的數學關係為主要成果。所稱「位置敏感度」指給定統計模型中,某一步的成功機率增加一個單位時,期望分數的局部變化率。它不是考生能力、題目難度、公平性或考試信度的同義詞;尤其不能從位置敏感度較大,直接推論該評分規準不合理。
1.3 本文的貢獻邊界
已有研究涵蓋部分給分的心理測量模型、階層式技能認知診斷,以及教師實際判分差異(Masters, 1982;Leighton et al., 2004;Moons & van Schendel, 2026)。本文不聲稱首創部分給分、先修圖或混合權重概念。本文的工作是針對「局部成功與累積成功」這一組明確的事件,推導可審核的位置放大公式、權重條件、穩健設計門檻,並提供對任何有限先修圖適用的導數表達。這是一組特定模型下的理論命題,能否構成足以投稿的新增學術貢獻,仍須更完整的系統性文獻比對及外部評審。
2. 文獻綜述
2.1 部分給分與測量模型
Masters(1982)提出的 Rasch 部分給分模型處理有序類別作答,重點在潛在能力與各得分類別之間的機率關係。該研究提供了使用多於「對/錯」兩類分數的測量基礎,但本文關注的不是估計潛在能力,也不假定部分得分遵守 Rasch 的結構。本文直接從作答步驟的成功事件開始,研究評分規準對分數的代數及機率影響,研究層次有所不同。
May 等人(2023)在六年級數學問題解決評核中比較二元與部分給分,發現兩種方法在該研究樣本的部分心理測量分析及學生結果上可得相近表現。這提醒我們:某種評分結構在理論上具有不同位置敏感度,不代表它必然導致可觀的實證等級差異。本文對分數期望及方差的推導亦不能取代效度研究。
Moons 與 van Schendel(2026)分析中學數學教師對代數試卷的評分決策,發現教師在給分方式與內容重點上有差異,而研究中教師之間的變異對最終分數的貢獻相對有限。該結果表明,除了理論評分規則,還需觀察閱卷者在具體答卷中的操作及一致性。本文沒有收集教師的實際判分紀錄,僅能提出可供將來評分研究檢驗的結構假設。
2.2 技能階層及認知診斷
Leighton、Gierl 與 Hunka(2004)的 Attribute Hierarchy Method(AHM)將認知技能之間的先修結構納入評核推理。Gierl、Alves 與 Taylor Majeau(2010)進一步於小學數學診斷情境應用技能階層;Tu 等人(2019)則研究在限制 Q-matrix 設計下,認知診斷模型如何利用技能階層改善分類。這些研究證明,先修結構是既有而且重要的測量概念。
然而,「學生是否掌握某項潛在技能」、「答卷中某一步方法是否正確」、「其前置步驟是否全部正確」是三種不同變量。AHM 或 CDM 的技能階層不等同本文的作答依賴評分鏈。在模型層次,前者主要處理潛在屬性與作答模式;後者處理給定局部作答狀態下的分數變換。本文從既有先修圖的數學概念出發,另外研究節點在評分函數中的邊際影響。
2.3 香港研究與研究缺口
梁子傑(2014)曾討論香港文憑試數學科分卷分數的加權與轉換,並指出不同分數處理方法可能改變考生的相對結果。其研究著眼於卷別分數轉換,不是單一道多步題的局部判分與依賴關係,故與本文沒有直接重複。然而,該文亦提示評分程序的數學細節需要清晰公開及可核查。本文不沿用該文根據 2013 年樣本作出的現行制度推論。
綜合上述文獻,已存在部分給分、技能階層和教師評分研究。本文辨認的是一個界定較窄的分析空間:在指定混合評分函數之下,位置導數是否必然有序、差距的最壞情形在哪裏、學校能否透過單一參數作量化約束。搜尋不到完全相同公式,不能證明無人研究;故本文僅主張在當前列明的檢索範圍內,尚未找到對同一模型與同一閉式門檻的直接陳述。
3. 理論框架:兩種「正確」與混合給分
3.1 模型及符號
設一道題被事先拆成 m 個按次序排列的可判別步驟,m 為正整數。令
- Xᵢ ∈ {0, 1}:第 i 步是否具備可判定的局部方法正確性;即使前一步答錯,也可能在明確的「承接所得中間值」規則下被評為正確。
- pᵢ = P(Xᵢ = 1):第 i 步局部正確的機率,假設 0 ≤ pᵢ ≤ 1。
- Yᵢ = ∏ⱼ₌₁ⁱ Xⱼ:由第 1 步至第 i 步是否全部局部正確。
- qᵢ = E(Yᵢ) = ∏ⱼ₌₁ⁱ pⱼ:在獨立假設下由始至第 i 步全對的機率。
- wᵢ > 0:預先指定第 i 步在總分中的權重。
- α ∈ [0, 1]:局部給分比例,1−α 則為鏈式給分比例。
核心假設 A1:在模型指定的學生群體或能力條件下,X₁,…,Xₘ 相互獨立。假設 A2:每一步具有可獨立核對的局部正確性,並且有合理的承接錯誤判準。假設 A3:評分權重事先固定,沒有閱卷者差異或部分分數取整。A1–A3 均是研究簡化條件,並非香港考生或任何現行評分機制的已證實特徵。
定義本研究的混合評分函數:
純鏈式分數記為 L = Σ wᵢYᵢ,純局部分數記為 K = Σ wᵢXᵢ,於是 T(α) = αK + (1−α)L。由於每一個樣本狀態都有 Yᵢ ≤ Xᵢ,必定有 0 ≤ L ≤ T(α) ≤ K ≤ W,其中 W = Σwᵢ。此為逐個作答狀態成立的確定性關係,並非僅對平均分數成立。
註: α = 0 時「前一步出錯、後一步即使方法獨立正確也失去鏈式分數」是一個刻意設立的極端模型;α = 1 時「每一步完全獨立給分」亦是理論極端。真實學校規準可以採用其他機制,包括概念分/方法分/答案分或按題設限制的承接分。不能只靠 α 擬合所有實際判分。
3.2 評分位置與因果解讀
把 pᵢ 當作形式上可以單獨改變的模型參數,不等於宣稱教師可以只改善某一步而不影響其他步。本文的「敏感度」是數學上的偏導數 ∂E(T(α))/∂pᵢ,表示其餘機率參數維持不變的局部效應。若真實學生不同步驟的表現互相關聯,或掌握第一步自然帶動第二步,該偏導數便不能直接解讀為教育介入的因果效果。
4. 研究方法
本研究採用三層分析。第一層是在獨立伯努利模型中直接計算期望、二階矩與各步機率偏導數,建立無需個別考生資料的解析命題。第二層把參數縮減為等機率 p、等權 w 的線性鏈,研究位置敏感度是否必然嚴格遞減,並求其最大差距的閉式門檻。第三層以具任意先修關係的有限有向無環圖(DAG)表示結構,推導節點敏感度。
數值部分以 m=6、p=0.70 的假設情境為示例。程式完整列舉 2⁶ = 64 種成功/失敗向量,按其理論機率加權,與解析期望和方差比對;再使用中心差分核對位置導數。另以邊界 p=0 和 1、多種題目長度與一個分支先修圖檢查公式。完整源碼、結果 JSON/CSV 與繪圖檔放在本研究資料夾。完全枚舉在所選參數範圍可核對代數實作,卻不構成一般性證明;所有一般性結論以下列推導為準。
5. 數學推導與分析
5.1 命題一:期望分數及逐樣本界限
命題 1(混合評分的期望)。 在 A1–A3 下,
對每組可行參數,有 E(L) ≤ μ(α) ≤ E(K)。當 α 上升時,μ(α) 單調不減;如存在 i ≥ 2 使 wᵢ > 0、pᵢ > 0,且該步之前至少一個 pⱼ < 1,則 μ(α) 對 α 嚴格遞增。
證明。 E(Xᵢ)=pᵢ;由獨立性,E(Yᵢ)=E(∏ⱼ≤ᵢXⱼ)=∏ⱼ≤ᵢpⱼ。對式(1)使用期望線性性得式(2)。又 Yᵢ 是 Xᵢ 及前面二元變量的乘積,故逐個狀態 Yᵢ≤Xᵢ。最後,
若所列條件成立,某個 pᵢ−qᵢ > 0,因此導數嚴格為正。證畢。
式(3)說明改變給分方式亦會改變平均原始分數;因此不能在未作分數尺度轉換及實證校準前,直接比較兩套規準所給的分數大小。
5.2 定理一:任意不等機率鏈的位置導數
定理 1(位置敏感度公式)。 在 A1–A3 下,把其餘 pⱼ 固定,則
證明。 從式(2)直接微分。局部項 αΣwᵢpᵢ 對 pⱼ 的偏導只留下 αwⱼ;鏈式乘積 qᵢ 若 i<j,不含 pⱼ,偏導為零;若 i≥j,其偏導為刪去 pⱼ 的其餘因子乘積。由乘積求導法則立即得到式(4)。在 pⱼ=0 邊界處,式(4)按多項式延拓或單側導數理解,故毋須使用可能除以零的 qᵢ/pⱼ 寫法。證畢。
式(4)將局部回報 αwⱼ 與一項所有下游步驟的累積貢獻分開。若 j 早,便可能影響更多累積事件;但若各步權重不同,位置排序不一定只由 j 決定。因此不能脫離權重條件說「先做的步驟一定更重要」。
5.3 定理二:等權鏈的嚴格位置放大
定理 2(不可在保留鏈式比重下完全消除差距)。 設 w₁=⋯=wₘ=w>0、p₁=⋯=pₘ=p,且 0<p≤1,則在各 pⱼ 的偏導數均於這組等機率參數取值時,
因此任意 1≤j<m,
當 m≥2、α<1 時,D₁>D₂>⋯>Dₘ;如 α=1,所有位置敏感度均等於 w。
證明。 將等機率等權條件代入式(4)。由於每個包含 pⱼ 的長度 i 乘積,對該參數微分後皆餘下 i−1 個 p 因子,故為 pⁱ⁻¹,得到式(5)。從 Dⱼ 減去 Dⱼ₊₁ 時,兩條求和式所有 i≥j+1 的項相消,只餘 (1−α)wpʲ⁻¹。當 00、α<1,該數嚴格為正;α=1 時為零。證畢。
推論 2.1(純鏈式等權限制)。 在 α=0、0<p≤1、m≥2 的模型內,無法令所有步驟的邊際敏感度相等。這只是等正權、鏈式評分、獨立概率模型內的結果;對不同權重或不同依賴結構不作同樣斷言。
反例(必須註明的限制)。 若 m=2、α=1、w₁=0.1、w₂=10,則 D₁=0.1 而 D₂=10,後一步反而較敏感;故取消等權條件後,定理的遞減排序不成立。另外,當 p=0 時,中間及末段的 pʲ⁻¹ 可以為零,嚴格遞減亦不保證。這些例子防止將定理誇大為無條件的評分法則。
5.4 定理三:首尾差距與穩健混合係數
定義首尾位置差距:
這是「當第一步或最後一步的成功機率各自增加同樣微小量」對期望分數所造成的邊際變化差,單位是「分數/機率」,不應誤讀為兩名真實考生的實際分差。
定理 3(控制首尾差距的最小局部給分比例)。 設 m≥2、w>0,且學校指定機率範圍 p∈[p₋,p₊]⊆[0,1] 及容忍差距 δ≥0。令
要求對所有 p∈[p₋,p₊] 都有 Gₘ(p,α,w)≤δ,其充要條件為
當 δ≥0,α* 必落在 [0,1];它是在滿足條件的同時保留最多鏈式比重的可行選擇。
證明。 對 0≤p≤1,Hₘ(p)=Σᵣ₌₀ᵐ⁻²pʳ 單調不減,因為每一項非負且不減;即使 m=2 時 H₂(p)=1 為常數,結論仍成立。故 Gₘ 在指定區間的上確界出現在 p₊,最大值是 (1−α)wHₘ(p₊)。不等式 (1−α)wHₘ(p₊)≤δ 等價於 α≥1−δ/[wHₘ(p₊)];再加入 α≥0 的模型限制,即得式(9)。所有 α≤1 可行;在可行集合內最小的 α 對應最大的 1−α。證畢。
推論 3.1。 當 δ=0 時,必須 α*=1,才可能在整個 p 區間完全消除首尾位置差距。當 δ≥wHₘ(p₊) 時,純鏈式 α=0 已滿足指定上限。當 p₊=1,Hₘ(1)=m−1;當 0≤p₊<1,Hₘ(p₊)=[1−(p₊)ᵐ⁻¹]/(1−p₊)。因此題目愈長,純鏈式制度可能累積愈大的首尾差距,但其增長須連同 p 與評核目標一起解讀。
設計上的注意。 δ 是研究者或評核者事先提出的規範性容忍值,不能由本理論自行定為「合理」或「公平」。即使 α* 能滿足數學限制,也未證明該給分方法具有教學可操作性或良好心理測量效度。
5.5 命題二:等機率模型的完整方差
在等權 w=1、等機率 p 的線性鏈中,定義 K=ΣᵢXᵢ 及 L=ΣᵢYᵢ,兩者不是獨立的。K 是局部成功步數,L 是從題首開始連續正確的步數。後者的機率分佈為
前一式說明最先 k 步正確、下一步錯誤;最後一式是全題沒有錯誤。相對地,K∼Binomial(m,p)。由分佈及指標和可得
命題 2(混合分數方差)。
證明。 L=ΣYᵢ,且對任意 i、j,YᵢYⱼ=Yₘₐₓ₍ᵢ,ⱼ₎,故 E(L²)=ΣᵢΣⱼpᵐᵃˣ⁽ⁱ,ʲ⁾。將 max(i,j)=k 的有序數對數目計為 2k−1,即得式(11)。此外,Xⱼ與Yᵢ在 j>i 時獨立,故 Cov(Xⱼ,Yᵢ)=0;在 j≤i 時,XⱼYᵢ=Yᵢ,故 Cov(Xⱼ,Yᵢ)=pⁱ−ppⁱ=(1−p)pⁱ。對 j≤i 求和有 i 個相同項,得式(12)。最後從 T(α)=αK+(1−α)L 套用方差展開式,得到式(13)。證畢。
式(13)指出不能把局部與鏈式部分當成兩個獨立得分相加。即使本示例中 α 增加時方差下降,也不代表任意題目、任意權重及機率結構均有此趨勢,更不能直接把「方差下降」解讀為「考試信度提升」。
5.6 命題三:先修有向無環圖上的一般化
部分數學問題會有兩個平行計算分支,然後合併作最後判斷。以有限 DAG G=(V,E) 表示「u→v」代表步驟 u 是 v 的直接先修環節。對每個節點 i,令 Aᵢ⊆V 是 i 及其全部祖先節點的集合(包含 i),定義 Yᵢ=∏ₖ∈Aᵢ Xₖ。此時鏈式分數改為 L_G=ΣᵢwᵢYᵢ,混合分數 T(α,G)=αΣᵢwᵢXᵢ+(1−α)L_G。
命題 3(DAG 節點敏感度)。 在相互獨立的 X 條件下,
證明。 每個鏈式得分事件 Yᵢ 所包含的節點由先修閉包 Aᵢ 決定。對 E(Yᵢ)=∏ₖ∈Aᵢpₖ 逐項求 pⱼ 偏導:如 j∉Aᵢ,結果為零;如 j∈Aᵢ,留下其他節點的成功機率乘積。再加上局部項 αwⱼ,便得式(14)。證畢。
此式亦可將右方解讀為「節點 j 的自身局部權重」加上「所有依賴 j 的後代計分項之加權總和」。它是依據給分規則定義的評分影響力,不是已證實的學生能力因果影響。
分支例子。 設 1→3←2、3→4,全部 wᵢ=1 且 pᵢ=0.7,純鏈式 α=0。由 A₁={1}、A₂={2}、A₃={1,2,3}、A₄={1,2,3,4},式(14)給出四個節點的敏感度:
它展示同一題內可能出現兩個平行高影響先修節點。因此,若只以題面步驟排列先後來評價評分位置,將錯過重要的依賴結構。
5.7 反例與評分名次交叉
模型的另一項可驗證特徵,是改變 α 可能改變兩名考生的原始分數排序。設三步題,權重相同。假設答卷 A 的局部狀態為 (0,1,1),答卷 B 為 (1,0,0)。由定義,A 的 (K,L)=(2,0),B 的 (K,L)=(1,1)。因此
當 α<0.5,B 較高;當 α>0.5,A 較高;α=0.5 時相同。這說明兩種評分構念可以產生不同排序,而非證明其中一種較公正。狀態 A 是否在真實答卷中可合理辨別,完全依賴題目設計及閱卷規則;如果後兩步根本無法合理以錯誤前提繼續,該狀態便不應套用此例。
6. 研究結果:完全可重現的數學情境
6.1 等權六步題
在 m=6、w=1、p=0.70 下,純局部期望 E(K)=6×0.7=4.2;純鏈式期望 E(L)=0.7+0.7²+⋯+0.7⁶=2.058819。這是模型機率分配的精確加權結果,不代表任何香港考生、學校或公開試的平均分數。
表 1 不同 α 下的理論結果(六步、p=0.70、每步 1 分;全部為假設模型計算)
| α(局部比重) | E(T(α)) | Var(T(α)) | G₆(0.70,α,1) | 當 p≤0.90 的最大差距 |
|---|---|---|---|---|
| 0.00 | 2.058819 | 4.133733 | 2.773100 | 4.095100 |
| 0.25 | 2.594114 | 2.990735 | 2.079825 | 3.071325 |
| 0.50 | 3.129410 | 2.130780 | 1.386550 | 2.047550 |
| 0.75 | 3.664705 | 1.553868 | 0.693275 | 1.023775 |
| 1.00 | 4.200000 | 1.260000 | 0.000000 | 0.000000 |
| 0.755806 | 3.677136 | 1.543834 | 0.677175 | 1.000000 |
資料來源:本文式(2)、(7)、(13)之計算;各列由 code/model_analysis.py 自動產生。表內數值只經小數位四捨五入。
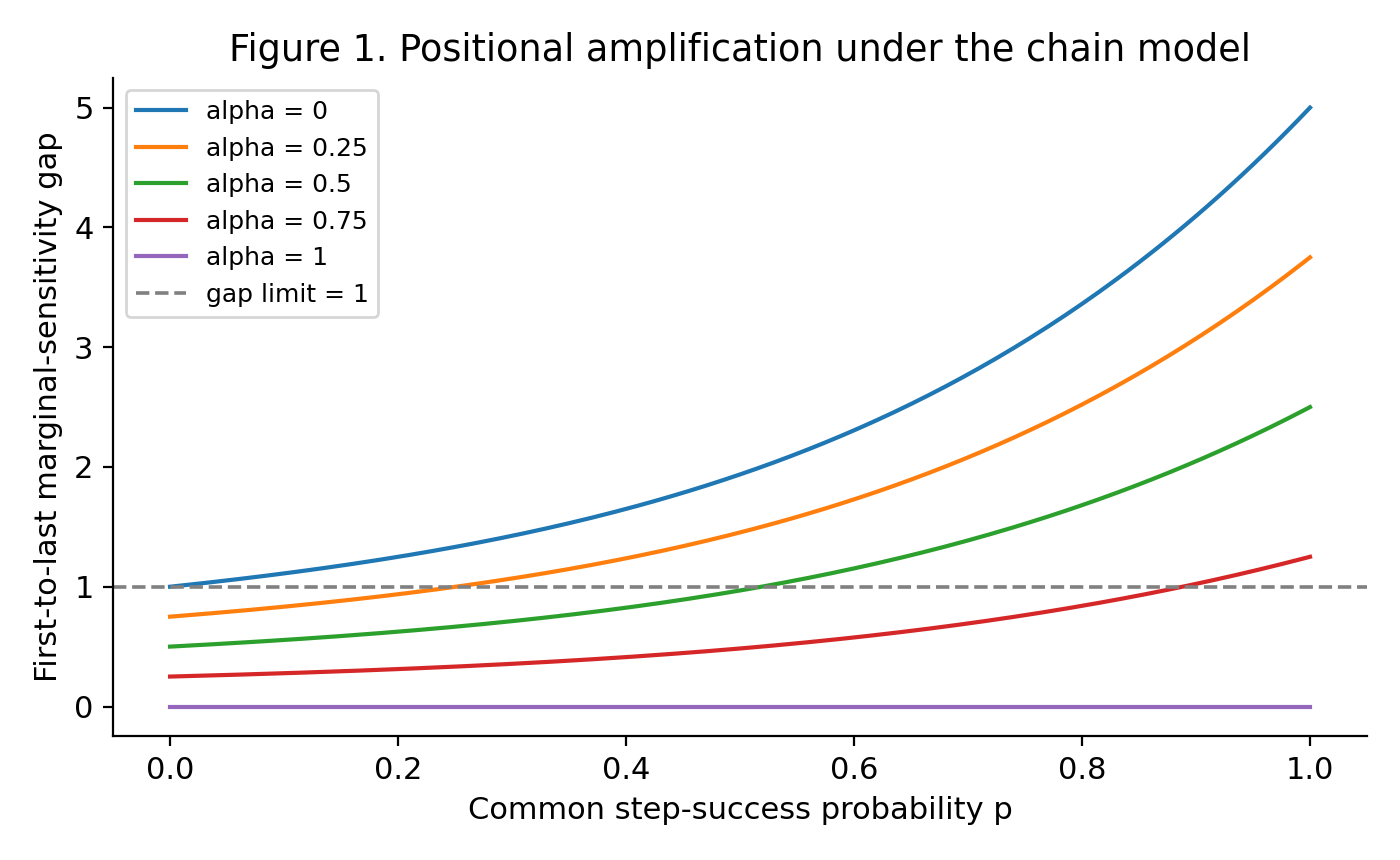
圖 1 六步等權鏈的首末步驟敏感度差距隨 p 變化。虛線是研究者設定的 1 分/機率差距上限;曲線均來自解析式(7),沒有真實學生數據。
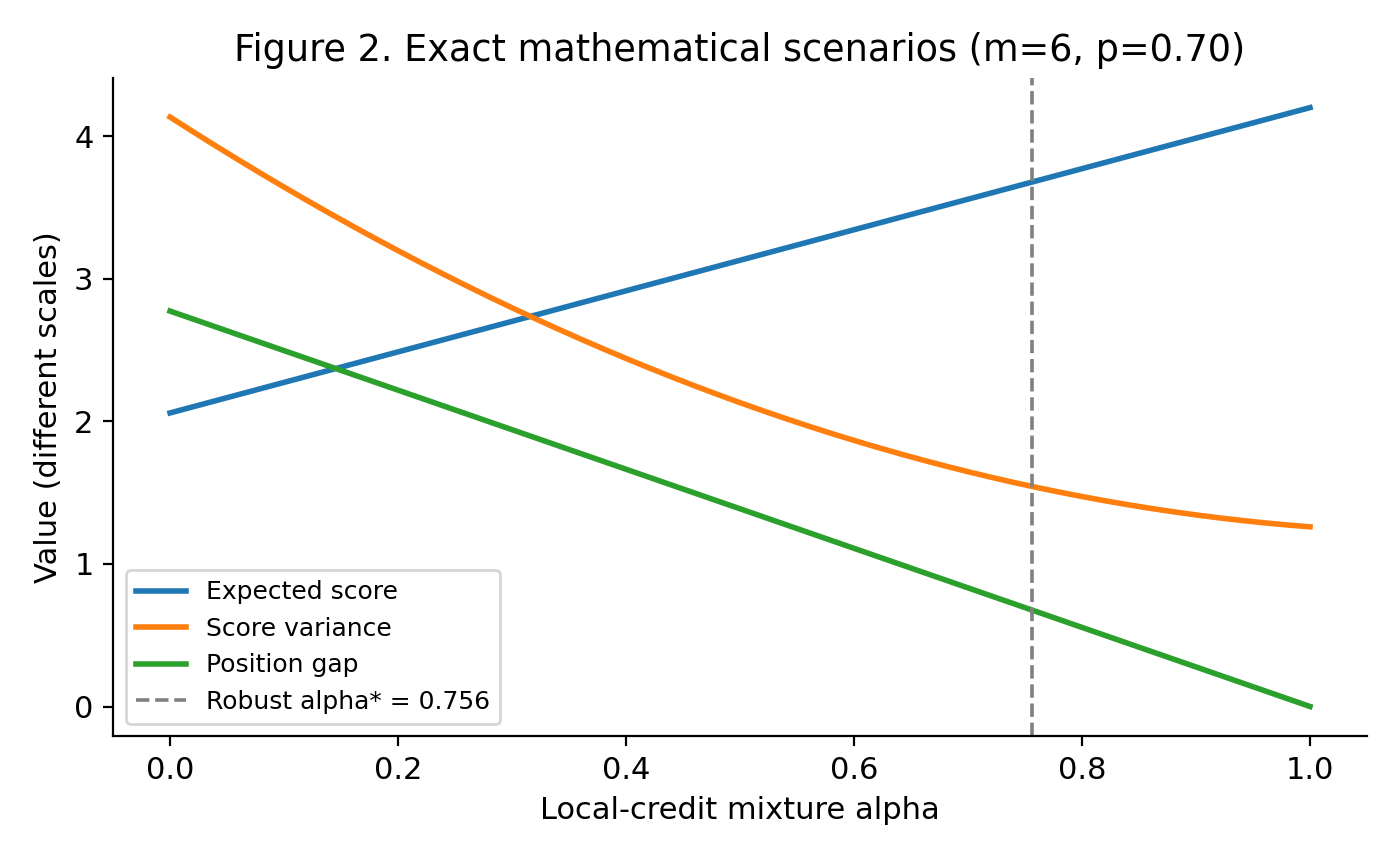
圖 2 於 p=0.70、m=6 的數學情境中,局部給分比例與期望、方差及位置差距的關係。三條量的單位/意義不同,同置圖中只便於比較變化方向,不能把三者的數值大小直接比較。
6.2 穩健門檻
設計者假設六步題的每一步局部成功率落在 [0, 0.90],要求「第一步與第六步的邊際分數敏感度差」始終不超過 δ=1;每步 w=1。依式(8),H₆(0.90)=1+0.9+0.9²+0.9³+0.9⁴=4.0951。因此
例如 α=0.75 僅有 1.023775 的最壞差距,因此略微超出設定上限;而 α=α* 時最壞差距剛好等於 1。這不是規準設計的通用推薦值:如果學校選擇另一容忍差距、步數、權重或成功機率範圍,α* 會隨之改變。若進一步要求分數必須為整數,式(1)產生的分數便未必可直接採用,另須研究取整規則所造成的效果。
6.3 數值與代數核查
程式以 m∈{1,2,4,6}、p∈{0,0.1,0.5,0.7,0.99,1} 及 α∈{0,0.17,0.5,1} 的全部組合進行完全枚舉,每組將公式的期望與方差同逐狀態加權結果比較;最大容許差異設為 10⁻⁹。導數另以中心差分核對,並對一個四節點先修 DAG 驗證式(14)。全部程式斷言已通過。測試僅提供計算實作驗證,一般性證明仍以第五節為準。
7. 討論及對香港數學教育的啟示
7.1 構念選擇決定評分的數學含義
若教學目的是判斷「整條推導能否得出完全正確答案」,累積事件 Yᵢ 自有其正當評核功能;若目的是診斷「學生能否獨立使用某種方法」,局部事件 Xᵢ 可能提供更直接的資訊。由定理 2 可見,採用鏈式事件會令較早步驟的成功機率影響多個其後得分事件。這個現象不一定是設計瑕疵:先修步驟本身可能是教師刻意強調的關鍵概念。研究上的重要區分是:評分反映的依賴性究竟來自課程目標,還是無意間由規準形式引入?
在學校的評核設計中,可以先畫出一條題目步驟鏈或技能 DAG,標示每個可辨識的概念/方法,以及每一步的相依關係;接着就某些代表性答案估計局部判分可行性,最後才以本文敏感度公式作「評分架構壓力測試」。假如規準容許承接錯誤的方法分,亦須列明哪類錯誤可以承接、哪類屬概念性錯誤而不可承接,否則兩名閱卷者可能給出不同的 Xᵢ。
7.2 對必修、M1 與 M2 的可能應用
在必修部分的多步代數/幾何題、單元一的統計與微積分題、單元二的代數與微積分題中,都可於題目設計階段嘗試將每一子步驟編碼為 Xᵢ,並以 DAG 描述分支或匯聚關係。但不同題型的「局部方法正確」是否可在先前數值錯誤下穩定辨認,需要數學科專家逐題檢視。例如幾何證明中一個缺失關鍵理由的步驟,有時無法與後面的推理完全分開;勉強按式(1)給分會扭曲推導的整體意義。
因此,本文提議將位置差距 G 與題目的內容效度一同討論,並在校本評估中使用。考評局大綱說明了評核目標,但本文沒有獲取可代表全部公開試的逐步給分資料;不宜推論香港現行公開試使用 α=0、α=1 或其他單一係數。
7.3 方差、分數可比性及更深入的心理測量
由式(13)所見,即使所有 p 不變,改變規準也能系統性改變均分與方差。如果校方希望比較兩套規準所得的學生表現,至少應使用同一批匿名答卷由多名閱卷者依兩套具體規準評分,檢查:分數分佈、學生排序、閱卷者一致性、對不同程度學生的區辨能力,以及與獨立能力指標的關聯。適當時可進一步建立多面向 Rasch 或認知診斷模型。本文沒有估計試卷信度、評分者間一致性,也不能從模擬方差單獨判定效度。
由式(16)亦知,即使兩個考生的底層局部成功向量相同,評分制度的選擇仍可能改變其先後名次。這值得在正式決策前做敏感度分析;但單一假設反例並不能估計現實的名次變動比例。
7.4 參數的政策含義
定理 3 的 δ 由評核者設定,代表某種可量化的設計偏好。制定者可先回答「願意容許先修步驟的成功率對整題得分有多大額外影響」,再用式(9)檢查該偏好與預定規準是否一致。此處的 α 是分數混合係數,不是心理測量量尺,也不是應由模型自動決定的政策結論。若有多個教育目標(完整推導、獨立方法能力、閱卷效率及公眾可理解性),便可能需要多目標最適化和實證取捨。
8. 研究限制
獨立性: 真實學生在相鄰步驟的答對情況常有相關性,與共同概念掌握、工作記憶負荷及粗心錯誤有關。A1 只是用以獲得閉式解的簡化模型;一旦改為相關伯努利或條件依賴模型,式(2)、(4)、(13)便須依聯合分佈修訂。
可識別性與判分可操作性: 某些步驟錯誤之後,後續「方法正確」沒有唯一客觀判準;教師對可承接錯誤範圍的判斷亦可能不同。A2 在不少證明題、建模題或包含概念性錯誤的題目中可能失效。
模型抽象程度: 式(1)可產生非整數分數,沒有建模扣分、封頂分、跳步解法、多種有效解題路徑或答案與方法分的複雜互動。DAG 表示法需要專家明確界定節點與邊,存在結構編碼偏差。
效度與公平性: 位置差距不等同社會公平,也沒有驗證它與學生能力測量品質的關係。由於本文沒有真實答卷、學生背景、閱卷者評分或學校比較資料,不可宣稱改善了公平、信度或成績。
研究原創性: 本文導數與方差公式由指定模型直接推導;可視為理論工作論文,但若日後投稿,仍需更廣泛比對已有部分給分、分段評分、ECF、認知診斷及測量資訊研究,並讓外部同行評審確認獨立新穎性。
文獻取得: 本輪檢索主要使用公開官方網頁、出版商文章頁、ERIC/PMC 公開記錄與一篇香港數學教育 PDF。部分出版商論文只核對到摘要及書目資料;考評局 2026 年大綱的 PDF 網頁可檢索,但直接全文擷取曾遇到 HTTP 403,故未逐頁檢查其所有條款。以上限制已記錄於 Literature_Search_Log.md。
9. 結論
本文建立區分局部正確與先修鏈正確的混合評分模型,證明了等權線性鏈的嚴格位置放大關係,給出了首尾差距控制的必要且充分條件,並把影響導數推廣至一般先修 DAG。所得位置差距能精確刻畫「早期錯誤影響後續得分」這一結構效果,同時揭示原始分數的均值、方差與學生排序可能因規準而不同。
這些是模型內可證明的數學結論。目前沒有證據支持把特定 α 或 δ 定為香港文憑試最佳規準,也不能由此評價現行考評制度。後續研究可採取雙閱卷者交叉評分,從實際香港中學數學題建立先修圖與方法分的標註規則,檢驗局部成功狀態的可識別性、關聯性及參數穩健性,並研究整數分數與不同題型下的最適化問題。
參考文獻
- 教育局(2017)。《數學教育學習領域課程指引(小一至中六)》及高中數學課程補充文件。https://www.edb.gov.hk/en/curriculum-development/kla/ma/curr/index2.html
- 香港考試及評核局(2026)。《2026 年香港中學文憑考試數學科評核大綱》。https://www.hkeaa.edu.hk/DocLibrary/HKDSE/Subject_Information/math/2026hkdse-c-math.pdf
- 梁子傑(2014)。〈香港中學文憑考試數學科分數計算的研究〉。《數學教育》,36,2–6。https://www.hkame.org.hk/uploaded_files/magazine/36/534.pdf
- Gierl, M. J., Alves, C., & Taylor Majeau, R. (2010). Using the attribute hierarchy method to make diagnostic inferences about examinees’ knowledge and skills in mathematics: An operational implementation of cognitive diagnostic assessment. International Journal of Testing, 10(4), 318–341. https://doi.org/10.1080/15305058.2010.509554
- Leighton, J. P., Gierl, M. J., & Hunka, S. M. (2004). The attribute hierarchy method for cognitive assessment: A variation on Tatsuoka's rule-space approach. Journal of Educational Measurement, 41(3), 205–237. https://doi.org/10.1111/j.1745-3984.2004.tb01163.x
- Masters, G. N. (1982). A Rasch model for partial credit scoring. Psychometrika, 47(2), 149–174. https://doi.org/10.1007/BF02296272
- May, T. A., Koskey, K. L. K., Bostic, J. D., Stone, G. E., Kruse, L. M., & Matney, G. T. (2023). Examining how using dichotomous and partial credit scoring models influence sixth-grade mathematical problem-solving assessment outcomes. School Science and Mathematics, 123(2), 54–67. https://doi.org/10.1111/ssm.12570
- Moons, F., & van Schendel, C. (2026). How do mathematics teachers grade tests? Different scoring and content priorities in micro-decisions, yet similar final grades. Educational Assessment, Evaluation and Accountability. https://doi.org/10.1007/s11092-026-09489-w
- Tu, D., Wang, S., Cai, Y., Douglas, J., & Chang, H.-H. (2019). Cognitive diagnostic models with attribute hierarchies: Model estimation with a restricted Q-matrix design. Applied Psychological Measurement, 43(4), 255–271. https://doi.org/10.1177/0146621618765721