摘要
跨線輪轉同時改變玩家取得兵線收益的位置、到達目的地的時間,以及原防守路線的防禦暴露。把輪轉簡化為「目標路線獎勵大於留守獎勵便立即移動」忽略了兵線波次錯位、行程中的收益空窗、持續累積的塔風險,以及同一決策對未來選項的影響。本文提出具有限期、可逆行程、塔剩餘生命離散狀態及週期性資源到達的馬可夫決策過程(Markov Decision Process, MDP)。我們以 Bellman 後向遞推求解最優策略,推導單期輪轉的風險溢價門檻,並證明在給定模型及邊界條件下的後向遞推最適性。數值部分以完全公開的假設參數,比較動態策略、固定守 A、固定走 B 與單期貪婪策略;以相同亂數環境進行每策略 7,000 次蒙地卡羅(Monte Carlo)模擬,同時使用精確動態規劃評估核對。基準設定下,動態策略的精確期望效用為 45.55,固定守 A 為 23.61,固定走 B 為 29.66,單期貪婪為 23.61;相應的塔損失機率分別為 7.53%、1.03%、70.31% 及 1.03%。本文的主要貢獻是以可檢驗的狀態轉移模型說明:較高總效用不必然伴隨最低防禦風險,而且出發時間的價值取決於後續波次與行程長度。這些結論在抽象模型內成立,但其對真實玩家、地圖與版本的外推仍有待實證。
關鍵詞:《王者榮耀》;跨線輪轉;馬可夫決策過程;兵線同步;有限期最佳化;防禦塔風險
1. 引言(Introduction)
1.1 研究背景與問題界定
多人線上競技場遊戲(Multiplayer Online Battle Arena, MOBA)的決策具有典型的時空耦合特徵。玩家在一處地圖區域活動,就必然暫時放棄另一處區域的即時操作與取得資源的機會;當移動需時,而且兵線具有到達窗口,移動的起點、抵達時刻及回程安排便同等重要。即使假定所有玩家完全知道下一輪兵線何時出現,也不能只比較兩條路線當下的收益,因為離開原線可能增加防禦塔的後續風險。
本文選取一個足夠簡單、又能保留關鍵取捨的模型:一名決策者最初位於 A 線,需要決定是否走向 B 線取得額外波次收益。行程長度為 d 個決策期;當決策者仍在 A 線時,可以取得 A 線收入並降低防禦暴露;位於 B 線時,可以取得 B 線收入;途中不可取得任何線的收入。若 A 線出現兵線且角色不在 A 線,則防禦塔以假設機率受到一次離散損害。本文沒有把各條線的權重解釋為真實金幣,也沒有對特定英雄、裝備、傷害公式或版本作出事實主張。
既有 HOK-001 研究處理不完全視野下「應否購買偵察資訊」的貝葉斯決策與尾端風險;工作目錄內更早的示例論文處理單人排位開團跟隨的協調博弈。本文改以已知波次時序與行程摩擦為中心,讓不確定性只來自塔損害事件,並將防禦狀態帶入多期決策。故研究對象、狀態、可證明性質及實驗皆與兩份先前研究明顯不同。
1.2 研究問題、目標與假設
本文的主要 Research Problem 是:「當兩條路線的資源波次錯位、跨線交通需要多個決策期,且原路線防禦塔存在隨機損失風險時,有限決策期內應如何安排留守、出發、途中折返與抵達?」研究目標(Research Objectives)為建立明確狀態與現金流類比的收益核算、求得多期最優控制、識別門檻成立的條件,以及建立可以完全重現的數值對照。
本研究提出四項可檢查的 Research Questions:第一,單期輪轉何時值得承擔額外防禦風險?第二,非零行程長度能否使立即收益為零的移動仍具正向價值?第三,與固定留守、固定輪轉及短視策略相比,多期規劃是否取得更高期望效用?第四,塔風險變大、行程變長之後,策略優勢與破塔機率如何變動?對應的 Research Hypotheses 分別為:H1,單期策略存在由資源差及塔暴露差決定的門檻;H2,未來波次足夠密集時,提前移動可具有正選擇價值;H3,在同一模型下,精確後向遞推的期望效用弱優於指定對照策略;H4,提升移動時間通常壓低可達收益,但各風險曲線的排序及轉折必須由模型計算而不能預設。
1.3 研究貢獻與識別邊界
本研究並不宣稱發現全新的 MDP 理論;創新定位在於把「波次的時間離散性」、「可逆跨線路徑」、「塔剩餘承受次數」與「存續終止」結合,形成一個足以解釋跨線時機的最小原創應用模型。具體可驗證貢獻是公開程式碼、明確風險門檻、精確解與抽樣結果的交叉核對,以及對收益最大化與塔保全目標衝突的量化。其外部效度受到假設設計制約;讀者不能因為模型內較優便推定真實勝率較高。
2. 文獻回顧(Literature Review)
2.1 動態規劃與有限期決策
Bellman(1952)發表的動態規劃理論奠定了以「最優後續決策價值」連結當期決策的方法。Puterman(1994)系統整理離散隨機動態規劃的狀態、行動、轉移及價值函數框架。Sutton 與 Barto(2018)進一步將 MDP 作為強化學習及序貫決策的基礎,說明為何短視的立即獎勵準則一般不足以代表長期回報。本文的控制器使用已知轉移機率的精確動態規劃,故毋須透過模型訓練估計決策值;引用強化學習文獻是為了辨明多期規劃與單步貪婪的差異,不意味著本文已訓練 AI 代理。
2.2 單調決策、動態競爭與研究定位
Topkis(1978)給出在格結構上最佳化決策隨參數單調變化的充分條件。該結果提醒研究者:若要聲稱「風險愈高便愈少輪轉」的全域單調性,需要驗證轉移與價值函數的增差或次模結構;僅展示一張熱圖並不能構成證明。Shapley(1953)討論隨機博弈,指出當環境由多個策略對手共同決定時,單代理 MDP 必須擴展為互動策略模型。本文刻意將對方攻勢吸收為外生塔損害機率,因此不能識別敵人因輪轉而改變攻勢的策略反應。
相關研究提供成熟的數學工具,但沒有直接給出本文所設的 A/B 波次規則、塔損害參數或《王者榮耀》版本校準值。這是有意識的研究設計:先用一般理論產生可驗證命題,再把版本規則與錄影資料留待第二階段納入,而非依賴無法查證的遊戲數字。本文所有原創公式均在以下自定義假設下推導,不應被誤寫為上述作者曾提出的具體遊戲模型。
3. 問題建構(Problem Formulation)
3.1 時間、路徑與狀態空間
觀察窗口由 t=0 至 T−1,共 T 個等長、抽象的決策期。玩家位於 A、B 或連接兩者的中間位置,以整數 x 表示,x=0 為 A,x=d 為 B;x=1,…,d−1 是無法收取任一線波次的行程位置。玩家每期只能原地停留,或沿路徑移動一格。防禦塔剩餘生命以 h=1,…,H 個離散「可承受損害事件」表示;h=0 為本研究的吸收終止狀態。完整狀態是 (t,x,h)。此處生命不是官方建築 HP,也不代表真實傷害次數。
令 w_A(t),w_B(t) 為當期是否有可取得兵線收益的二元外生變數。它們屬於建模時設定的假想日曆,而非任何版本的現場觀測。若行動令下一位置為 y,則該期可取得 A 線固定效用 g_A w_A(t) 當且僅當 y=0;可取得 B 線固定效用 g_B w_B(t) 當且僅當 y=d。玩家可在不收取波次時移動;該期移動本身不另設固定成本,行程成本來自途中無法收取資源及塔的額外暴露。
3.2 模型符號表
| 符號 | 定義 | 單位及範圍 |
|---|---|---|
| t,T | 當前決策期與有限期總長 | 期;t=0,…,T−1 |
| x,y,d | 本期位置、行動後位置、單程路程 | 格;0≤x,y≤d |
| h,H | 剩餘承受次數及初始上限 | 次;h=1,…,H |
| w_A,w_B | A/B 的假想波次到達指示 | 0 或 1 |
| g_A,g_B | 每個波次的抽象正向效用 | 效用單位,非金幣 |
| p_D,p_U | 守線/離線時 A 波次打擊機率 | 機率,0 至 1 |
| C | 塔被摧毀時的一次性懲罰 | 效用單位,C≥0 |
| γ | 多期折現係數 | (0,1],基準為 1 |
| V_t(x,h) | 最優剩餘期望效用 | 效用單位 |
| π_t(x,h) | 最優下一位置 | 0,…,d |
3.3 行動集合及事件次序
合法行動為 y∈{max(0,x−1),…,min(d,x+1)};因此所有中間位置都可選擇前進、等待或折返。每期依固定次序發生:首先選擇下一位置 y,接著依當期 w_A、w_B 收取符合位置的收益,最後檢驗 A 線波次是否造成一次塔損害。這個次序是一項影響結果的模型設定:如果實際對局中兵線獎勵與塔傷害同步或存在較細粒度時序,需重新離散化。
令當期損害機率 q_t(y) 在沒有 A 波次時等於 0;有 A 波次且 y=0 時等於 p_D;有 A 波次且 y>0 時等於 p_U。若抽得損害,h 減一;當 h=1 且再受擊,立即計入 −C,並結束本次軌跡。未被摧毀時可繼續下一期。沒有塔自我恢復、同時多發命中、沿路被擊倒、推塔收益反饋或敵方戰略調整。
3.4 透明假設與可識別性
假設 A1:每期的波次日曆預先知道,決策者對未來日曆具有完整資訊;這一假設刻意把資訊價值問題與 HOK-001 分開。假設 A2:給定 y 與 w_A(t),本期塔損害為獨立伯努利事件(Bernoulli event),機率是 p_D 或 p_U;這不表示真實兵線傷害必然服從伯努利分配。假設 A3:所有正向收益非負,破塔成本 C 非負,初始 x=0、h=H。假設 A4:沒有其他玩家或英雄屬性;敵方活動只在外生打擊機率中反映。假設 A5:塔損失使研究窗口提早終止;此設定用以把塔保全重要性寫成明確終止成本。
以上假設使狀態 (t,x,h) 具有馬可夫性(Markov property):已知當前狀態與當期移動,下一狀態及回報分配不必再依賴更早的歷史。若波次時序存在未知敵方干擾,狀態應加入信念或敵方策略;不應直接使用本文的完整資訊解。
4. 數學模型(Mathematical Model)
4.1 即期效用與損害機率
令 r_t(y) 為選定下一位置後可取得的確定波次收益。兩個互斥端點的支付如下:
其中指示函數只在條件成立時等於一。當 d≥1,不能同一時刻同時處於 A 與 B;因此不會雙重計算同一個玩家的收入。損害機率為:
以上寫法強調:無 A 波次的期間,本文只考慮波次造成的風險,因此 q_t(y)=0;真實對局中的英雄攻擊、技能、其他兵線作用並未計入。塔損害隨位置而改變,令玩家在往返途中亦可能承受額外風險。
4.2 Bellman 遞推與計算步驟
定義 V_T(x,h)=0,表示在研究窗口結束且塔尚未摧毀時,沒有額外殘值。若 h>1,受擊後下一期剩餘生命是 h−1;若 h=1,受擊時獲得一次 −C 並終止。因而定義以下條件續值:
以折現係數 γ>0 書寫,即期獎勵與未來條件期望相加,可得動態規劃的行動價值:
當受擊後 h=0,公式中 γJ=−C,所以破塔成本在當期計入,與模型敘述一致。價值函數及最佳策略為:
式中的行動集 A(x) 僅取相鄰三格內的合法位置,故無論 B 的波次多有吸引力,都不能瞬間跳到 B。演算法由 t=T−1 向 t=0 逆向更新;每個狀態檢查至多三個候選移動,時間複雜度為 O(THd),記錄所有期數的策略與價值表使用 O(THd) 空間。由於一個決策期內只有一次傷害機會,h 的變化必須明確由轉移運算處理,不可用簡單的期望 HP 取代。
4.3 對照策略及可重現評估
為隔離「規劃」本身的貢獻,我們建構三個不依賴求解器的基準。guard_A 每期盡量往 A 走;camp_B 每期盡量往 B 走;myopic 每期只最大化當期收入扣除當期立即摧塔的預期成本,當 h>1 時不預先懲罰未來可能累積的傷害。最優策略 optimal 則使用完整後向遞推。這些名稱表示本文抽象策略,並非真實玩家行為的實證類型。
對任何固定策略 π,同一模型可以不經隨機模擬而遞推其期望收益 U^π_t(x,h) 與塔被摧毀的機率 L^π_t(x,h)。設 y=π_t(x,h),則後者滿足:
其中 K=1 當 h=1,否則 K=L^π_{t+1}(y,h−1),並以 L^π_T=0 為終點。這可以與由抽樣軌跡計算的破塔頻率獨立交叉核對。期望效用亦可按相同策略而不取最大值地套用第 4.2 節公式;因此本文圖 3、圖 4 的曲線是精確模型計算,不是具有取樣誤差的估計曲線。
5. 理論分析(Theoretical Analysis)
5.1 命題一:有限期後向遞推的最適性
命題 1。 若 T、d、H 為有限正整數,所有收益與損害機率有限、行動集不為空,且當前狀態具馬可夫性,第 4.2 節的後向遞推對任意起始狀態 (t,x,h) 求得所有可行非預知策略中的最大期望折現效用。
證明。 終點 t=T 沒有剩餘回報,故所有未摧毀狀態的真實最優續值都為 0。假設 V_{t+1} 已等於從 t+1 開始的最優條件續值。任取 t 的行動 y,依全機率公式,本期回報的條件期望為 r_t(y),未受擊續值為 V_{t+1}(y,h),受擊後續值為 V_{t+1}(y,h−1) 或一次性成本 −C。最優策略在首步之後可改用以新狀態為條件的最優續策;因此首步行動的最優期望恰為 Q_t。有限行動集保證極大值可達,對全部合法 y 取最大值即得 V_t。由數學歸納法,性質成立至 t=0。這是 Bellman 原理在本文有限狀態模型下的標準直接應用,並非新的普遍最適性定理。證畢。
詮釋。 命題 1 的「最優」只對本文列明的獎勵、風險、折現和狀態成立。若真實玩家需要兼顧視野、擊殺、隊伍溝通或心理損失,而本文沒有把它們寫入收益,數學最優也不構成遊戲行動建議。
5.2 命題二:單期的輪轉風險門檻
命題 2。 考慮僅餘一個決策期、d=1、玩家起於 x=0、塔僅餘 h=1、且兩條線本期均有波次的特殊狀態。設兩種行動均無後續殘值,則移動到 B 弱優於留守 A 的充要條件為:
推導。 留守 A 的期望效用是 g_A−Cp_D;移到 B 的期望效用是 g_B−Cp_U。相減恰為左側波次收益差減右側防禦暴露溢價,故不等式成立當且僅當輪轉較佳。若 p_U=p_D,風險溢價消失,條件退化為 g_B≥g_A;若 p_U>p_D,塔損失代價 C 的提高會線性增加所需 B 線額外收益。等價地,當 p_U>p_D、C>0,對給定獎勵差的臨界防禦成本是 (g_B−g_A)/(p_U−p_D)。
此命題是一個邊界狀態的可驗證精確結果,並非一般 t、h、d 下的全局門檻。當 d>1 時,玩家本期移動未必抵達 B;當 h>1 時,本期損害不必立即觸發 −C;當 T>1 時,續值還依賴後續波次。因此,錯將單期公式套用於多期或遠距輪轉,會忽略本文最重要的時間機會成本。
5.3 命題三:規劃效用對固定策略的弱優越性
命題 3。 對任何同一初始狀態、相同行動限制、同一風險轉移和收益下的合法固定策略 π,必有 V_0(0,H)≥U^π_0(0,H)。
證明。 命題 1 表明 V_0 是所有合法策略的最大期望收益;固定策略 π 屬於可行集合,因此其期望值不能超過 V_0。證畢。
這個不等式也說明,精確動態規劃與固定策略的比較並不是公允性的經驗性勝負試驗:最優策略對本模型占優是由定義和遞推保證。真正需要數值檢驗的,是最優優勢有多大、它是否要求承擔更高塔損害、以及抽樣模擬是否正確重建精確期望。
5.4 時間機會成本及不宜過度推廣的性質
設某期玩家位於中途 x,若選擇朝 B 移動而非回 A,當期都可能沒有收入;比較兩行動須考慮下一期剩餘生命與可達位置分布,決策差為 Q_t(x,h;x+1)−Q_t(x,h;x−1),其中續值差可以顯著大於當期 r 的差值。因此,「當期沒有可收的波次便不應移動」並非由模型導出的定理。提前移動具有正值是為未來 B 波次保留準時抵達能力,等價於時間上的機會成本管理。
模型亦不存在不經額外證明即可聲稱的全面單調門檻:當改變 p_U、g_B 或 C 時,某些狀態的最佳行動可能因未來路徑切換而跳變;有限期的波次相位會破壞簡單的靜態比較。Topkis(1978)的比較靜態思想因此在本文被用作推導門檻的條件提醒,而非聲稱本文已證明風險對所有狀態具有單調策略。對於 d 增大而價值下降的曲線,本文只把它當成指定假設網格上的數值發現,不作一般形式定理。
6. 數值實驗(Numerical Experiments)
6.1 資料來源、參數及事先指定的波次日曆
本文的 Data Source 是本研究自行編碼生成的合成環境。沒有從 API 擷取比賽資料,沒有影像標註,也沒有真實玩家樣本;樣本數只指模擬軌跡。所有資料可由 simulation.py 再造,固定亂數種子為 20261015。為了讓時序錯位可被檢驗,A 波次設在 t modulo 3 = 2 的決策期;B 波次設在 t modulo 4 為 1 或 2 的決策期。選用三期及四期兩個週期純屬實驗設計,並非任何《王者榮耀》版本的官方兵線到達週期。
| 參數 | 基準設定 | 理由與性質 |
|---|---|---|
| T,d,H | 24,2,2 | 有限期、往返需要時間、塔可承受兩次假想打擊 |
| g_A,g_B | 3,6 | B 波次單次報酬較高,單位為自定義效用 |
| C,γ | 32,1.0 | 破塔一次性成本,沒有時間折現 |
| p_D,p_U | 0.02,0.28 | 有守與離守時的合成打擊概率 |
| A 波次 | t mod 3 = 2 | 離散假想日曆,非實測 |
| B 波次 | t mod 4 ∈ {1,2} | 不同相位的假想日曆,非實測 |
如圖 1,兩條線的收益窗口有時重疊、有時交錯。若只看波次數量而無視相位,便不能區分「現在出發但來不及到達」與「提前一兩期出發可以準時到達」。可逆路程 d=2 意味由 A 至 B 至少需要兩次連續前進;若途中發現風險升高(在本模型中即塔剩餘承受次數減少),仍可折返。這項設計能捕捉不可瞬移造成的行動約束。
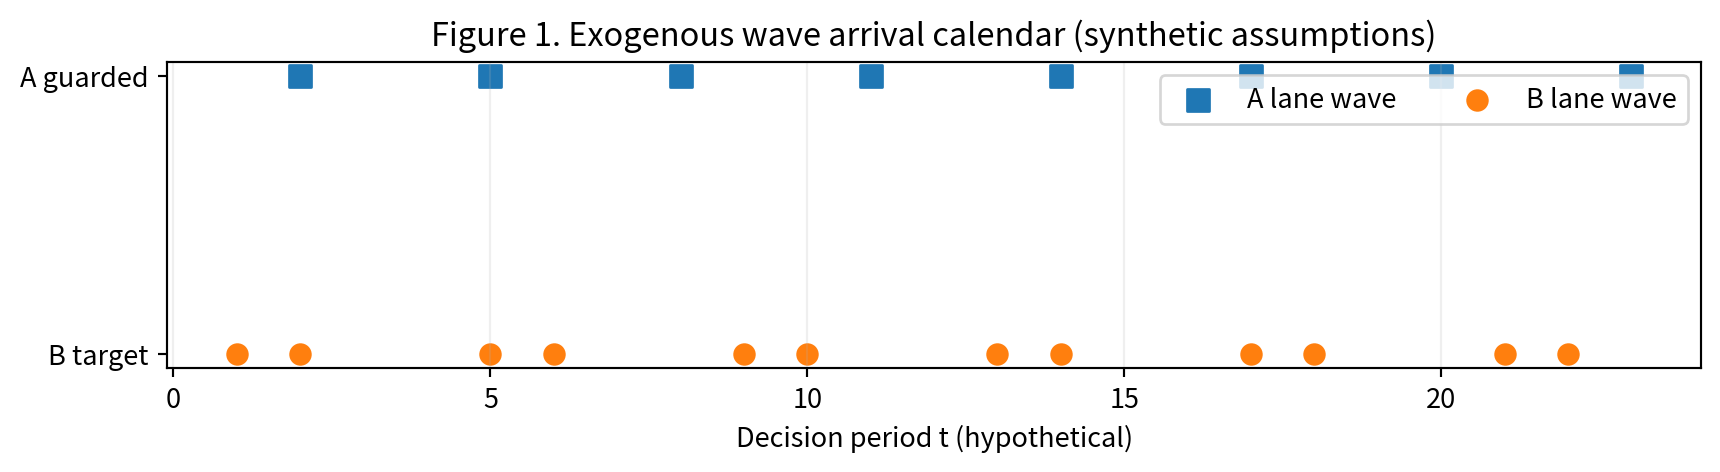
圖 1:自訂 A、B 兵線收益日曆;橫軸為抽象決策期,並非真實對局秒數。資料來源:研究者合成設定。
6.2 實驗配置、比較及統計程序
第一組使用基準參數執行後向遞推,並對四個策略的期望效用與破塔機率做精確評估。第二組在 p_U=0.04 至 0.72 的 30 點網格上進行單因子敏感度分析;其他參數不變。第三組把 B 單次收益從 2 至 12 改變,同時將塔初始耐受次數設為 H=1,記錄首期往 B 方向移動的行動,以觀察決策邊界;此組是有意調整的不同情境,不能把熱圖直接等同基準的 H=2 方案。第四組將 d 從 1 至 6 改變,觀察交通摩擦。第五組對每策略抽樣 n=7,000 次獨立軌跡,同一模擬編號在四種策略間共用每期環境 Uniform(0,1) 亂數,減少比較中的環境差異。
蒙地卡羅試驗的期望效用點估計是樣本平均,標準誤(standard error)為樣本標準差除以樣本數平方根;圖 6 繪製常態近似的 95% 信賴區間,而非保證有限樣本精確覆蓋。四種策略因使用相同環境亂數而相關,圖上的各別信賴區間不能直接當作配對差值的信賴區間。精確期望沒有抽樣誤差,作為程式交叉驗證標準,與模擬分布分開報告。
6.3 基準策略比較
| 策略 | 精確期望效用 | 精確破塔機率 | MC 平均效用 | MC 95% 區間 |
|---|---|---|---|---|
動態最優 optimal |
45.55 | 7.53% | 45.62 | [45.19, 46.05] |
固定留守 guard_A |
23.61 | 1.03% | 23.59 | [23.50, 23.68] |
固定前往 B camp_B |
29.66 | 70.31% | 30.31 | [29.58, 31.04] |
單期貪婪 myopic |
23.61 | 1.03% | 23.59 | [23.50, 23.68] |
在這個基準設定下,動態最優策略高於留守策略的精確效用差為 21.94 個合成單位;但其破塔機率高出約 6.50 個百分點。這表示收益最大化會容忍可量化而非零的防禦風險,不能以「動態策略最優」推導出其「最安全」。固定衝向 B 策略的單次回報機會雖高,卻承擔約 70.31% 的塔損失機率;因塔損後軌跡終止,持續從 B 取得收益的策略會受到早期摧塔的負面影響。單期貪婪策略在此參數下與留守 A 完全重合,因為它無法為當下沒有收入的跨線移動賦予未來抵達價值。
6.4 門檻相圖與風險曲線
圖 2 展示 H=1 的另一個敏感度情境:橫軸是離線受擊機率,縱軸是 B 波次效用;顏色表示 x=0、t=0 的最優下一位置。當 B 收益足以支持跨線準時抵達時,即使當期不能收取 B 波次,後向遞推亦可能要求先向 B 移動。更高離線受擊機率會壓低部分區域的移動吸引力,但圖的任何彎曲分界均由具體波次日曆及塔存續模型共同產生,不能將其寫成一般定理。
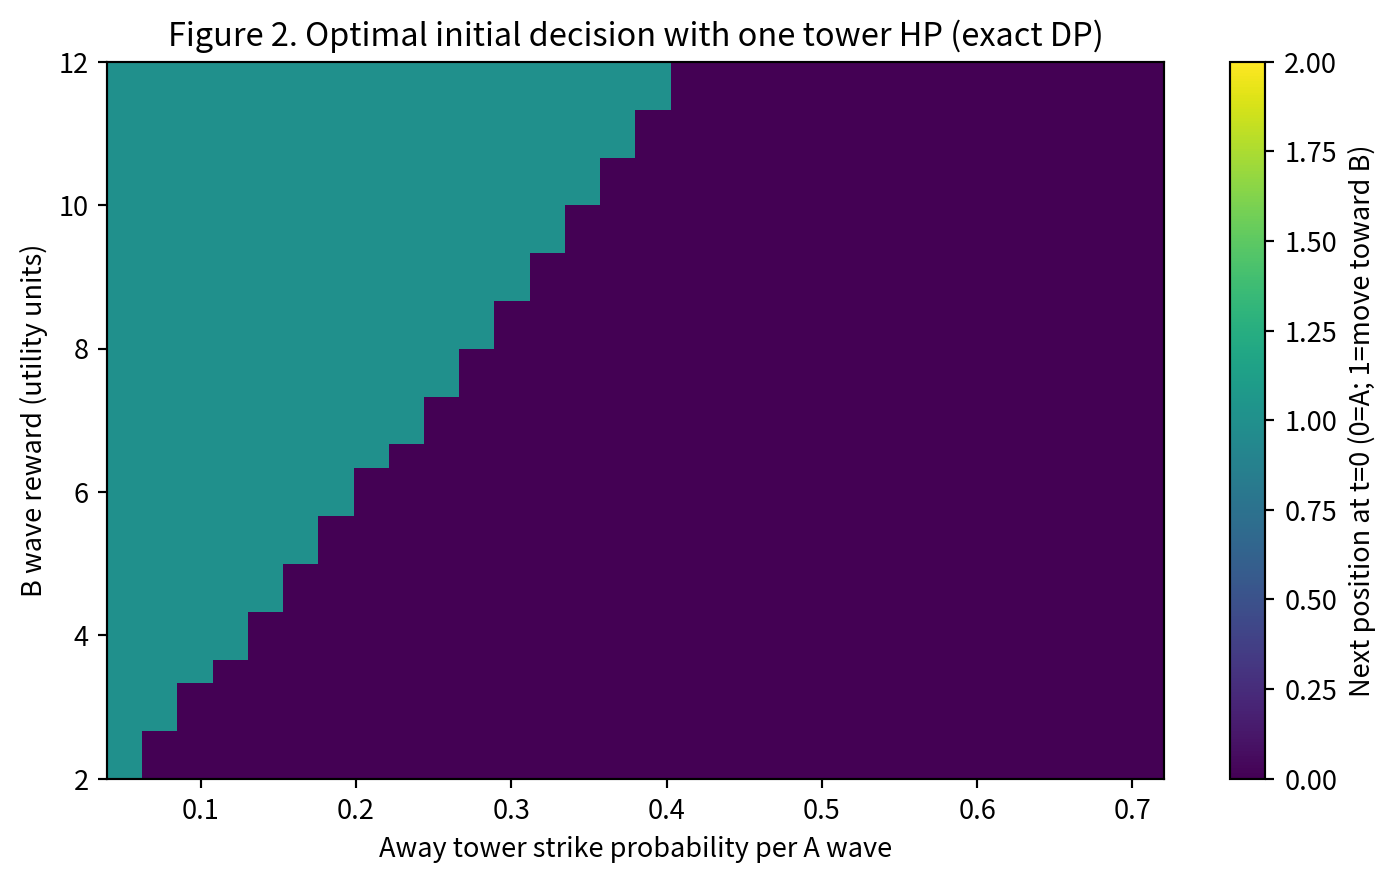
圖 2:H=1 時的最優首期位置相圖。數值來自精確後向遞推;所有參數是合成假設。
圖 3 在固定基準其他參數之下,將離線受擊機率 p_U 提高,逐一重算最優策略及三個對照策略的精確期望效用。圖 4 改以相同橫軸顯示破塔機率。兩張圖必須合讀:只比較圖 3 的收益可能忽略為取得收益所增加的尾端損失;只比較圖 4 的風險則可能忽略不願離線的機會成本。對同一風險值,最優策略可能因塔剩餘生命與波次位置而轉換決策,故曲線有可能出現斜率改變。
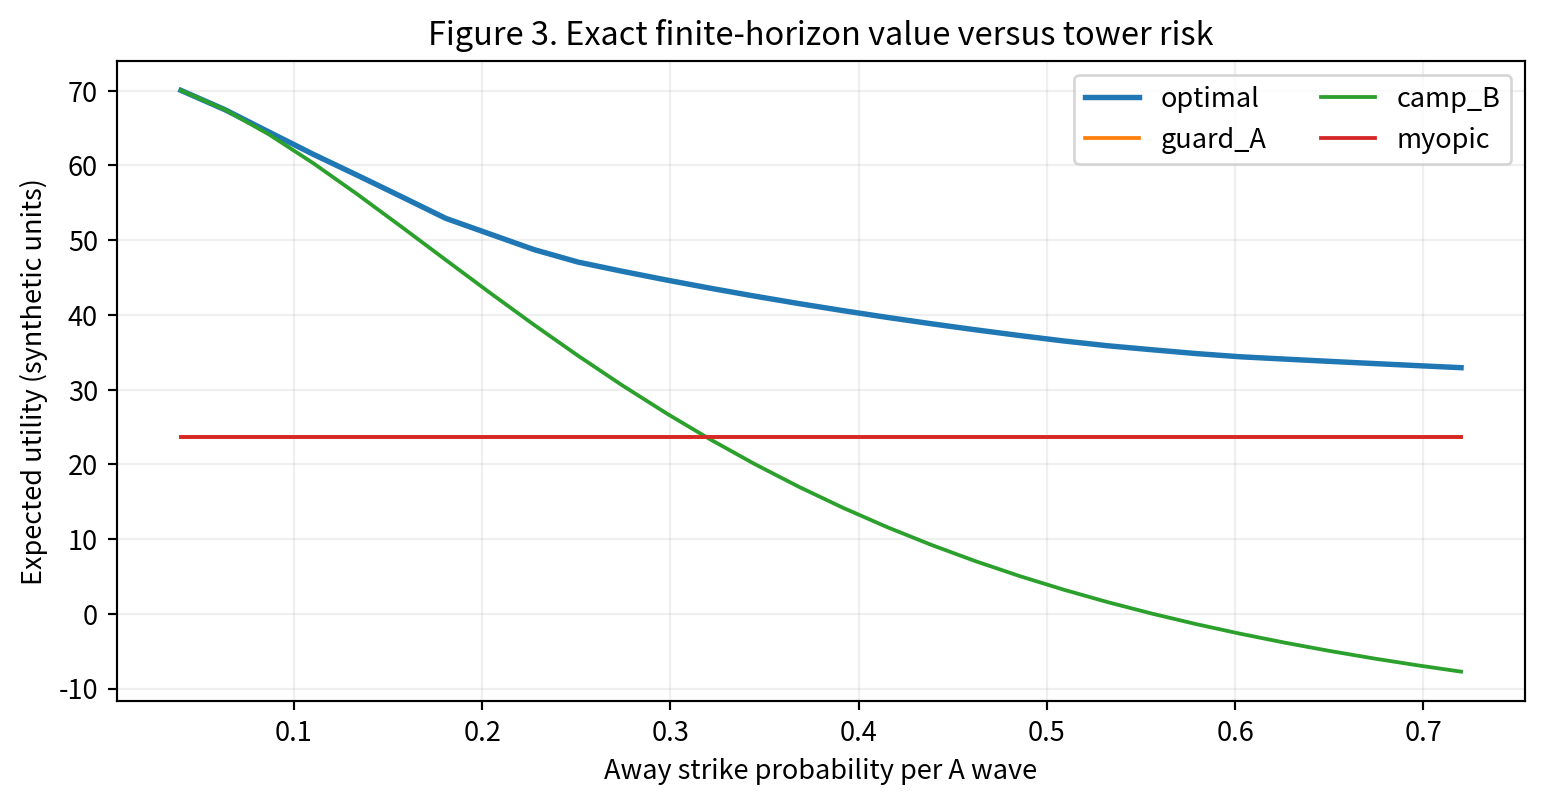
圖 3:四策略期望效用與離線受擊機率;精確 Bellman/策略評估結果,非實際對局資料。
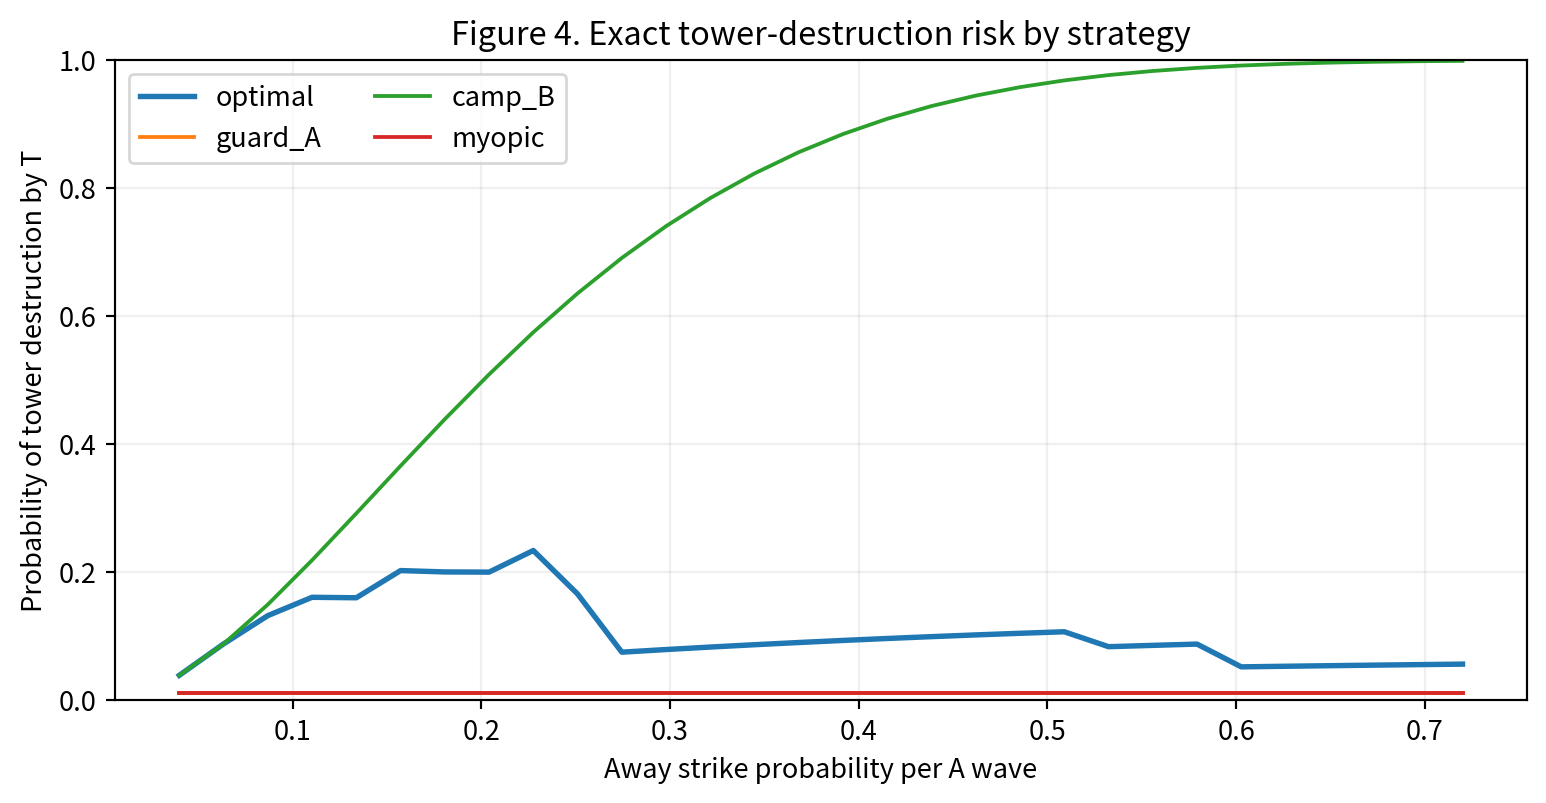
圖 4:四策略的有限期破塔機率;以精確機率遞推所得,非經驗估計。
6.5 交通延遲的機會成本
| 假設單程期數 d | 動態最優期望效用 | 固定留守期望效用 |
|---|---|---|
| 1 | 75.61 | 23.61 |
| 2 | 45.55 | 23.61 |
| 3 | 36.72 | 23.61 |
| 4 | 31.19 | 23.61 |
| 5 | 27.76 | 23.61 |
| 6 | 25.65 | 23.61 |
圖 5 與上表展示 d 由 1 增至 6 時,基準假設下的動態最優期望效用由 75.61 降至 25.65,而固定留守 A 的值維持 23.61。此結果屬於具體網格的數值比較:延長路程讓玩家較難同時利用兩線波次,且中途無收益期增加。固定守 A 不必移動,故在這組定義中與 d 無關。當 d=6,仍可偶爾從 B 取得好處,故動態策略未完全退化成留守;然而優勢已比 d=1 小得多。這一形態支持「行程就是機會成本」的研究詮釋,卻尚不足以外推到真實地圖距離、角色移速或兵線速度。
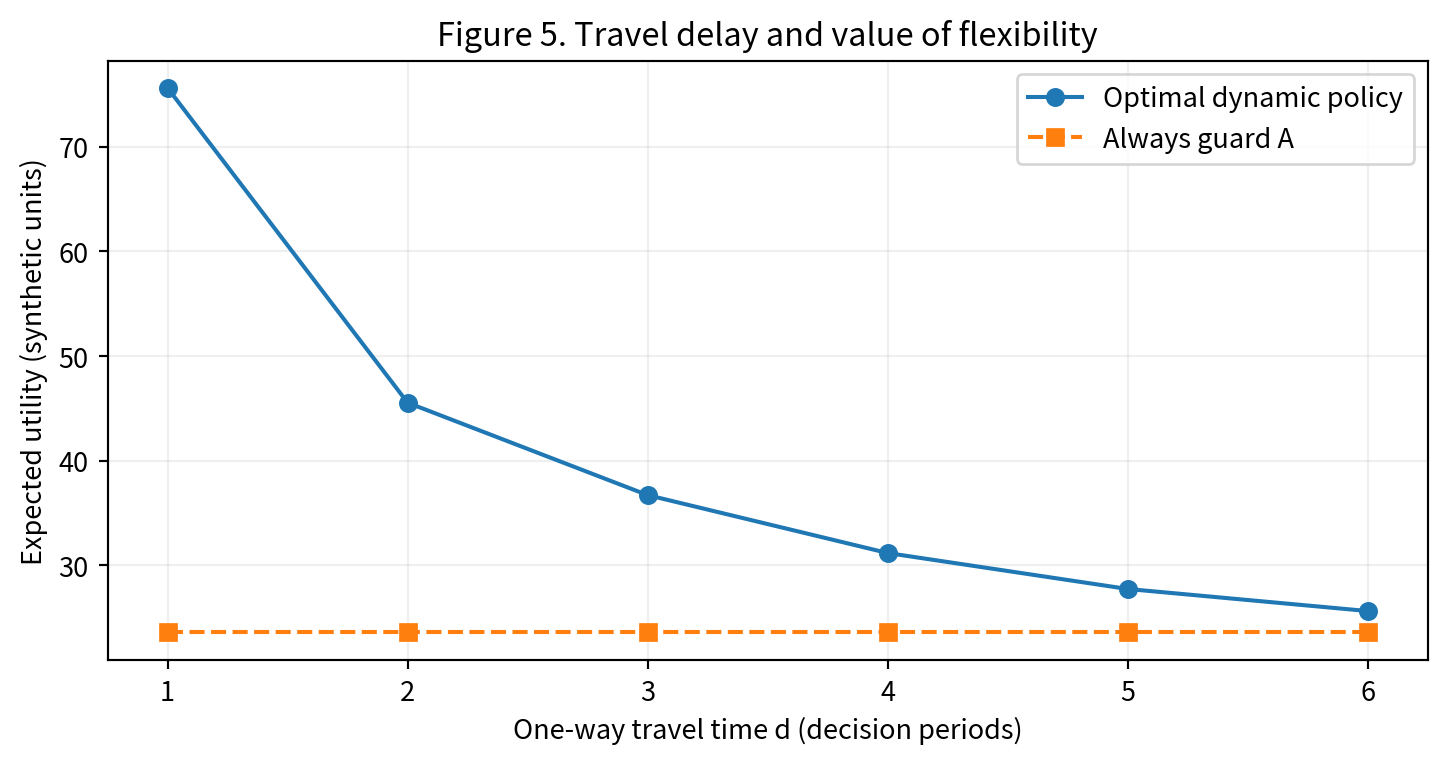
圖 5:單程行程期數與最優策略效用;六個離散 d 值的精確數值結果。
6.6 蒙地卡羅核對及可重現性
圖 6 的圓點是抽樣期望、誤差棒是 95% 常態近似信賴區間、叉號是精確策略評估值。四個精確期望均落在其對應的本次模擬信賴區間內。最優策略 7,000 次模擬平均 45.62、標準誤 0.219;固定留守平均 23.59、標準誤 0.048;固定前往 B 平均 30.31、標準誤 0.371。這種接近支持模擬引擎與精確轉移模型使用相同的回報定義,並不是對真實遊戲規則的驗證。
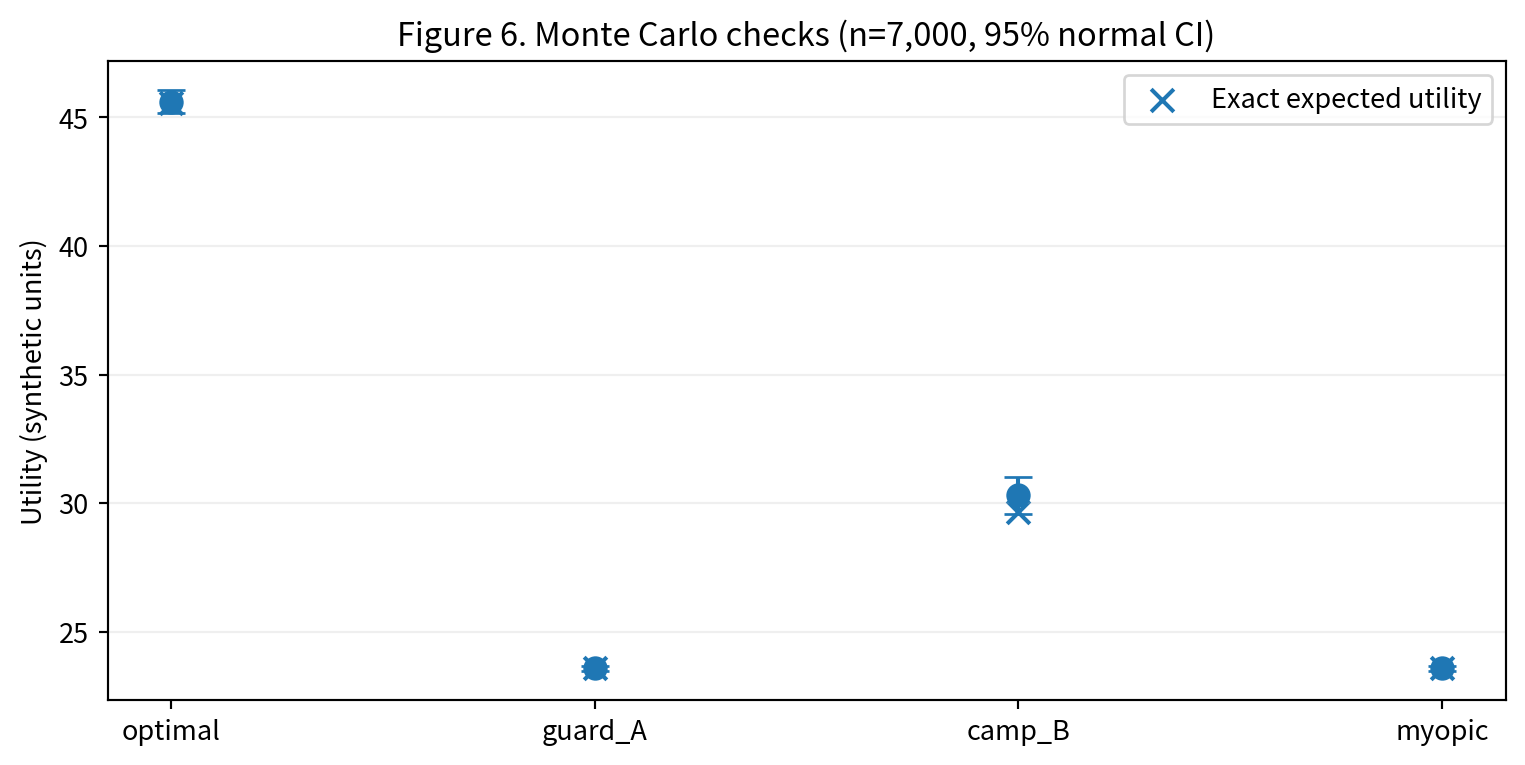
圖 6:四策略蒙地卡羅與精確值比較;每策略 7,000 條合成軌跡,共用種子 20261015。
完整 rollouts.csv 儲存每條軌跡的策略、效用、破塔事件、移動次數及在 B 取得波次的次數;results.json 保存全部輸入參數、精確結果、隨機抽樣統計及敏感度曲線。這使研究結果可以被其他研究者在不取得專有遊戲資料的情況下重現。採用兩種獨立計算方法:一是 Bellman 後向遞推確定效用,二是從每期同一假設機率生成受擊事件;它們的結果吻合是演算法內部一致性的證據。
7. 結果討論(Results and Discussion)
7.1 對研究問題的回答
對 RQ1,命題 2 給出最後一個決策期、可即時抵達 B、塔僅餘一次承受能力的完整充要條件;額外 B 收益須至少補償增加的預期摧塔成本。對 RQ2,圖 2 的區域以及基準最優第一步 x=0→1 顯示,當期途中沒有收入仍可因未來波次而值得啟程。對 RQ3,命題 3 證明精確 MDP 對任意合法對照策略的期望效用弱優越,表 3 則量化本組參數下的效用差。對 RQ4,圖 3 至圖 5 顯示跨線風險與行程延遲改變效用和破塔機率,但不存在由這些圖自動得出的全域簡單線性規則。
7.2 反直覺發現與研究意涵
第一項值得注意的現象是:塔存續機率最低的策略未必具有最大效用;收益與風險的權衡必須明示損失權重 C,而不能假定所有玩家或隊伍都具有相同的風險偏好。在基準設定中,固定留守 A 比最優策略更保守,但因此放棄了大部分 B 線可取得收益。若評估標準改成「最小化塔被摧毀的機率」,本研究的最優策略可能完全不同。
第二項是單期貪婪無法表示跨線行程的期權價值(option value)。需要連續兩期才能抵達 B,而本期移動本身無收入時,只計本期回報的策略可被困於 A。多期規劃透過 V_{t+1} 將未來準時到達的收益反映到今天,使一段當下無收益的移動成為有意義的準備行動。這個差異是本文主題最核心的時間優化機制。
第三項是「跨線收益是否值得」不能只由目標波次平均產出判斷。若 B 線高收益波次在行程結束前已消失,即使其單次獎勵較高,仍可能不值得離開 A;反過來,兩條線的錯位可能形成可循環利用的窗口。這類狀態依賴關係也解釋了為何當風險或路程略有改變時,最優路徑可能由某一時間點突然切換到另一時間點。
7.3 與相關理論之關係
Bellman 原理在本文不只是形式化演算法,而是用來計算出發時間對未來可達收益的邊際貢獻;Puterman(1994)的 MDP 架構提供正確的狀態與轉移語法;Sutton 與 Barto(2018)的序貫價值觀說明為何即期貪婪可能失效;Topkis(1978)則提供日後研究全域門檻時必須檢查的數學條件。本文尚未建立雙方策略競爭的馬可夫博弈,也沒有依據 Shapley(1953)的完整隨機博弈去估計對手均衡;因此對「對手發現我方輪轉就集中攻擊」等因果機制只能列為未來研究。
8. 研究限制(Limitations)
版本及遊戲機制限制。 本研究沒有核實任何特定版本兵線生成間隔、塔攻擊順序、波次收益或英雄走速。抽象期數、損害次數、兩線路徑與假想日曆均不是《王者榮耀》官方數值,亦不能以其他 MOBA 的參數補足。本研究可以作為考察該遊戲輪轉問題的理論原型,不能用來直接建議玩家在第幾秒出發。
敵方行動及聯合決策限制。 敵人並非反應式智能體;團隊支援、視野封鎖、回城、傳送、地圖障礙、野區支援、技能冷卻、金幣對戰力的非線性影響全部省略。若敵方對玩家跨線反應,塔損害機率通常不是單純取決於是否在 A 線;需要使用狀態估計、對抗式控制或隨機博弈。由於研究中沒有將資源收益轉為勝率的效用映射,任何「提升勝率」說法都不獲本研究支持。
統計與辨識限制。 雖然每策略有 7,000 條抽樣軌跡,它們是研究程式依已知分布生成,並非獨立真實玩家樣本。模擬誤差反映假想機率分布下的有限抽樣,不能替代對外部環境的測量誤差估計。若依真實錄影估計 p_U 與 p_D,還應考慮敵人選擇攻塔時機造成的選擇偏差(selection bias),不宜以條件出現率直接作因果效應。
效用及時間限制。 單線每次波次收益固定、傷害以兩次消耗表示、塔損後即終止,可能過度強化或低估局部風險;終端價值設為零使 T 附近的策略偏向短視。未來應測試隨距離連續衰減的行程時間、持續性守塔成本、塔耐久度的連續模型、剩餘戰局價值,以及不同損失厭惡參數下的準則。
9. 結論(Conclusion)
本文提出了一個由《王者榮耀》跨線輪轉問題啟發的有限期隨機動態模型,結合已知而錯位的兩線波次、帶時延的可逆行程、隨位置增加的塔損害風險與一次性摧塔成本。通過明確的 Bellman 遞推、單期風險門檻命題與精確策略比較,研究說明何以有效輪轉需要考慮未來資源窗口,而非只比較當期兩線收益。基準合成情境中,最優策略的效用高於固定基準,並同時承擔高於保守留守的破塔風險;跨線路程愈長時,利用遠方波次的價值在所檢驗網格中迅速下降。六張圖、模擬軌跡、參數檔與程式碼均可重建這些模型內結果。下一階段須取得合法、經授權的真實對局時間事件或影片,以檢驗波次和行程假設、校準塔風險並評估策略對比的外部效度。
參考文獻
Bellman, R. (1952). On the theory of dynamic programming. Proceedings of the National Academy of Sciences, 38(8), 716–719. https://doi.org/10.1073/pnas.38.8.716
Puterman, M. L. (1994). Markov decision processes: Discrete stochastic dynamic programming. John Wiley & Sons. https://doi.org/10.1002/9780470316887
Shapley, L. S. (1953). Stochastic games. Proceedings of the National Academy of Sciences, 39(10), 1095–1100. https://doi.org/10.1073/pnas.39.10.1095
Sutton, R. S., & Barto, A. G. (2018). Reinforcement learning: An introduction (2nd ed.). MIT Press. https://mitpress.mit.edu/9780262039246/reinforcement-learning/
Topkis, D. M. (1978). Minimizing a submodular function on a lattice. Operations Research, 26(2), 305–321. https://doi.org/10.1287/opre.26.2.305
文獻核實說明:Bellman 與 Shapley 的出版頁及 DOI 由美國國家醫學圖書館/PNAS 收錄資料核對;Puterman 由 Wiley 官方書目核對;Sutton 與 Barto 由 MIT Press 官方書目核對;Topkis 由 INFORMS 官方期刊頁面核對。以上書目可追溯,但沒有使用它們為本文假設數值背書。