摘要
陌生隊友即使認為一次合作可以改善團隊收益,也可能因為個人的即時成本、對承諾的疑慮以及無法完全判定隊友是否付出努力,而不能形成持續互惠。此前 HOK-010 推導出可即時核算的自願補償條件,但其假設難以直接套用於存在不可分割優先權、延遲履約及含噪聲表現訊號的合作環境。本文研究兩名抽象隊友之間的重複關係契約:A 在每次合作狀態中選擇私下的高努力或怠工;公開二元訊號的真陽性率為 a、假陽性率為 b;B 在好訊號後承諾交付一份不可分割的資源優先權,其客觀履約成功概率為 q。表現差的訊號觸發固定 L 輪暫停;B 的可驗證故意背約觸發永久關係中止。本文從 Bellman 方程完整推導 A 的隱藏努力激勵約束與 B 的自我履約約束,證明兩者對暫停長度的要求方向相反,從而建立可行整數期限區間、資源履約可靠性上下界與福利最優有限懲罰條件。在完全合成基準 δ=0.9、a=0.8、b=0.4、q=0.9 下,唯有 L=2、3、4、5 同時通過雙邊約束;若取 L=3,解析折現福利為 8.1059,40,000 條固定種子合成路徑提供一致的數值支持。獨立的 Fraction 線性方程系統重算所有 31 個整數期限,解析誤差低於 6×10⁻¹⁵。研究證明延長懲罰並非必然促進合作,提高履約成功率亦未必提高合作可行性。結果只對所界定的公眾可驗證資訊環境成立,並不推斷遊戲內具有契約功能,亦不解釋實際玩家行為比例。
**關鍵詞:**重複博弈;公開不完美監督;關係契約;非貨幣補償;激勵相容;有限期懲罰
1. 引言:合作承諾的雙重可信性問題
多人競技環境的合作同時包含一個事前決定與一個事後決定。第一個決定是隊友 A 應否承擔支援成本;第二個決定是已得到支援的隊友 B 應否兌現日後的資源分配承諾。若支援努力可觀察並且優先權具有可強制執行的契約,研究可簡化為普通的成本收益比較。然而當努力隱藏,B 只能觀察一個可能出錯的公共績效訊號,便產生道德風險(moral hazard)。當 B 可以在訊號出現後任意背約,則再發生關係契約(relational contract)的自我履行問題。這兩個偏離機會處於不同時間,須分別建立約束。
本文選擇《王者榮耀》作為合作語境,而非直接建模其某項未經確認的特殊機制。例如,把「下一次合作機會的優先分配」抽象成一份不可分割的優先權,能夠描述團隊內部分配的規範或默契;它不等於遊戲內有可轉讓的貨幣、可鎖定的道具擁有權,亦不保證官方系統允許此類合約。模型的時間單位是一個抽象的互惠機會,不對應固定秒數或真實對局分鐘。這種抽象化讓我們集中研究履約誘因,但也明確縮小實際可套用的範圍。
既有 HOK-006 至 HOK-010 研究曾處理聯盟合作、分區外部性、接收方否決、最低補償與策略虛報,其主要效用比較屬單期而且假定補償量可核算。本研究轉向無法事前觀察努力、沒有可任意分割的補償量及缺乏外部強制執行的新環境。兩名參與者不必形成可永久固定的聯盟;所謂聲譽是公開歷史對未來合作可能性的影響,而非預先假設存在某個可下載的玩家信譽評分。
本文的研究問題有三個。RQ1:對隱藏努力者而言,不準確訊號和未來暫停會如何改變合作的激勵條件?RQ2:對資源讓與者而言,何種折現價值足以阻止對好訊號的故意背約?RQ3:當懲罰期限及成功履約概率可以變化,會否出現兩邊同時有誘因的非空區間,以及與總福利之間的衝突?本文的研究目標是求出完整必要充分條件,對極端參數作嚴格檢查,並用可重現程式驗證解析結果。
在形式化之前列出可被推翻的假說。H1:在 A 從合作持續取得正預期價值時,延長暫停增加 A 的努力激勵。H2:在 B 的合作期收益為正時,延長暫停削弱 B 的履約激勵,故聯合可行性未必隨懲罰期單調。H3:當非貨幣報酬的交付概率 q 上升,A 與 B 的激勵約束會朝相反方向移動。H4:在雙方合作期總收益為正的情形中,最短可行暫停期使折現總福利最大。後文以命題與反事實計算區分已證明和僅由合成數據展示的部分。
本文貢獻不是宣稱發現新的重複博弈一般定理,而是在單一可核算的公開監督關係契約中,把不可分割報酬、獨立交付成功率、私人努力與履約者的可驗證背約結合起來。得到的封閉式區間可讓讀者逐一查驗各項假設。相較以一般民間定理直接聲稱「玩家有耐心就能合作」,本研究僅在明確的二元動作、三類公開歷史及指定懲罰協議下聲稱可以支持這一候選公開策略均衡。
2. 文獻回顧與理論定位
Green 與 Porter(1984)在不完美價格資訊下研究自我維持的合謀,突顯不良共同訊號可能令守規矩的參與者同受懲罰。本文借用這個不完美公開訊號下的懲罰直覺,但研究情境改為一對合作隊友的努力和分配承諾,並非產業定價。由此,公開訊號 y 不等同於真實行動 e,甚至在所有參與者均守約時仍有機會發出壞訊號。
Abreu、Pearce 與 Stacchetti(1990)研究在不完美監督下折現重複博弈的均衡價值和自我生成的可達效用集合;其一般方法遠超本文固定期限的雙狀態承諾機制。本文不援引其一般均衡集合結論作為現成保證,只使用 Bellman 分解及一次偏離原理對特定候選策略逐歷史檢查。這避免把「存在某類均衡」混淆成「任意明示的有限期懲罰皆為均衡」。
Fudenberg、Levine 與 Maskin(1994)建立不完美公開資訊下的民間定理,其成立取決於訊號對不同個體偏離的識別條件,以及足夠耐心等前提。本文的有限二人機制未驗證該文所有一般識別條件,因此不把它視為本文模型任何參數下必有均衡的證明。相反,我們以確切不等式指出哪些參數不能維持合作;尤其會展示折現率和履約概率的可行性分界。
Baker、Gibbons 與 Murphy(2002)研究關係契約如何受事後背約誘因制約;Levin(2003)分析自我履行激勵合約、資訊問題與有限種類報酬的作用。本文的 B 是具獨立履約權的行動者,承諾能否執行受其自身未來利益限制,而非只受 A 是否願意努力影響。這是本文「雙邊激勵相容」的經濟學基礎,但數值中的優先權、成功概率與固定暫停規則都是自行明示的建模選擇,不是上述文獻的實測參數。
與 HOK-010 對照,最低可補償值的單期不等式把補償當成可精確支付的數量;本研究的補償 r 只能取 0 或 1,成功交付時 A 取得整份價值 v,B 承擔整份機會成本 k。不存在選擇任意金額 t 的自由。當成功機率 q 不足時,承諾一份優先權與真正令 A 受益是兩件事;當 B 故意拒絕時,單期可節省成本與未來失去合作的比較則決定是否可信。這不是把舊模型中的 t 直接代換成 qv 就能完成的問題,因為讓與者亦面對一個動態約束。
3. 問題建構與可檢驗的假設
考慮無限離散期 t=0,1,2,...,折現因子為 0<δ<1。參與者 A 是有成本的努力提供者,參與者 B 是有權決定是否讓出一份未來合作機會優先權的受益者。每期開始有三種公開關係狀態:合作 C、暫停 P_j(剩下 j 輪,j=1,...,L)、永久終止 D。P 期二人不生產本文所建模的增量合作收益,不能由任何單方行動獲得正的額外收益;D 期的外部選項亦規範化為每輪零收益。為簡化重點,本文沒有讓不同聯盟間持續競逐、沒有玩家進退場,也不對其他三名隊友的外部性作值估計。
在 C 中,A 私下選擇 e∈{0,1},其中 e=1 為高努力,成本 c>0;e=0 為低努力,成本零。B 在高努力時得到每期預期增量收益 g>0,在低努力時為零。這項 g 是在未公開個別努力結果之前的期望效用,並不意味 B 能從單期收益無誤反推 e;其本身的實現擾動並未另立為可以驗證努力的新訊號。公開績效 y∈{0,1} 在 A 選擇後發生,Pr(y=1|e=1)=a、Pr(y=1|e=0)=b,假定 0≤b<a≤1。每期訊號在條件於當期努力後獨立,雙方知道 a 與 b。若 y=1,B 預先約定要嘗試給出一份優先權;若 y=0,本期不作讓與。
優先權只可以全部給予或不給予,不能拆成金額或半份:當 B 公開地選擇兌現時,以概率 q∈[0,1] 實際成功交付;成功時 A 收益 v≥0,B 機會成本 k≥0;失敗時二人就此權利所得為零。B 的嘗試/拒絕行動可公開驗證,而且嘗試後的外生失敗原因亦可被公開核實;故公眾能識別一次外生失敗和一次故意拒絕。這是很強、尚無遊戲實證根據的資訊假設,卻可清楚區分「可靠性 q」與「蓄意背約」。外生失敗後不額外懲罰 B。
若在 C 中出現 y=1 且 B 嘗試履約,下一期仍是 C,無論優先權實際是否交付;若 y=0,下一期進入固定 L 輪 P,期滿自動恢復 C。若在 y=1 時 B 可驗證地故意拒絕,下一期轉入 D 且永不恢復。當 L=0,壞訊號不造成暫停,即下一期直接回到 C。遵循契約的 A 在每次 C 都採 e=1;B 只在 y=1 嘗試交付;其他狀態均不從事被建模的增量交換。A 的怠工不可直接查獲,故策略只能依據公開訊號作調整。
| 符號 | 定義及取值 | 模型上的作用 |
|---|---|---|
| δ, L | 0<δ<1;L 為非負整數 | 折現耐心;壞訊號後暫停長度 |
| a, b | 0≤b<a≤1 | 高努力真陽性、低努力假陽性 |
| q | 0≤q≤1 | 誠信嘗試後獨立成功交付概率 |
| v, k | 均非負 | 優先權完整交付時 A 的價值、B 的成本 |
| c, g | c>0、g>0 | A 高努力成本、B 的預期增量收益 |
| V_A,V_B | 合作狀態折現價值 | 二人相對 D 外部選項的續存收益 |
| D_L | Bellman 折現分母 | 含好、壞訊號的續存概率 |
表 1:所有數值均為理論參數,未以《王者榮耀》實況作單位校準。
上列約束也限定均衡概念。A 的努力是不可觀察的私有行動;B 的支付決定發生於公開的 y=1 後。此擴展式公開歷史博弈允許對 A 的私下努力考慮一次偏離,並在任何公開狀態要求無利可圖的單方偏離。外生的 P、D 不存在可由單人重新開啟合作的偏離動作。若有人希望用此模型預測真實排位中的「掉線」「意外失敗」或訊號操縱,必須另建一個無法辨別外生失敗的貝葉斯模型,不能套用本文的結論。
4. Bellman 模型與第一階段推導
在所有人遵循擬議策略時,合作 C 的每期預期收益分別為 u_A=aqv−c、u_B=g−aqk。二者都必須扣除權利成功交付的機率 q;把 q 當成 B 的單方道德傾向會混淆外生技術故障與策略選擇。公開訊號 y=1 的概率為 a,於是下期回到 C;訊號 y=0 的概率為 1−a,隨後歷經 L 輪沒有增量收益的 P,之後再回 C。
令折現分母 D_L=1−δa−(1−a)δ^(L+1)。因 δ<1 且 a≤1,D_L>0。移項並除以正的 D_L,得出二人的完整合作狀態價值:
兩式可追溯到每期期望收益與公開狀態轉移。當 L=0 時 D_0=1−δ,恰是沒有訊號懲罰的普通永續年金;當 L 變長,低訊號後返回 C 的價值受更強折現。由於讓與是不可分割的二元選擇,這裏的「期望」來自 Bernoulli 交付風險,而非可以每輪轉讓 q 份優先權;兩種制度在單次決策上不可互換。
命題 1(完整合作價值與自願參與)。 若上述公開規則被遵循,合作期的期望折現價值必為上式。以永久 D 的零效用作外部選項,A、B 願意在 C 參與的必要充分條件分別為 aqv≥c 與 g≥aqk。
證明。 Bellman 式構成一個收縮的仿射方程,係數 δ[a+(1−a)δ^L]≤δ<1,故固定點唯一。除以 D_L 得值函數。因分母正,續存價值非負當且僅當分子非負。此命題只檢查在起始 C 的參與,並沒有涵蓋每個可選行動的激勵相容,後面必須另行檢查。證畢。
在 C 選擇高努力時,好訊號帶來成功優先權的當期預期價值 aqv;選擇低努力時變成 bqv。其差額為 (a−b)qv。重要的是,兩種努力也改變下一期進入 C 或 P 的概率差 a−b;一次私下怠工比一次高努力更容易令整段未來合作被暫停。高努力帶來的下一期續存價值優勢為 δ(a−b)(V_A−δ^L V_A)。比較兩個行動便得到第一個動態條件。
命題 2(努力激勵的必要充分條件)。 在 B 按約定行動、公開狀態轉移如上,且 P、D 各自不存在可盈利單方偏離的設定下,A 每輪在 C 選擇高努力當且僅當 M_A(L)≥0 才符合序列最適反應。此條件包括未來暫停效應,與參與條件不同。
證明。 固定其他參與者的公開策略,在合作狀態比較本期 e=1 與 e=0 的期望總報酬。B 對 y=1 的讓與策略相同,故當期差額為 (a−b)qv−c;兩個行動對下一期 C 的概率差為 a−b,而從壞訊號引起 L 期 P 後重返 C 的折現價值是 δ^(L+1)V_A。兩個差額相加恰為 M_A(L)。這個有限行動、折現完備且遵循指定公開狀態策略的動態問題滿足一次偏離原理;若每個公開 C 的同一不等式成立,連續偏離不會嚴格提高價值。若不等式不成立,單次怠工已是有利偏離。證畢。
對 B 而言,已觀察 y=1 時,A 本期的努力與 B 已取得的產出增量皆為過去的沉沒事項。B 若兌現,成功讓與概率 q 導致當期預期成本 qk,下一輪仍可進 C;若故意背約,可節省這項成本,卻令下一輪永久失去合作價值 V_B。B 的激勵約束必須在此歷史後的決策節點檢查,而不能直接使用事前合作價值正負來取代。
命題 3(可驗證履約的自我強制)。 在 y=1 的公開歷史之後,B 願意誠信嘗試讓與當且僅當 M_B(L)≥0。若再同時有命題 1 的參與條件與命題 2 的努力條件,此指定公開歷史策略構成所述簡化博弈的公開策略均衡。
證明。 比較 B 本期兌現或拒絕的條件期望效用。共同已得收益抵銷;兌現令其成本期望為 qk 並保留 δV_B 的明日價值,拒絕使未來回報規範化為零,得差額 M_B(L)。在 y=0 無交付義務、P 與 D 無有利單方動作,以及 A 的私人努力沒有額外私有記憶收益的指定環境中,已檢查所有可能產生有利單次偏離的決策節點。結合一次偏離原理可得所稱均衡。若外生交付失敗不可證實,B 可能冒充失敗,則此命題的資訊前提失效。證畢。
這三個命題說明:單期合作有正的總收益並不足夠。假若 A 的工作成本過高,A 可能從未來合作中得到正收益,仍偏好當期怠工;假若 B 的機會成本過高,B 即使整體持續合作受益,亦可能在好訊號之後不兌現。只有將 A 的事前不可觀察行動與 B 的事後可驗證決定分開檢查,才能得出可信合作的條件。
5. 理論分析:期限區間與可靠性的反直覺效果
以下只討論 u_A>0、u_B>0、a>b、qk>0 的內部情形;當任一方 u_i≤0 或補償成本為零時,應直接使用命題 1–3 的一般非嚴格不等式,不把內部比較靜態結論硬套到邊界上。為分析 L 的變動,令 x=δ^L、H=1−δa,則 D_L=H−δ(1−a)x。隨 L 上升,x 嚴格下降;因此 D_L 非減少。令 T_L=δ(1−δ^L)/D_L 表示對 A 的延遲懲罰力量,容易從商數微分取得對 x 的導數。
命題 4(兩種激勵對期限的相反單調性)。 若 a<1 且 u_A>0、u_B>0、a>b、qk>0,則 M_A(L) 隨 L 嚴格上升,M_B(L) 隨 L 嚴格下降;雙方可接受的非負整數 L 形成一段連續整數區間,或為空集。當 a=1 時,壞訊號在高努力下從不出現,V_i 不隨 L 變化,而 A 的偏離威懾仍可隨 L 上升;需使用弱單調說法。
證明。 把 V_A=u_A/D_L 代入 M_A,可寫成 (a−b)[qv+u_A T_L]−c。因 x 隨 L 下降、上一導數為負,T_L 隨 L 上升,且 u_A(a−b)>0,因此 M_A 嚴格上升。另一方面 M_B=δu_B/D_L−qk;當 0≤a<1 時 D_L 隨 L 嚴格上升,而 u_B>0,故 M_B 嚴格下降。每個不等式在整數 L 上各指定一個上射線或下射線,其交集只能是整數區間。證畢。
命題 4 實際上揭示「愈嚴厲的懲罰」有兩種反向後果。它能提高 A 對隱藏努力的重視,卻同時降低 B 在誠信履約後能保留的未來價值;當 B 在接收本期績效後決定是否背約時,過長暫停代表未來回報較少,故即使 B 的守約成本不變,B 也可能開始背約。這種相反單調性不是心理態度的推定,而是相同 Bellman 分母同時進入兩個不同激勵條件的數學結果。
命題 5(最短可行懲罰是折現福利最優)。 在符合上述內部條件、u_A+u_B>0、非空可行整數期限集合 F 的前提下,最大化兩名參與者合作期折現效用 V_A+V_B 的解為 L*=min F。
證明。 折現總福利 W_L=(u_A+u_B)/D_L,分子與 L 無關且為正。當 a<1,D_L 隨 L 嚴格上升,故 W_L 嚴格下降;於可行集合內,第一個可行 L 最好。若 a=1,所有可行期限的合作路徑下福利相等。這是給定公開策略類別下的限制最適解,並未證明在全部可能的歷史依賴契約中也是全域最適。證畢。
為得到 q 的明確界線,固定 δ、a、b、v、c、k、g、L,其中 a>b、v>0、k>0。設 T=δ(1−δ^L),並注意 D_L 不依賴 q。A 的努力條件展開為 (a−b)[qv(1+aT/D_L)−cT/D_L]≥c,整理得 q≥q_A。B 的履約條件則等價於 δg≥qk(D_L+δa)。因 D_L+δa=1−(1−a)δ^(L+1),得到 q≤q_B。再聯合兩方參與條件與物理概率界,形成封閉區間。
命題 6(交付可靠性的雙邊界限)。 固定上述內部參數與一個非負整數 L,指定策略可維持合作當且僅當 q 落在以下閉區間內:下界為 max{0,q_A,c/(av)},上界為 min{1,q_B,g/(ak)};若下界大於上界則不可行。A 的努力激勵在 q 上嚴格增加,而 B 的履約激勵在 q 上嚴格減少。
證明。 前兩個 q 邊界依次來自命題 2、3 的移項;後兩個內部界限來自命題 1 的個人參與,且兩個概率界限來自 q∈[0,1]。它們皆為一次不等式,故交集正是所述區間。分別對 M_A 與 M_B 求 q 導數,得到 (a−b)v[1+aT/D_L]>0 與 −k[1+δa/D_L]<0。證畢。
這一命題反駁「補償越可靠,合作必然越穩」的直覺。當 q 太小,A 即使得到承諾亦沒有足夠努力誘因;當 q 太大,B 預期會更常真正付出機會成本,反而可能不願承諾兌現。如果優先權對 B 完全沒有成本,即 k=0,這個上界來源消失,不能再宣稱同一反直覺結論。可靠性與背約率也應分開:本文 q 僅代表 B 已守約時的外生成功率,不能以現實資料中「承諾未成」的總頻率直接估計 q。
命題 7(公開訊號的辨識限制)。 在其他參數固定時,若 b 上升但 a 不變,A 的努力激勵 M_A 嚴格下降,B 的履約條件、雙方遵約狀態的折現價值以及每合作期的錯誤懲罰率均不變。若 a=b,無任何有限 L 能以此訊號改變 A 的努力誘因,除非 c=0。
證明。 只有 M_A 中的乘數 a−b 隨 b 改變,且在 u_A>0 時方括號內為正,故導數嚴格為負。遵約路徑採 e=1,公開訊號分布只取決於 a,故 V_A、V_B、M_B 及錯誤懲罰概率 1−a 不含 b。若 a=b,選擇 e=1 與 e=0 造成完全相同的可觀察訊號分布,A 的全部預期報酬差為 −c<0,無法以公開策略誘導高努力。證畢。
6. 合成數值實驗與獨立精確核實
全部數值是假設參數,用於證明指定模型可以具體計算及產生非空聯合可行區間;沒有使用任何遊戲 API、玩家行為檔案或版本資料。主程式使用 Python 浮點 Bellman 封閉式、31 個整數期限、δ×q 網格、訊號誤判網格及蒙特卡羅;另一份互不匯入對方計算函數的程式,以 Fraction 消去法直接解含合作及各暫停狀態的完整線性系統。圖中的縱軸數值為抽象效用單位而不是勝率百分比。表 2 統一列出可重現基準。
| 參數 | δ | a | b | q | v | c | k | g |
|---|---|---|---|---|---|---|---|---|
| 基準(假設) | 0.90 | 0.80 | 0.40 | 0.90 | 4.00 | 1.80 | 0.70 | 0.63 |
表 2:此列 8 個數值全部為研究者指定之合成參數,並非遊戲測量值。
在此基準,u_A=0.8×0.9×4−1.8=1.08,u_B=0.63−0.8×0.9×0.7=0.126,兩個參與條件均成立。沒有暫停時,A 的努力差額只有 (0.8−0.4)×0.9×4−1.8=−0.36,因此單純每次好訊號給予優先權還不足以誘導努力。然而延長暫停期產生繼續合作的價值差額:從 L=2 開始 A 願意高努力,到了 L=6,B 因為失去過多續存價值而不願再承諾。完整的 L=0...30 計算顯示唯一聯合可行期限為 2、3、4、5;不是只由肉眼觀察幾個抽樣點而判定。
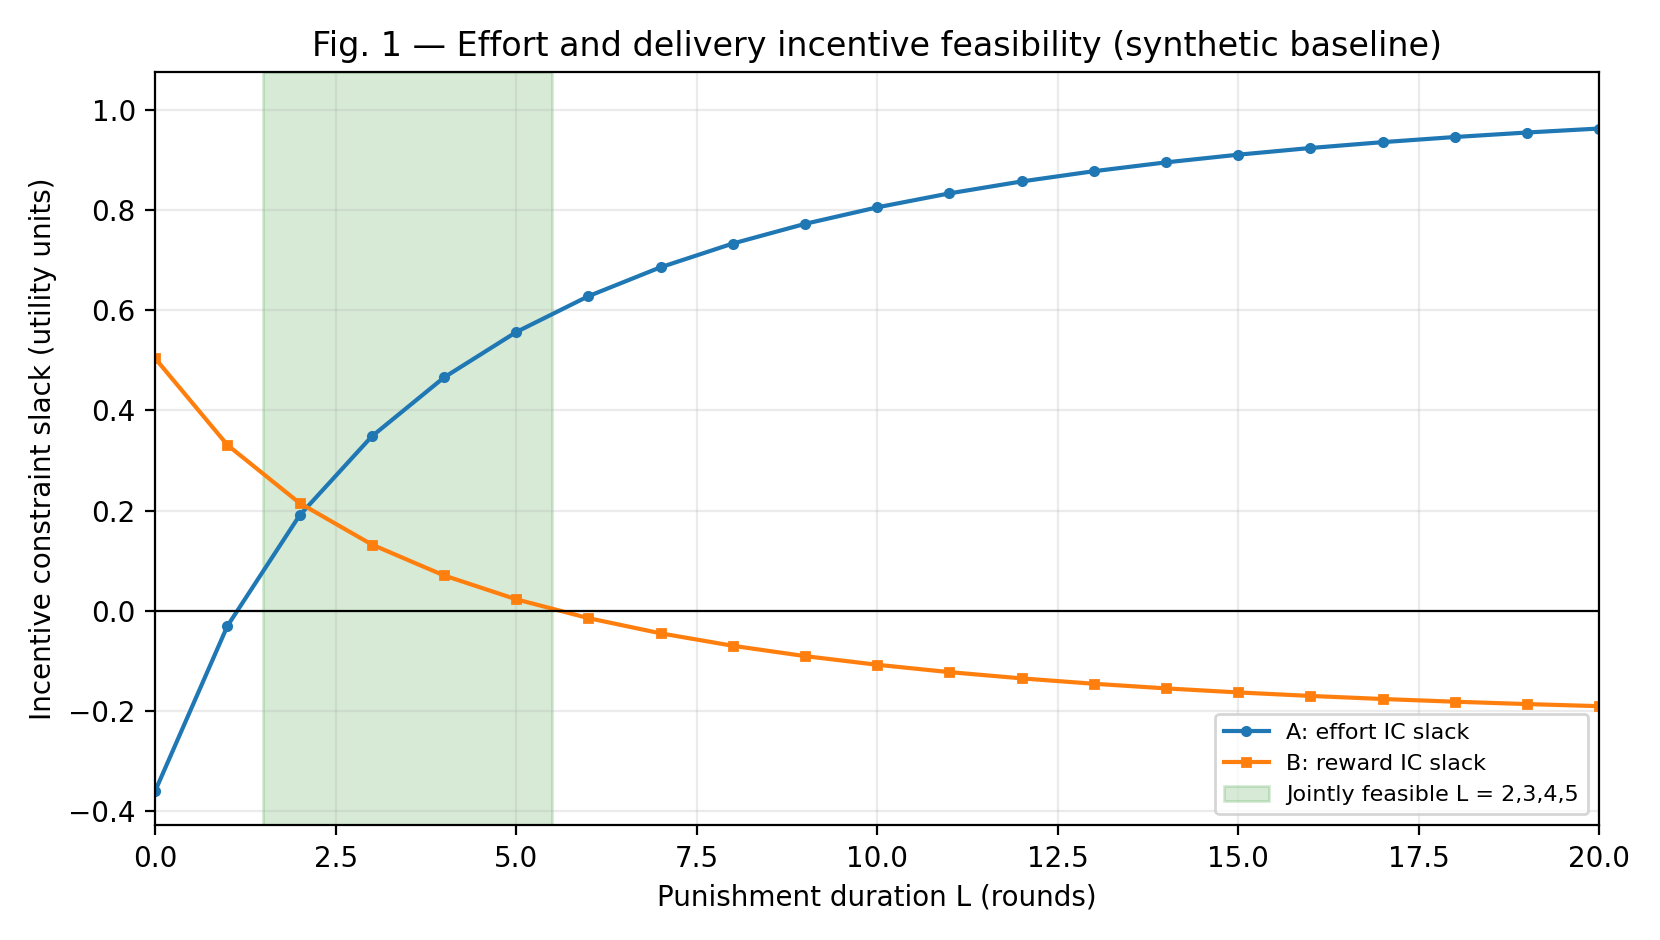
圖 1 清楚顯示兩條激勵餘額曲線的不同方向:A 的餘額由負轉正,B 的餘額由正轉負。零水平線以下意味該方存在有利的單次偏離;因此不能只看某方未來收益為正便斷定合約可信。為讓讀者複核精度,表 3 特別列出 L=3 的精確 Fraction 結果與浮點近似。
| 量 | 獨立精確有理數 | 小數近似 |
|---|---|---|
| D_3 | 7439/50000 | 0.14878 |
| V_A | 54000/7439 | 7.25904 |
| V_B | 6300/7439 | 0.84689 |
| A 努力餘額 | 12951/37195 | 0.34819 |
| B 履約餘額 | 98343/743900 | 0.13220 |
表 3:獨立 Fraction 高精度解算及同參數浮點交叉核對;正的兩項餘額表示兩方都沒有嚴格偏離誘因。
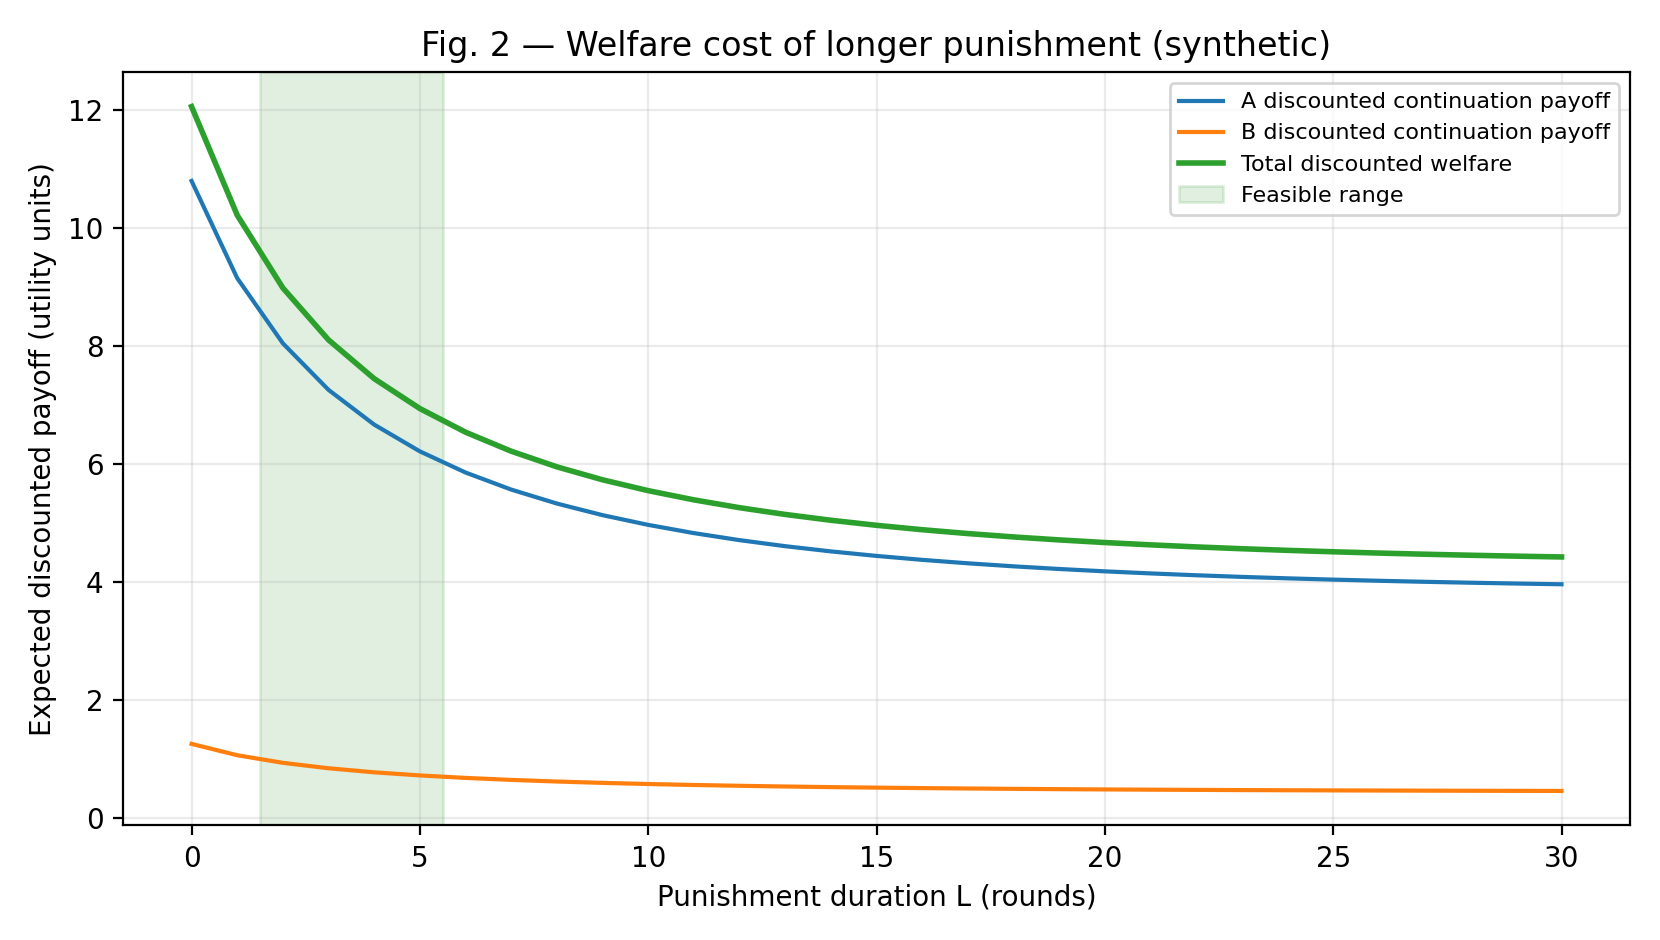
在 L=3,V_A+V_B≈8.10593,而平穩合作狀態的出現比例只有 1/[1+3(1−0.8)]=0.625。這個 0.625 是模型 Markov 更新週期下的長期占用比率,不能當成實際玩家合作成功率。由此計算的穩態平均每期增量福利為 0.625×(1.08+0.126)=0.75375。圖 2 顯示隨懲罰期延長,兩個正的合作期效用均因機會中斷而折現,且在共同可行集合內 L=2 的總福利最高。請注意,圖 2 的折現福利不是單期平均福利,兩者分母與經濟意義不同。
進一步固定 L=3,根據命題 6,A 的努力條件要求 q≥0.80585199,B 的履約條件要求 q≤0.93234190;參與條件在此區間內不再收緊界限。因此 q=0.60 雖使 B 易於守約,卻不能使 A 願意出力;q=1.00 雖使 A 希望合作,卻令 B 願意故意拒絕。q=0.90 在區間內,兩方可同時守約。這是由模型所證的區間與基準合成參數得到的數值例子,並非玩家對優先權可靠性的實測偏好。
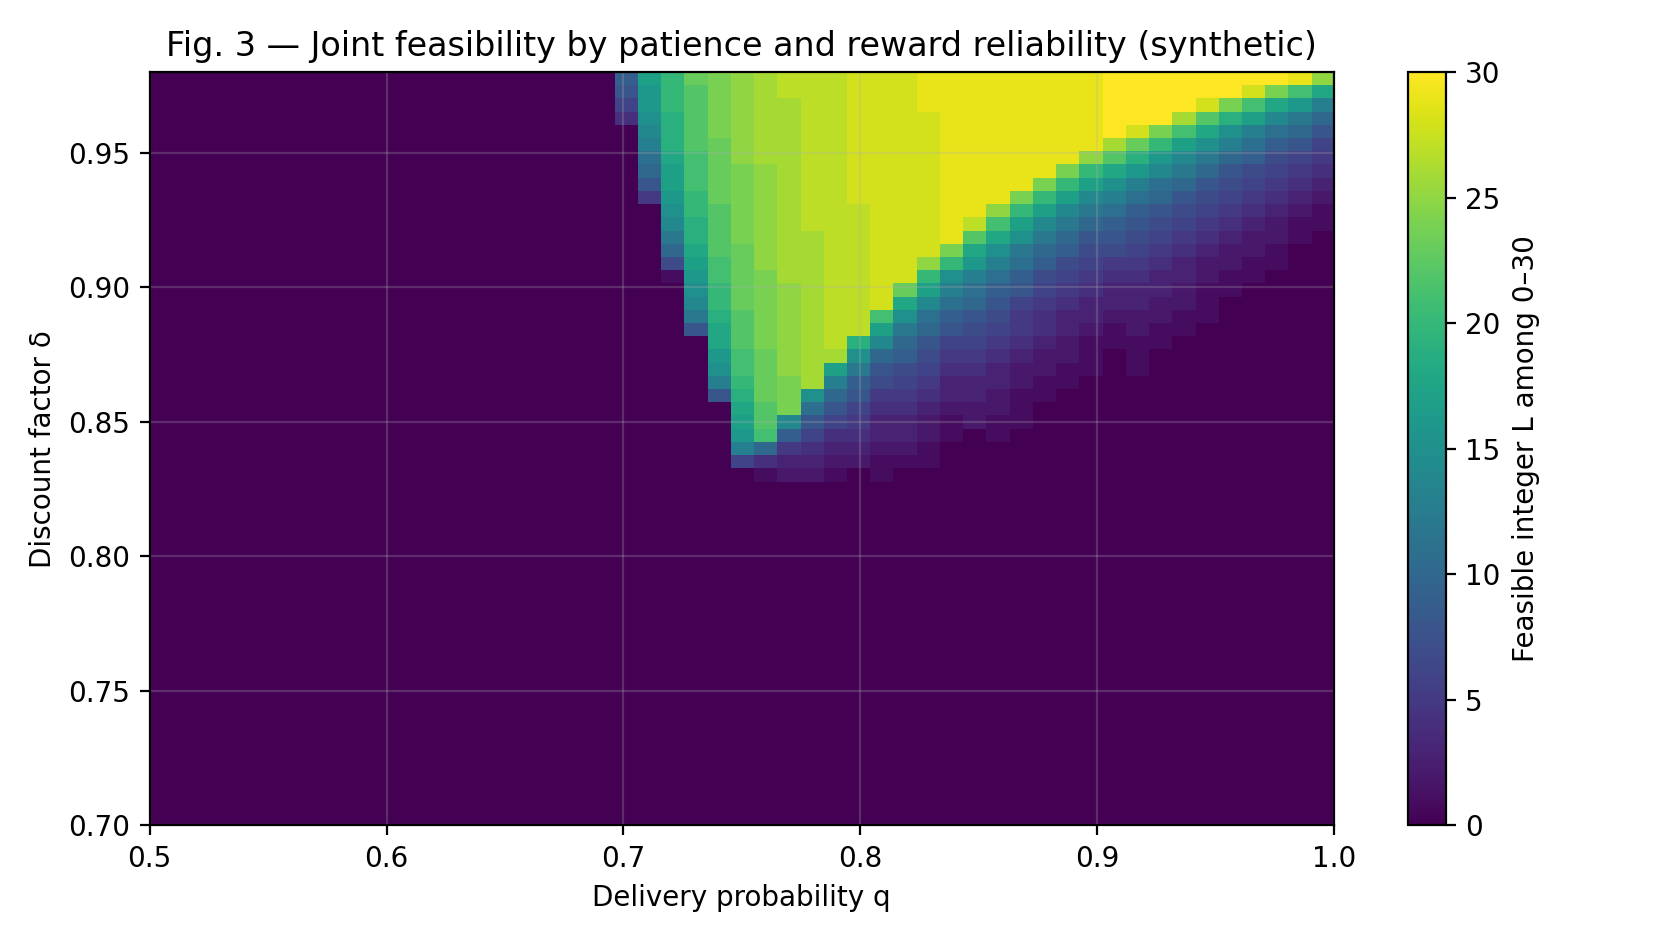
圖 3 對 57 個 δ 值及 51 個 q 值,共 2,907 個參數組逐一檢查 0 至 30 的所有整數 L。顏色代表在列入的期限集合內有幾個能滿足全部參與和激勵約束,顏色為零則在已檢查 31 個期限中無可行期限;不能將「有限網格上零個」誇張為所有大於 30 的期限都絕對不可行。此圖提供了一項可視化檢驗:提高折現因子可能令維持長期合作更具價值,但也可能影響訊號懲罰成本,因此可行域具有制度邊界,不等於一條簡單的普遍上升直線。
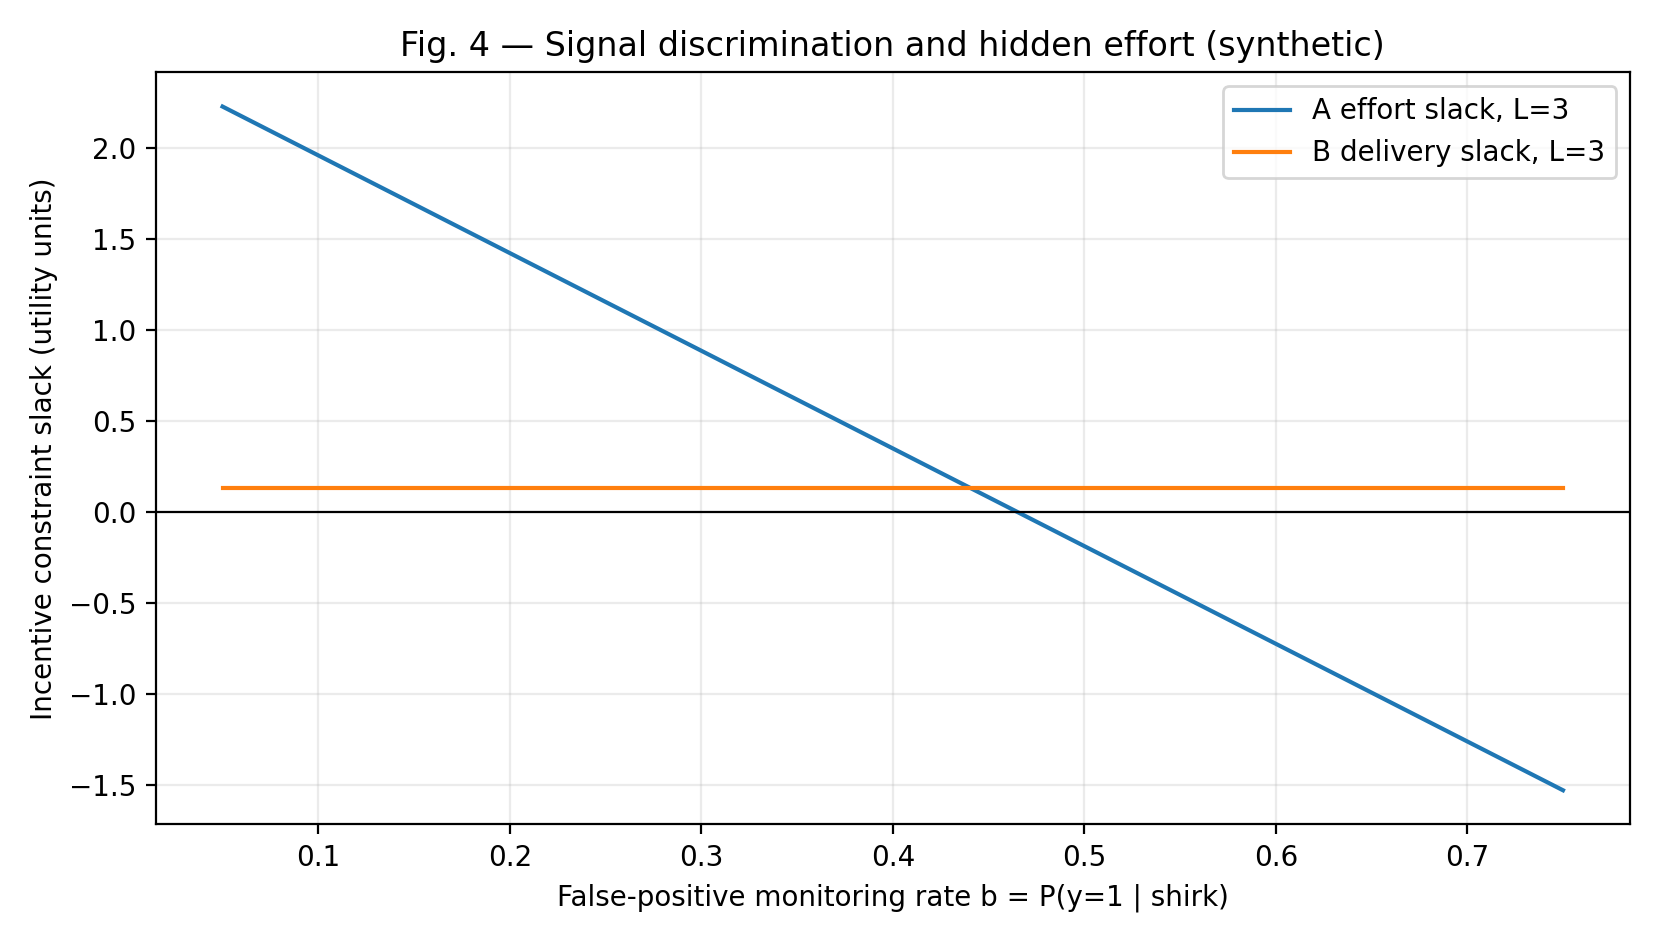
圖 4 固定 a=0.8,令 b 從 0.05 到 0.75 變動。因 b 只表示低努力仍產生好訊號的機會,增加 b 在高努力遵約路徑上不改變 B 的成本或訊號好壞分布,卻降低 A 高努力相對怠工的價值,與命題 7 一致。相反,若研究者把 a 與 b 同時改動成更不準確的觀察系統,就可能連 B 的折現續存價值及好訊號頻率都改變;這是不同的比較靜態實驗,不能用圖 4 的結論直接取代。
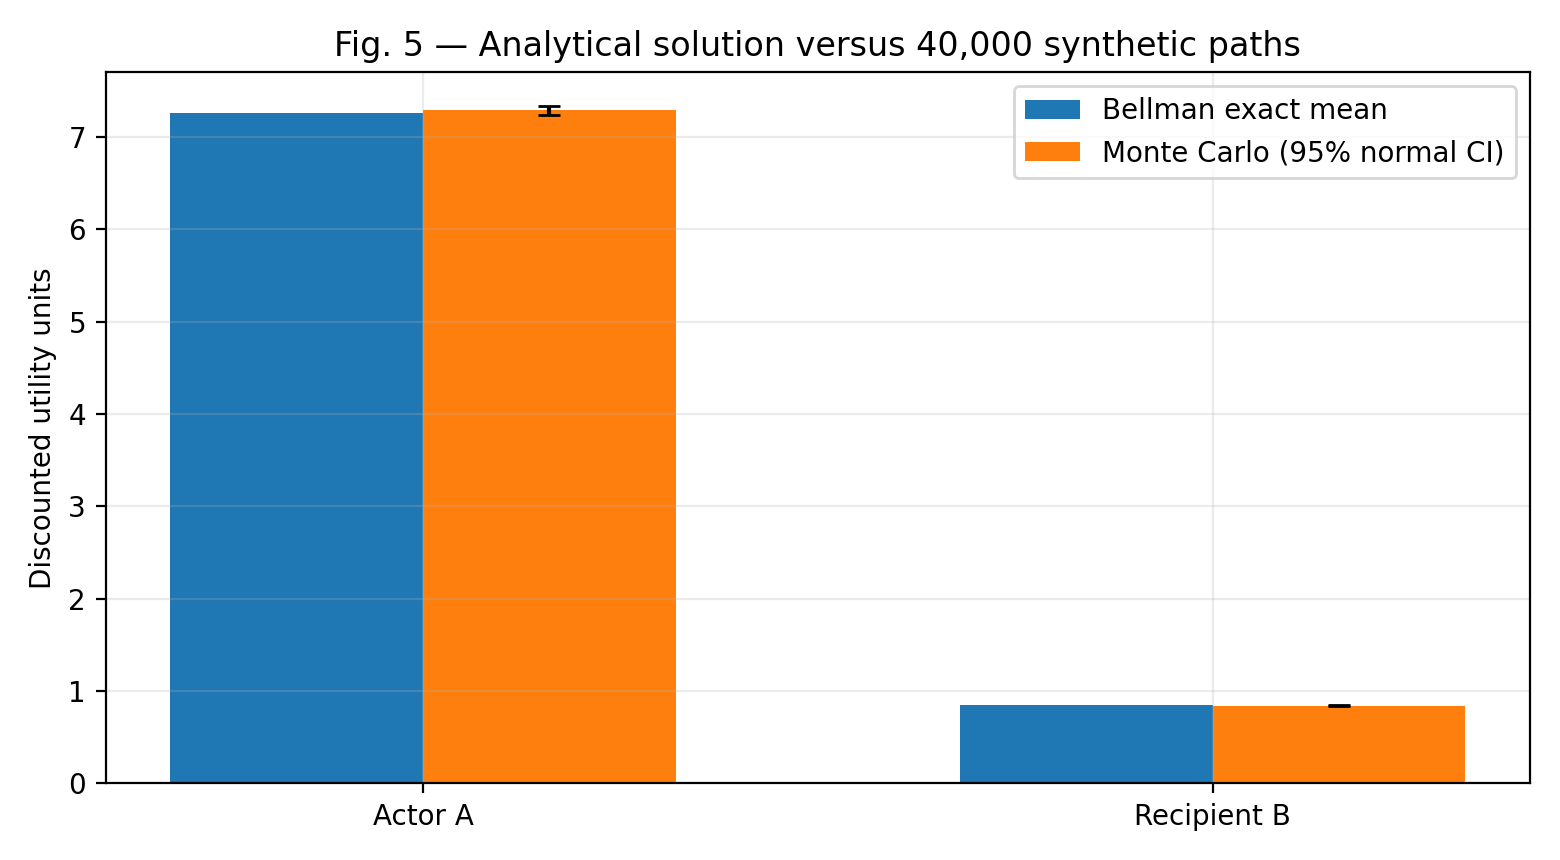
在 L=3 下,執行 40,000 條各 180 期的合成合作路徑,隨機種子為 20261015。A 的平均蒙特卡羅折現報酬是 7.28726,標準誤差 0.02329;B 為 0.84277,標準誤差 0.00245。解析值 7.25904 與 0.84689 都落在對應均值的常規約 95% 正態置信區間內。由於 δ=0.9,截斷在 180 期的最大可能尾部回報極小,此比較主要檢查隨機轉移和交付實作是否與 Bellman 公式一致;它完全不能證明真實玩家適用任何假設值。
| 驗證對象 | 內容 | 結果 |
|---|---|---|
| 期限枚舉 | L=0 至 30,共 31 種 | 共同可行 2、3、4、5 |
| 完整狀態獨立解 | C、P1 至 PL 的 Fraction 高斯消去 | 與封閉式誤差 <6×10⁻¹⁵ |
| 耐心×交付成功 | 57×51=2,907 組,逐組 31 種期限 | 已輸出格點 CSV |
| 訊號識別敏感度 | 71 個 b 值,固定 a 與 L | A、B 餘額方向符合命題 |
| 路徑實驗 | 40,000 路徑、每條 180 期、固定種子 | 理論值落在抽樣 95% 區間內 |
表 4:所有可重現數據均標記為 synthetic。獨立檢驗的最小數值誤差只對已列出的有限計算任務成立,不能代替一般數學證明。
7. 結果與討論:兩方承諾與公共訊號的制度取捨
這一研究最有意義的結果是:在同一條合作關係中,兩名參與者需要不同強度的聲譽威懾。A 的行為難以觀察,如果壞訊號毫無後果,即使 B 願意分出一份完整優先權,也可能不足以抵消 A 的即時努力成本。然而 B 對自己的履約行動具有決定權;如果規則長期讓關係陷於暫停,B 的未來互惠獲益下降,就可能更願意保留當次優先權。於是有效制度需要兩個單獨的條件,而不是一個抽象的「團隊合作程度」。
結果也指出對局事件的可驗證性比一個籠統的信任分數更關鍵。高努力不能被直接公開查出,只能透過 y 的概率分布提供有限誘因;另一方面 B 故意拒絕承諾必須可查證,永久停止互惠才有可能構成對 B 的可信懲罰。只要外生交付失敗與背約在觀察上混合,B 就可能用「未成功」掩蓋「未嘗試」,本文的 B 約束失去辨別基礎。引入錯誤判斷 B 的假陽性或誤報,可能導致額外聲譽損失和錯殺合作的情況;後續研究有必要建立貝葉斯後驗與容錯治理,不能把此限制當成小的技術細節。
在公共績效訊號的治理上,過高假陽性 b 會削弱真高努力的相對回報,而低真陽性 a 則令誠信行為更常受罰。兩個誤差方向不對稱:降低 b 能改善行動識別而不改變高努力時的誤判率;提高 a 既改善識別,也降低錯誤暫停,但會提高 B 實際交付的平均頻率,可能增加其成本。故「訊號愈準愈好」需先說明何種準確度度量和報酬分配條件。若改用多類事件評價,需要重新指定每個訊號導致的補償或暫停狀態,而不是把同一套參數原封不動代入。
此模型沒有金錢。雖然可把 qv 與 qk 解釋為期望價值,卻不能據此引入無限制的可轉移效用:A 與 B 一次只可成功交付一份優先權,若其機會價值隨人而異,誰承擔 k 與誰得到 v 都影響契約是否可維持。非貨幣報酬可能包含時間安排、支援角色、共同決策權或下一次行動的分配先後;這些例子只說明抽象優先權的經濟學含義,並非已核實的《王者榮耀》遊戲規則。報酬也不能被理解為真實勝率的貨幣等值,因本文沒有估計 v、k、c、g 的真實單位。
相較永久完全排斥,有限期錯誤懲罰的制度目的,是提供 A 可預期的損失同時保留日後重建互惠的可能。本文讓 y=0 觸發 L 輪短期暫停;因為誠信高努力仍有概率 1−a 出現低訊號,這種暫停不可避免地傷及守約者。長期比例 1/[1+L(1−a)] 精確量化了某類虛構制度的合作機會損失;若研究現實心理上「被錯怪」的額外憤怒或信任破裂,應把這些成本明確加入 P 的效用,屆時命題 5 也需重新證明。
我們亦必須限制均衡用語。命題 3 證明的是在本文行動、公開轉移和零外部選項假設下,指定策略通過全部單次偏離檢查;沒有證明全部可能的公眾記憶策略、持續合作合約或重新議價制度都是這個形式,也沒有求得所有均衡的福利上界。本文的「最短可行期限」只對這一類固定長度暫停與永久拒絕處罰的候選契約為最適。若允許不對稱訊號、逐級縮短懲罰、隨機報酬規則或者玩家離場再配對,最佳制度可能改變。
最後,在實際《王者榮耀》團隊中,互動常只有有限時間,隊友未必會重遇,同時每場由更多參與者做出複雜的策略選擇。未知對手動作、英雄能力差異和版本調整都會影響利益分布。無限期折現關係只是一個把未來合作價值抽象化的工具,不可直接宣稱某個指定 L 會使排位玩家表現提升。要把理論運用於經驗研究,首先必須取得經允許的事件級合作訊號資料,建立 A 努力與外部資源狀態的因果識別,並確認其實際公開性及履約證據,而不能把模擬格點當成玩家樣本。
8. 研究局限、穩健性界線與未解問題
第一,所有參數均是選定的抽象效用。a、b、q 沒有從歷史對局估計,δ 也不是用玩家時間偏好問卷推定;所謂 2–5 輪只表示理論模型的抽象互惠機會單位,不是遊戲回合、分鐘或場數。若數值被用來提出實際策略建議,須首先證明相應觀察量和現實玩家成本之間存在可識別關係。本文不能測量政策的因果效果,也不能推斷改變訊號監督將使真實勝率提高多少。
第二,公開訊號採用簡單二元條件獨立分布;實際團隊績效訊號往往受到敵方配對、隊友狀態、分路資源和突發事件共同影響。此處沒有同時建模操縱訊號的成本,亦沒有認知偏誤或風險厭惡。若努力者具有損失厭惡,對錯誤暫停的損失評估未必等於線性期望效用,A 的激勵式需要從非線性的行為效用重新構建。本文的精確證明只能支持線性、風險中性與條件獨立的假設。
第三,可驗證故意背約假設相當強。倘若 B 能假裝已嘗試履約,或公共訊號傳遞延遲,D 的觸發就可能變得有誤差。假如誠信 B 被意外錯判背約,也會承擔不公平的永久懲罰;若有人能付費改變履約記錄,還可能形成機制操縱問題。此處特意把失敗的外生概率 q 與 B 的策略拒絕分開,才得到封閉式結果;若兩者不可辨識,核心結果須重新檢驗而不能簡單替換參數。
第四,本文使用兩個代表性參與者作最小可解模型,未處理其他隊友是否允許資源安排、對方聯盟的外部性、第三人對補償機會的權利、個人被多位隊友同時要求承諾,以及多方不完全資訊報價。HOK-010 所揭示的外部分區福利損失因而沒有在 HOK-011 消失,只是被模型邊界排除。多人版本可能產生聯盟否決、聲譽搭便車與行為訊號共變動,需要不同均衡概念和大幅增加的狀態維度。
第五,平穩合作狀態的 Markov 比例假定人們願意在固定懲罰期後回歸契約。若玩家可以退出、替換隊友或選擇匹配市場中其他搭檔,永久終止 D 的外部價值未必為零;B 的背約成本就會從 δV_B 減少為 δ(V_B−V_B^D),而 A 的參與條件亦需比較真實替代方案。本文沒有因為模型可以解析求解而掩蓋此重要制度風險。
第六,因為每個候選 L 的福利是在相同預設遵約路徑比較,命題 5 適用於既定策略均衡中最短可行期限。若離開均衡,玩家可能怠工或背約,不能將不具激勵相容的高福利理想路徑與真實可維持的合作福利直接比較。熱圖只有 31 個候選整數期限,也不意味已對全部無限期時間制度作完整均衡枚舉。需要更強健的研究時,可採公開監督重複博弈的自我生成集合算法求全均衡邊界,再檢查其與本候選契約的差距。
9. 結論
本文為《王者榮耀》合作語境中的抽象非貨幣互惠,建立一個有私人努力、不完美公開績效及可驗證背約決定的重複博弈。透過 Bellman 方程及一次偏離比較,先後得到參與、努力與履約的必要充分約束,再證明懲罰期的雙邊相反單調性、可行期限的連續整數區間、最短可行期限的限制福利最優性,以及成功交付概率的雙向臨界界限。合成基準實驗顯示合作要求 2–5 輪暫停,L=3 的解析折現總福利約 8.10593;獨立 Fraction 解算與四萬條隨機路徑支持計算正確性。這些結果提供的是特定形式契約的理論可行域與程序性反例,不是對真實遊戲機制或玩家行為的實證主張。下個研究階段宜放寬可驗證背約假設,研究公開訊號可能混淆故意拒絕與外生失敗時,信譽更新和容錯懲罰能否同時降低錯誤排斥與策略背約。
參考文獻
Abreu, D., Pearce, D., & Stacchetti, E. (1990). Toward a theory of discounted repeated games with imperfect monitoring. Econometrica, 58(5), 1041–1063. https://doi.org/10.2307/2938299
Baker, G., Gibbons, R., & Murphy, K. J. (2002). Relational contracts and the theory of the firm. The Quarterly Journal of Economics, 117(1), 39–84. https://doi.org/10.1162/003355302753399445
Fudenberg, D., Levine, D., & Maskin, E. (1994). The folk theorem with imperfect public information. Econometrica, 62(5), 997–1039. https://doi.org/10.2307/2951505
Green, E. J., & Porter, R. H. (1984). Noncooperative collusion under imperfect price information. Econometrica, 52(1), 87–100. https://doi.org/10.2307/1911462
Levin, J. (2003). Relational incentive contracts. American Economic Review, 93(3), 835–857. https://doi.org/10.1257/000282803322157115
上述五項文獻的作者、刊物、年度、頁次和 DOI 已與出版者、JSTOR 學術刊物目錄或學術機構書目作交叉核對;本研究自行提出的固定期補償策略不歸屬於任一被引論文原定理。BibTeX 完整記錄另存於文庫 06_參考文獻。