研究论文|理论模型与实证方案
单人排位中的开团跟随决策
一个动态不完全信息协调博弈模型
——从“无条件跟团”到贝叶斯阈值规则——
学术重修版|2026年8月
论文定位 本文是一篇可独立投稿的理论与研究设计稿。所有数值示例均明确标示为校准示例,不冒充真实对局结果;正式实证发表仍须取得逐帧遥测或录像编码数据。 |
摘要
在多人在线战术竞技(MOBA)游戏的单人排位中,一名玩家先手开团后,其余队友必须在信息不完整、反应时间极短且彼此无法可信沟通的条件下,决定跟进、有限支援或撤退。既有玩家叙事常把“无条件跟团”视为团队理性的占优策略,但该命题混淆了团队收益与个人边际贡献,也忽略开团质量、到场时延、技能状态、队友响应概率及敌方反应。本文构建一个包含开团者、四名响应者与敌方的动态不完全信息博弈。基础模型以对局胜率变化、即时资源净收益、阵亡与机会成本共同定义效用;响应者根据私人信号和开团者行动进行贝叶斯更新,并在策略互补条件下选择支持强度。本文证明:第一,无条件跟团一般不是严格占优策略;最优响应由“边际胜率收益加即时战斗收益”是否超过“承诺成本与替代机会成本”的阈值决定。第二,当队友的有效投入提高自身投入的边际回报时,博弈可出现高响应与低响应的多重均衡,快速、可观察的支援动作能够改变高阶信念并推动均衡跃迁。第三,开团行为只有在不同类型开团者的行动概率存在显著差异时才是信息性信号;若低质量类型同样频繁开团,盲目信赖不成立。第四,等待具有信息价值,但会因战斗状态衰减、控制链断裂与救援窗口关闭而产生内生延迟成本。第五,威慑性前压可在不承担完全承诺成本的情况下改变敌方追击选择,因此三元策略通常优于简单的“跟/不跟”二分法。本文进一步提出可用逐帧对局数据检验的假设、变量定义与因果识别方案。规范性结论是:单排玩家应采用基于后验信念、边际贡献和到场时延的条件式响应规则,而非无条件跟团或机械卖队友。
关键词:MOBA;单人排位;协调博弈;不完全信息;策略互补;信号博弈;响应时延
JEL分类号:C72,C73,D82,D91
Abstract
After a player initiates an engagement in solo-queue multiplayer online battle arena games, the remaining teammates must choose whether and how strongly to respond under severe time pressure, incomplete information, and weak communication. This paper develops a dynamic Bayesian coordination game with one initiator, four responders, and an opposing team. Payoffs combine changes in match-winning probability, short-run resource gains, death risk, and opportunity costs. The model shows that unconditional following is generally not a dominant strategy. A responder should commit only when the expected marginal improvement in the continuation state exceeds the marginal exposure and opportunity cost. Strategic complementarities can generate high-response and low-response equilibria; visible early support changes higher-order beliefs and may shift equilibrium selection. Initiation is informative only when high-quality types initiate more often than low-quality types. Waiting creates information value but also endogenous delay costs because combat effectiveness decays rapidly. Finally, a three-action extension—full commitment, limited support, and disengagement—shows why deterrent positioning or peel can dominate either extreme. The paper closes with testable hypotheses and an event-level empirical design for replay or telemetry data.
Keywords: MOBA; solo queue; coordination game; incomplete information; strategic complementarity; signaling; response latency
1 引言
单人排位中的开团响应不是一个静态的“勇敢或怯懦”选择,而是一个在数秒内完成的分散式团队决策。开团者首先暴露位置并消耗技能;其余玩家分别观察到不同的小地图、血量、技能冷却与敌方动向,并同时推测“别人会不会来”。这使决策同时具备四个特征:行动顺序、私人信息、策略相互依赖与时间衰减。任何只比较“5对5”和“4对5”的收益矩阵都遗漏了最关键的内生变量——响应人数本身由每位玩家对其他人的信念共同决定。
玩家社区常见的强命题是:只要队友已经开团,所有能到场者都应无条件跟进,因为统一行动即使方向错误,也优于各自正确。该直觉抓住了策略互补和协调失败,却把一个“在某些参数区域成立的最佳反应”夸大为“对所有状态都成立的占优策略”。严格意义上的占优要求:无论基本面、成本、他人行为和可用信息如何,跟进都至少不差于不跟。只要存在明显无法到场、己方关键技能全空、敌方人数与资源优势极大、或防守更高价值目标的状态,这一要求便不可能满足。
本文不否认迅速响应的价值,而是把它变成可推导、可检验且能说明例外的规则。研究问题有三:其一,个体何时应把自身资源投入一个已经发生的团战?其二,可观察的响应动作如何改变队友与敌方的信念,从而影响均衡?其三,如何用对局事件数据区分“跟团有效”与“本来有利的团更容易获得跟进”这两个方向相反的因果解释?
本文有四项贡献。第一,以对局延续价值而非KDA为核心,给出个体边际贡献条件,证明无条件跟团并不具一般占优性。第二,将开团建模为内生信号,区分分离、半分离与混同情形,避免把任何先手都误当成高质量信息。第三,把等待的资讯价值与战斗窗口衰减放入同一停止问题,说明“立刻上”和“先观察”各自在何种条件下合理。第四,提出可复制的事件定义、预测假设与因果估计策略,为后续实证研究建立框架。
核心结论 真正稳健的策略不是“无条件跟”,而是“默认快速响应、按边际价值分级承诺”:后验质量高且到场边际贡献大时全压;能改变敌方追击或救援概率但正面胜算不足时有限支援;边际贡献低于承诺成本时撤退并交换资源。 |
2 文献基础与理论缺口
2.1 临时团队与电竞协调
MOBA单排队伍属于典型的临时团队:成员缺乏共同历史,却必须在短时高压环境中协作。Kou与Gui(2014)对《英雄联盟》玩家的访谈显示,陌生人团队仍会通过沟通、角色履行与相互影响建立临时协作;Freeman与Wohn(2018)进一步强调电竞团队在压力下依赖多模态沟通、状态同步与动态角色调整。Kahn与Williams(2016)结合18,627名玩家调查与服务器数据,发现交互记忆系统与胜负显著相关,说明“谁知道什么、谁能做什么”的共享认知本身具有绩效价值。
这些研究支持“协调重要”,但不能直接推出“任何已发起行动都应跟随”。团队组成也会改变同一响应的价值。Cheng等(2019)使用《王者荣耀》9,600万场比赛的数据发现,角色多样性与胜率、韧性及失利时的互动行为相关。这意味着响应成本与战斗生产函数存在角色异质性:坦克的前排承诺、辅助的保护技能与射手的持续输出不能用同一个固定成本表示。Sapienza等(2018)还发现连续游戏过程中的个体表现会变化,提醒模型纳入疲劳、经验和局内状态,而不能假定行动者永远稳定理性。
2.2 协调博弈、不完全信息与策略互补
Schelling(1960)的聚焦点概念解释了无沟通团队为何会依赖显著行动作为共同参照;Harsanyi(1967)则提供了把私人信息与类型纳入贝叶斯博弈的基础。Cooper与John(1988)指出,策略互补会使个体最佳反应随他人行动增加,从而产生协调失败和多重均衡。Morris与Shin(2003)的全球博弈研究表明,即使基本面相同,玩家关于他人信念的信念也会影响均衡选择。开团响应正是一个高阶信念极为重要的微型场景。
然而,纯粹的“猎鹿博弈”仍然过于粗糙。MOBA团战不是达到固定人数就必然成功的公共品,而是一个成功概率随角色、位置、技能与时点连续变化的团队生产过程;参与者也不是只能选择0或1,而可用前压、远程消耗、护盾、拆火或撤退形成连续支持强度。因此本文以概率生产函数为基础,再把二元模型扩展为三元与连续行动。
2.3 有限理性与行为偏误
现实玩家会受损失厌恶、归因偏误、KDA保护和情绪影响。前景理论说明个体对损失与概率的主观权重并非线性(Kahneman & Tversky, 1979);量化反应均衡则允许较高效用行动被更高概率选择,而不要求每次都完美最优(McKelvey & Palfrey, 1995)。这些机制适合解释同一玩家在相似状态下仍会作出不同响应。
必须特别澄清沉没成本。开团者已经交出的位移、闪现或生命值确实无法收回,但“因为已经投入所以继续投入”正是沉没成本偏误,而不是理性理由(Arkes & Blumer, 1985)。跟进是否合理,只取决于此刻新增投入能否改善未来状态。队友情绪、后续合作与投降概率可以进入延续价值;已消耗的技能本身则不能被重复计入可避免损失。
3 场景、时序与符号
3.1 事件边界
本文把“开团事件”定义为:己方玩家A在时间t₀首先采取显著提高双方短期交战概率的不可逆行动,例如进入敌方控制/伤害范围、命中硬控、使用强制位移或承担防御塔与多人火力。普通试探性技能、远程清线与无后续接触的视野动作不计入。响应窗口为[t₀, t₀+T];T应依游戏节奏和技能持续时间在数据中预注册,而不能在看到结果后调整。
参与者为开团者A、n=4名潜在响应者i∈N以及敌方E。自然先抽取基本面θ,包括双方经济、等级、血量、关键技能、站位、视野、阵容、地图目标与复活时间。A观察私人信号s_A并选择开团或不开团;若开团,响应者观察公共动作a_A及各自信号s_i,再选择支持强度;敌方观察到部分支援后选择追击、接战或撤退。
3.2 核心符号
表1 模型符号与经验对应
符号 | 定义 | 可观测代理 |
θ | 团战基本面或潜在质量状态 | 经济差、等级差、血量、技能、站位、视野、阵容与目标价值 |
xᵢ | 响应者i的支持强度,基准模型取0或1 | 到场、位移方向、技能释放与伤害/保护贡献 |
z | 除i以外队友的有效支持总量 | 按到场时延和角色权重折算的支持量 |
q(z,θ) | 己方在该事件中获得有利结果的概率 | 净击杀、净经济、目标控制或胜率变化 |
Bᵢ | 有利结果对i的延续价值 | 事件后预测胜率的货币化/效用化变化 |
cᵢ | i跟进的边际承诺成本 | 预期阵亡、技能消耗、暴露与路径机会成本 |
πᵢ | i对有利基本面的后验信念 | 由公共状态、私人视野及开团动作更新 |
τᵢ | 到场或生效时延 | tᵢ−t₀ |
λ | 战斗窗口的衰减率 | 控制链、集火机会与救援概率随时间下降的速度 |
δ | 局内未来互动的折现因子 | 剩余时长、复活周期与目标价值 |
4 完全信息基准模型
4.1 效用与边际贡献
先假设θ与其他人的支持量z为共同知识。响应者i在不跟进时得到Uᵢ(0,z,θ),跟进时得到Uᵢ(1,z,θ)。将效用拆成对局延续价值、即时战斗净收益与承诺成本:
Uᵢ(xᵢ,z,θ)=Bᵢ·q(z+xᵢ,θ)+rᵢ(xᵢ,z,θ)−cᵢxᵢ (1)
其中Bᵢ并非“赢下一波团”的快感,而是该事件对最终排位目标的价值;rᵢ允许击杀、助攻、保护、资源交换和KDA偏好进入模型;cᵢ只包含尚未发生的边际成本。由式(1),跟进相对不跟的效用差为:
ΔUᵢ(z,θ)=Bᵢ[q(z+1,θ)−q(z,θ)]+Δrᵢ(z,θ)−cᵢ (2)
最优反应为xᵢ*=1,当且仅当ΔUᵢ≥0。这个表达式把讨论从“这波团整体能不能赢”转向“我的加入能把结果改变多少”。即使当前胜率很低,只要个人是关键的控制、伤害或保护节点,边际贡献仍可能很高;反之,即使团战本来有利,远离战场或技能全空的玩家加入也可能几乎没有边际价值。
命题1(无条件跟团不具一般占优性)。在存在至少两个可行状态θᴴ、θᴸ,且承诺成本cᵢ>0的条件下,只要max_z{Bᵢ[q(z+1,θᴸ)−q(z,θᴸ)]+Δrᵢ(z,θᴸ)}<cᵢ,而某一θᴴ状态下相反不等式成立,则跟进与不跟进分别在不同状态为严格最佳反应;因此不存在与状态无关的严格占优行动。
证明直观。式(2)的符号随θ变化即可。低质量状态下,新增一人的胜率增量与即时收益不足以覆盖成本,故不跟严格较优;高质量状态下增量超过成本,故跟进严格较优。由于占优策略必须对所有状态和他人行动都不差,命题成立。完整证明见附录A。
4.2 策略互补与多重均衡
若队友的支持使自己的技能更容易命中、输出环境更安全或救援更有效,则支持行动存在策略互补。形式上,在相关区间内:
ΔUᵢ(z+1,θ)−ΔUᵢ(z,θ)>0 (3)
式(3)表示他人的支持越多,自己的跟进越有价值。其来源可包括前排分摊伤害、控制链衔接、集火速度、保护覆盖与敌方目标选择困难。策略互补会产生两个自我实现的预期:若大家预期别人会到,跟进成为最佳反应并形成高响应均衡;若大家预期别人不会到,个人加入可能成为孤立投入,低响应均衡遂自我维持。
为表示平滑的战斗生产函数,可使用逻辑成功函数:
a(θ)概括基本面,β表示有效响应对成功对数胜算的提升。逻辑函数在低成功率区间呈边际贡献上升,越接近临界点,队友之间越可能是互补品;越过拐点后边际贡献下降,过度投入可能转为机会成本。
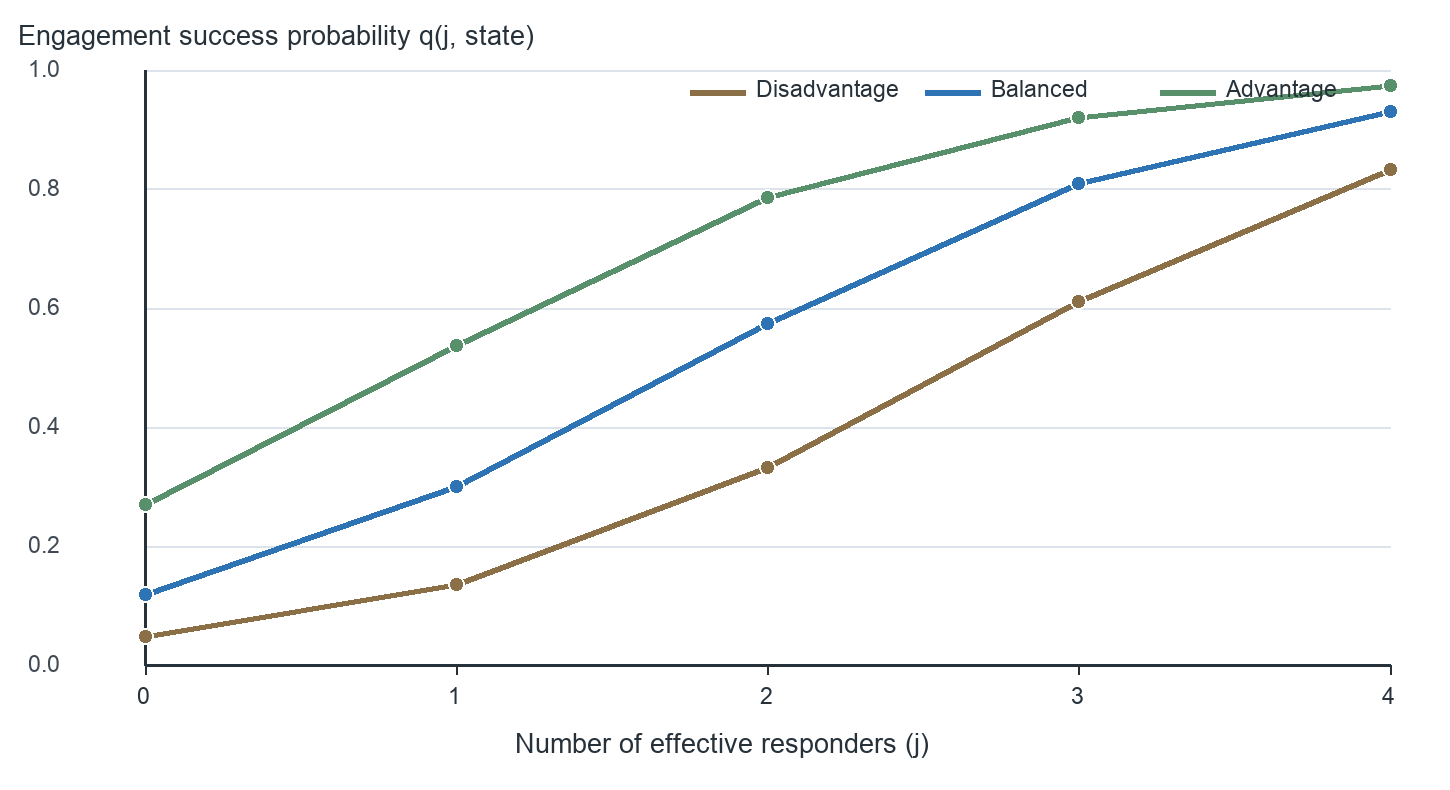
图1 不同基本面下,响应人数与事件成功概率的示意关系
注:曲线为理论校准示例,不代表真实《王者荣耀》胜率。参数用于展示边际贡献随基本面和响应人数变化。
命题2(协调乘数)。若式(3)成立,且最低与最高支持预期分别使ΔUᵢ小于0与大于0,则至少存在一个低响应均衡和一个高响应均衡。任何提高早期可观察支持、降低响应成本或提升共同信念的机制,均会扩大高响应均衡的吸引域。
这解释了“先动一下”的价值,但仍不等同于全压。公开前压、靠近、施放低成本技能或发送快捷信号,都可能先改变他人的预期,再通过协调乘数提高后续投入。策略建议因此应区分“表态成本”与“完全承诺成本”。
5 不完全信息与开团信号
5.1 贝叶斯更新
现实中θ不可完全观察。令θ∈{H,L}分别表示有利与不利状态,先验Pr(θ=H)=μ。响应者观察私人信号sᵢ以及开团动作a_A=1。若高、低状态下开团概率分别为α_H与α_L,则仅依据开团动作更新后的后验为:
当α_H>α_L,开团是正向信息;当二者相等,开团完全无信息;当低质量状态下因冲动、误判或故意消极而更常开团,α_H<α_L,开团甚至是负向信号。因此“他敢开一定看到了我没看到的东西”只在可识别的类型分离条件下成立。英雄熟练度、此前决策质量、资源领先时的选择与信号一致性,会改变玩家对α_H/α_L的主观估计。
结合私人信号后,i的后验πᵢ=Pr(H|a_A=1,sᵢ)。若两状态下的边际净收益分别为g_H(z)与g_L(z),则期望效用差为:
E[ΔUᵢ|Iᵢ]=πᵢg_H(z)+(1−πᵢ)g_L(z)−cᵢ (6)
当g_H(z)>g_L(z),响应规则具有后验阈值:
xᵢ*=1 ⇔ πᵢ≥πᵢ*(z)=[cᵢ−g_L(z)]/[g_H(z)−g_L(z)] (7)
式(7)是本文最核心的实战判据。更低的到场成本、更高的关键技能可用性、更大的目标价值,以及更多已确认响应的队友,都会降低所需后验阈值;路径过远、敌方反打资源充足或己方更有价值的防守任务,则会抬高阈值。
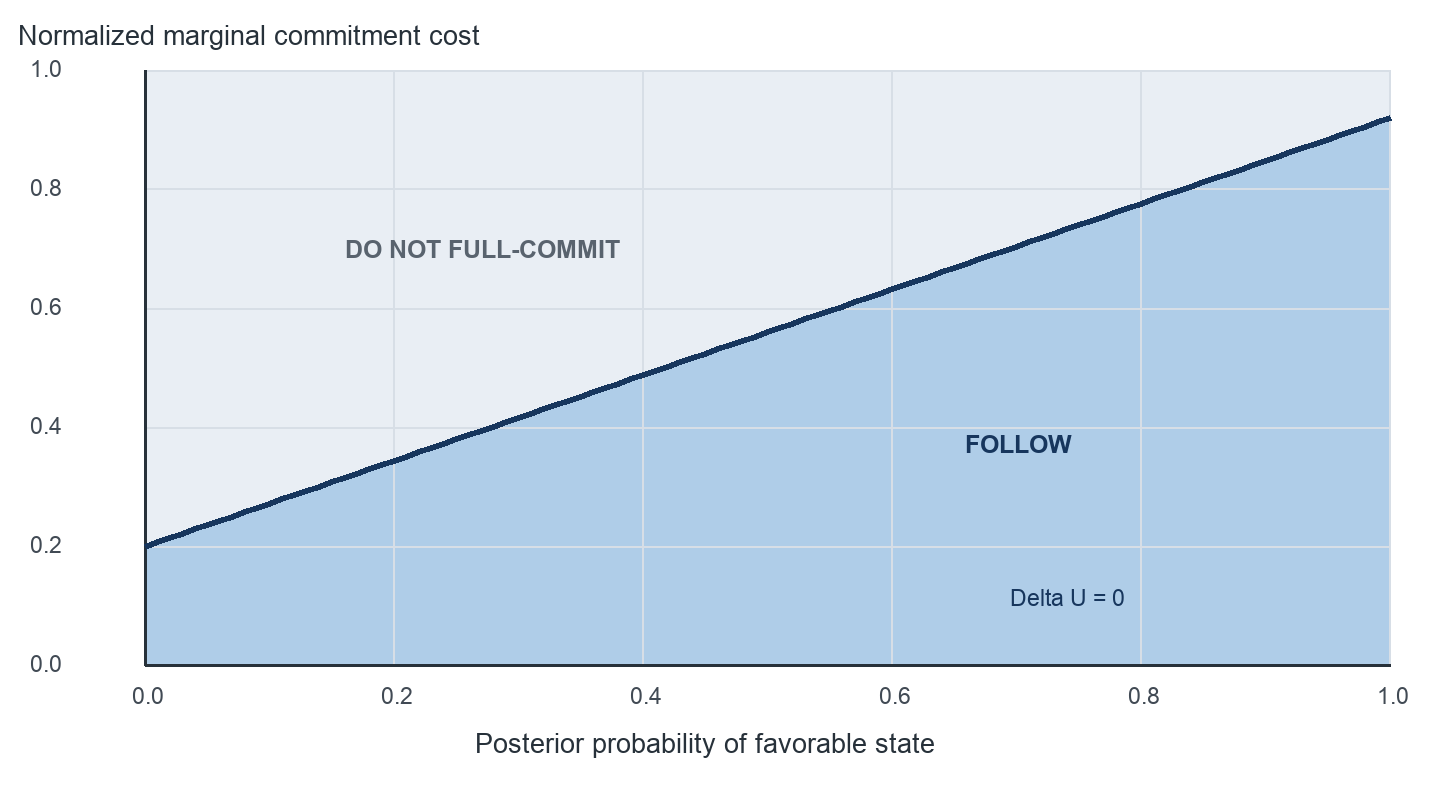
图2 后验质量与承诺成本共同决定全压区域
注:边界为标准化示例ΔU=0;蓝色区域表示在给定参数下全压的期望效用非负。
5.2 分离、混同与信誉
若高质量类型开团而低质量类型不愿承担失败成本,行动形成分离均衡,跟随者可据此大幅上调πᵢ。若所有类型都开团,则形成混同均衡,动作本身不能证明质量。单排匹配的匿名性削弱跨局信誉,但同一局内仍存在短期记录:此前的高质量信号、及时撤退和目标判断会提高后续开团的可信度;连续误判、无信息强开或与快捷信号矛盾则降低可信度。
信誉不是对人的道德评价,而是对其信号精度的统计估计。理性响应者不应因为一次成功便把α_H/α_L推到极端,也不应因一次失败完全归零;更合适的是使用带收缩的贝叶斯更新,令先验在样本很少时占较大权重。该原则同样防止“上次他卖我,所以这次我也不跟”的报复性循环。
6 响应时延与等待的资讯价值
6.1 有效支持的时间衰减
响应不是瞬时到达。令i在τᵢ秒后生效,单位支持的有效量为wᵢe^(−λτᵢ),其中wᵢ取决于角色与技能。团队有效支持为:
λ越大,战斗窗口越短。强控制命中后的集火、濒死队友的拆火与敌方位移技能真空通常具有高λ;远程拉扯、阵地消耗和目标区封锁的λ较低。由此,“犹豫两秒必然最差”不是普遍真理,但在高λ场景下更可能成立。
6.2 等待作为最优停止问题
等待Δ秒可获得新信息y,例如敌方增援、队友路径或关键技能是否命中。令VOIᵢ(Δ)为信息带来的期望决策改进,Dᵢ(Δ)为延迟导致的边际贡献下降、救援窗口关闭与被分割风险。若等待还节省误入成本Sᵢ(Δ),则等待优于立即决策的必要条件可写为:
VOIᵢ(Δ)+Sᵢ(Δ) > Dᵢ(Δ) (9)
命题3(快速响应条件)。若战斗状态按λ衰减,且新信息到达率有限,则存在临界衰减率λ*:当λ>λ*时,任意正等待Δ的边际延迟损失超过信息价值,立即选择最优支持层级;当λ<λ*且即将到来的信息足以改变行动排序时,短暂观察可以最优。
这一区分对操作建议很重要。玩家不应“等到结果明显再决定”,因为那时信息虽准确却已失去因果作用;也不应在所有场景零判断冲入。正确做法是在进入事件前建立简化规则,把高频状态预先分类,从而降低实时计算负担。
7 敌方反应与威慑子博弈
原稿最有价值的直觉是:支援者现身会改变敌方追击收益。令敌方继续追击的收益为R,遭反打的预期损失为D(J),且D′(J)>0。敌方选择追击当且仅当:
R−D(J)≥0 (10)
因此存在威慑阈值J̄,使J≥J̄时敌方撤退。响应者的价值不只来自提高己方正面获胜概率,还来自跨过J̄后使敌方策略离散改变。若一个低成本前压即可让J跨过阈值,有限支援可能严格优于全压:它获得救援与停止追击的收益,却保留位移和关键技能。相反,若敌方掌握完整视野且清楚支援者无法输出,虚张声势不会形成可信威慑。
命题4(最小可信支援)。若支持强度x连续、成本c(x)递增,敌方在J≥J̄时撤退,则在可达条件下,最优威慑支援为使J恰好达到J̄的最小x;超过阈值的额外投入只有在提高后续战斗或目标收益时才合理。
8 三元行动扩展与可执行策略
8.1 从二元选择到分级承诺
把行动集合扩展为Aᵢ={F,S,R}:F为全压跟进,S为有限支援,R为撤退/交换资源。三者不是道德排序,而是不同风险暴露。F使用关键位移与高价值技能并进入敌方主要伤害区;S通过远程技能、护盾、控制、卡位或可撤回前压改变局势;R保存资源、清线、防守或换取另一侧目标。
表2 三元响应策略的条件与风险
行动 | 适用条件 | 主要收益 | 主要风险 |
F 全压 | πᵢ高;边际伤害/控制关键;到场快;已有队友确认响应 | 跨过胜负临界点、完成集火并夺取目标 | 团灭、关键技能与位置全部暴露 |
S 有限支援 | 正面胜算不确定;可救援或威慑;保有安全退出路径 | 降低敌方追击、拆火、延长队友撤离窗口 | 支援过浅无效;支援过深滑向全压 |
R 撤退/交换 | 边际贡献低;到场过慢;更高价值目标可守或可换 | 保存核心资源、避免连续死亡、建立止损线 | 误判时放弃可赢团;可能降低队友后续信任 |
8.2 决策规则
将模型压缩成数秒内可执行的顺序规则:第一,判断物理可达性与关键技能是否能在窗口内生效;不可达时直接转入交换资源。第二,观察已有响应人数与角色,估计自己的边际贡献而非团战整体观感。第三,利用开团者可信度、敌方缺失信息与目标价值形成粗略后验。第四,比较全压、有限支援与撤退的增量收益。第五,一旦选定行动,立即发送可观察信号并执行,避免在三种行动间反复摇摆。
表3 面向单排玩家的六步快速检查
快速检查 | 问题 | 决策含义 |
可达 | 我能否在控制链/救援窗口结束前产生作用? | 否:R;是:继续 |
关键性 | 我的控制、爆发、保护或承伤是否可能改变结果? | 高:降低F阈值;低:偏向S或R |
共同响应 | 已有几名队友明确转向或交出技能? | 越多越支持F,但越过饱和点后边际下降 |
基本面 | 敌方关键技能、人数、血量、视野与目标价值如何? | 形成πᵢ,而非只凭开团动作 |
退出路径 | 有限支援后能否安全回撤? | 能:S更有价值;不能:S可能等同F |
替代收益 | 不参团能否稳定守塔、清线或换取更高价值目标? | 替代收益越高,承诺成本cᵢ越高 |
规范性原则 默认响应不等于默认全压。最优纪律是先消除无意义的观望,再选择能最大化边际贡献/成本比的支持层级。 |
9 重复互动、激励错位与有限理性
9.1 局内重复与信誉外部性
同一局内会发生多次团战,因此单次响应会改变未来信念。令Vᵢ为未来合作价值,δ为折现因子,则当前行动还包含δ·ΔVᵢ。及时但不过度的响应可提高队友对共同执行的预期;恶意卖队友或报复性冲锋会降低未来协调。由于对局有限且终局临近,纯粹依赖长期惩罚维持合作并不稳健;越接近终局,声誉渠道越弱,当前目标价值渠道越强。
9.2 KDA与排位目标的委托—代理问题
若玩家效用只等于最终胜负,Bᵢ占主导;若玩家还重视KDA、举报风险、MVP评价或即时情绪,则效用可写为Uᵢ=ωUᵢ^win+(1−ω)Uᵢ^private。ω较低时,玩家可能选择对个人面板安全却降低团队胜率的行动。这个偏差不是“非理性”的唯一来源,也可能是评价系统对团队目标的激励不完全。实证研究应分别估计胜率导向与私人指标导向的行为,而不能把所有不跟进都解释为胆怯。
9.3 量化反应与压力下误差
在量化反应均衡中,行动a的选择概率随预期效用上升:Pr(a)∝exp(κEU(a))。κ表示决策精度;高延迟、信息拥挤、疲劳或情绪可能降低κ,使劣势行动仍有正概率。这一框架比“玩家完全理性/完全不理性”的二分更适合解释单排数据,也能检验快捷信号、界面提示或训练是否提高决策一致性。
10 比较静态与可检验假设
由式(2)、(7)至(10)可导出方向明确的比较静态。以下命题是条件性的:它们要求其他状态得到充分控制,并不把原始相关性直接解释为因果。
表4 主要比较静态
参数变化 | 对F的理论影响 | 机制与异质性 |
Bᵢ上升 | 增加 | 后期高价值目标、兵线与复活时间使事件后果更大 |
cᵢ上升 | 减少 | 核心位无位移、持有关键资源或替代目标价值高 |
已有响应z上升 | 临界区增加,饱和后下降 | 策略互补先增强边际贡献,越过拐点后出现冗余 |
后验πᵢ上升 | 增加 | 基本面更好或开团信号更可信 |
时延τᵢ上升 | 减少 | 有效支持按e^(−λτᵢ)衰减,高λ事件更敏感 |
敌方追击收益R上升 | 威慑更难 | 需要更高J跨过威慑阈值 |
未来折现δ上升 | 取决于信誉效果 | 早中期一致响应的未来合作价值较大 |
H1(策略互补):在控制基本面后,其他响应者的早期可观察投入会提高个体全压概率;该效应在低成功率区间较弱、临界区最强、饱和区下降。
H2(时延衰减):响应时延与事件净收益呈负相关,且控制链更短、开团者承伤更高的事件具有更陡的负斜率。
H3(信号质量):开团者此前局内决策质量越高,其同样开团动作引发的响应概率越高;但在公共基本面充分可见后,该信誉效应应缩小。
H4(威慑阈值):当有效支援跨过某一离散阈值时,敌方继续追击概率出现非线性下降;仅看击杀结果会低估未发生追击的收益。
H5(三元优越性):在正面胜算中等且退出路径存在时,有限支援相对全压或撤退具有更高的期望胜率变化。
H6(行为误差):连续对局时长、近期失利与负面沟通会降低选择对状态变量的敏感度,即降低量化反应参数κ。
11 实证研究设计
11.1 数据与分析单位
理想数据是带时间戳的逐帧遥测:英雄坐标、朝向、血量、技能冷却、视野、伤害、控制、经济、等级、兵线、野区目标、快捷信号与击杀记录。若无法取得官方遥测,可用高帧率录像结合计算机视觉与人工双人编码建立事件集。分析单位不是整场比赛,而是“玩家—开团事件”;同一事件包含最多四个响应者,并嵌套于玩家、比赛、段位、版本与英雄。
样本纳入标准应在标注前确定:A的开团动作必须可识别;响应者在t₀存活;必须能够估计其最短到场时间;排除已明确断线、重连、故意挂机及事件窗口内发生数据缺失的观察。对“可介入”不应只用直线距离,而应依据移动速度、地形、控制状态与可用位移计算反事实最早生效时间。
11.2 处理、结果与协变量
表5 实证变量定义
类别 | 变量 | 操作化 |
处理 | 全压F / 有限支援S / 撤退R | 以路径、技能投入、伤害区暴露和退出路线联合分类 |
核心结果 | 事件价值ΔWP | 事件后与事件前模型预测胜率之差 |
短期结果 | 净经济、净击杀、存活、目标 | t₀后20—60秒多窗口报告,避免只挑最佳窗口 |
机制 | 敌方追击、控制链、救援 | 追击路径变化、控制衔接时差、开团者生存概率 |
基本面 | 战前状态X | 经济、等级、血量、冷却、人数、位置、视野、阵容、兵线与目标 |
异质性 | 角色与时延 | 英雄职能、熟练度、最短到场时间、网络延迟与段位 |
11.3 估计策略与识别限制
最基础的描述模型可用多项逻辑回归估计行动选择,并以玩家、英雄、版本与段位固定效应吸收稳定差异。对事件结果可估计:
Yₑᵢ=β_FFₑᵢ+β_SSₑᵢ+f(Xₑᵢ)+α_player+γ_patch+η_hero+εₑᵢ (11)
但β_F与β_S不能自动解释为因果效果,因为好团更容易被跟,反向选择会高估跟进收益;另一方面,临近失败才被动支援会低估收益。建议采用三层策略:先以事件前变量训练行动倾向模型,再使用交叉拟合的增广逆概率加权或因果森林估计条件平均处理效应;最后以未观测混杂敏感性分析报告结论对隐藏偏差的稳健程度。标准误应至少在比赛层级聚类,并报告玩家层级的重复观察处理。
若能利用准实验变化,可进一步提高识别。例如版本更新改变特定技能的控制持续时间或位移距离,但未同时大幅改变其他属性时,可构造差分中的差分;然而版本更新往往同时改变英雄选择与元环境,平行趋势必须检验。网络延迟看似可作工具变量,却可能直接影响伤害与生存,通常违反排除限制,除非有非常具体的技术性扰动与验证。
结果变量应优先使用事件后的预测胜率变化而非最终胜负,因为后者噪声大、受后续无数行动影响。预测胜率模型必须只使用处理前或明确位于结果时点的信息,防止把处理后变量泄漏进基线。所有窗口、事件定义、排除规则与主要结局应预注册;探索性分析与验证性分析分开报告。
11.4 标注可靠性与样本量
人工标注应对至少20%的事件进行双盲复核,报告三元行动分类的Cohen κ或Krippendorff α,并对分歧建立裁决规则。样本量不能按比赛数计算,而应考虑事件内与玩家内相关。正式研究可先用小规模试标估计处理比例、类内相关与结果方差,再根据最小可检测的ΔWP进行功效分析。若无法达到因果估计所需样本,应明确定位为预测或描述研究。
12 校准示例与敏感性分析
本节只展示模型如何计算,不报告真实游戏事实。设Bᵢ=1,Δrᵢ=0.08,三种基本面的逻辑参数a分别为−3、−2、−1,β=1.15。若i观察到z名有效响应者,则根据式(2)计算边际成功概率,并与成本cᵢ比较。
表6 逻辑成功函数下的边际贡献示例
基本面 | z | Δq | c=0.25时的毛收益 | 示例选择 |
不利 | 0 | 0.088 | 0.168 | 不全压 |
不利 | 1 | 0.196 | 0.276 | 跟进 |
不利 | 2 | 0.279 | 0.359 | 跟进 |
不利 | 3 | 0.221 | 0.301 | 跟进 |
均势 | 0 | 0.180 | 0.260 | 跟进 |
均势 | 1 | 0.275 | 0.355 | 跟进 |
均势 | 2 | 0.236 | 0.316 | 跟进 |
均势 | 3 | 0.121 | 0.201 | 不全压 |
有利 | 0 | 0.268 | 0.348 | 跟进 |
有利 | 1 | 0.248 | 0.328 | 跟进 |
有利 | 2 | 0.135 | 0.215 | 不全压 |
有利 | 3 | 0.053 | 0.133 | 不全压 |
示例显示,跟进价值并非随已有队友人数单调增加:在极不利状态,第一名响应者可能不足以扭转局势;接近临界区时,第二或第三名响应者最关键;在明显有利或已有充分支援时,额外投入的边际收益又下降。这正是“条件式跟团”优于无条件口号的数学原因。改变c、β或Δr会移动决策边界,正式论文应使用独立样本校准并报告参数不确定区间。
13 讨论
13.1 对“统一错误优于分散正确”的限定
统一行动在策略互补区间具有真实价值,但只有当共同投入能显著改变生产函数时才成立。若行动是战略替代品、资源已经饱和,或全员投入会放弃更高价值的防守与交换,统一并不自动有效。更精确的表述应是:在边际贡献上升且响应窗口短的临界区,减少协调分歧通常比追求个体局部最优更重要。
13.2 对“卖队友”的重新定义
不全压不等于卖队友。若有限支援能提高开团者生存、迫使敌方停止追击或换取技能,则它是积极响应;若撤退能确定守住高价值目标或交换资源,也可能是团队最优。真正的问题是玩家是否基于边际团队价值决策,还是只保护私人指标。实证分类必须观察路径与技能,而不能仅凭参团率或最终是否进入伤害范围。
13.3 外部效度与伦理
本文以《王者荣耀》式5v5单排为背景,但模型适用于其他临时团队的高压响应:战术射击、合作竞技乃至分散式应急团队。外部效度取决于行动时延、角色互补、信息共享与失败成本。若使用玩家录像、聊天或账户标识,研究应遵守平台条款、最小化个人数据并进行匿名化;文本毒性分析尤其不应公开可逆识别信息。
14 结论
本文把“队友开团后要不要跟”从经验口号重构为动态不完全信息协调博弈。理论上,跟进的价值等于它对事件成功与对局延续状态的边际改善,加上即时战斗和信誉收益,再减去阵亡、技能、位置与替代目标成本。由此,无条件跟团不是一般意义上的占优策略;真正稳健的是以后验信念、边际贡献、共同响应和到场时延为核心的阈值规则。
策略互补解释了为什么快速、可见的支援能打破低响应均衡;信号模型说明开团动作并非天然可信;停止模型说明观察只有在信息价值高于窗口衰减时才值得;威慑子博弈则证明有限支援可能以更低成本改变敌方选择。对玩家而言,最简洁的实践原则是:先响应,再分级;算增量,不追沉没;看能否改变结果,而不是只看这波团看起来好不好。
对于研究者,下一步不是继续用未经验证的胜率数字论证立场,而是建立可复现的开团事件数据集,预注册响应窗口与结果指标,并以因果方法区分选择效应。只有完成这一环节,理论结论才可升级为关于具体游戏、段位、版本与角色的经验定律。
参考文献
Arkes, H. R., & Blumer, C. (1985). The psychology of sunk cost. Organizational Behavior and Human Decision Processes, 35(1), 124–140. https://doi.org/10.1016/0749-5978(85)90049-4
Bernstein, D. S., Givan, R., Immerman, N., & Zilberstein, S. (2002). The complexity of decentralized control of Markov decision processes. Mathematics of Operations Research, 27(4), 819–840. https://doi.org/10.1287/moor.27.4.819.297
Cheng, Z., Yang, Y., Tan, C., Cheng, D., Zhuang, Y., & Cheng, A. (2019). What makes a good team? A large-scale study on the effect of team composition in Honor of Kings. Companion Proceedings of The Web Conference 2019, 266–272. https://doi.org/10.1145/3308558.3313530
Cooper, R., & John, A. (1988). Coordinating coordination failures in Keynesian models. The Quarterly Journal of Economics, 103(3), 441–463. https://doi.org/10.2307/1885539
Freeman, G., & Wohn, D. Y. (2018). Understanding eSports team formation and coordination. Computer Supported Cooperative Work, 27, 1019–1050. https://doi.org/10.1007/s10606-017-9299-4
Harsanyi, J. C. (1967). Games with incomplete information played by ‘Bayesian’ players, I–III: Part I. The basic model. Management Science, 14(3), 159–182. https://doi.org/10.1287/mnsc.14.3.159
Kahn, A. S., & Williams, D. (2016). We’re all in this (game) together: Transactive memory systems, social presence, and team structure in multiplayer online battle arenas. Communication Research, 43(4), 487–517. https://doi.org/10.1177/0093650215617504
Kahneman, D., & Tversky, A. (1979). Prospect theory: An analysis of decision under risk. Econometrica, 47(2), 263–291. https://doi.org/10.2307/1914185
Kou, Y., & Gui, X. (2014). Playing with strangers: Understanding temporary teams in League of Legends. Proceedings of the First ACM SIGCHI Annual Symposium on Computer-Human Interaction in Play, 161–169. https://doi.org/10.1145/2658537.2658538
McKelvey, R. D., & Palfrey, T. R. (1995). Quantal response equilibria for normal form games. Games and Economic Behavior, 10(1), 6–38. https://doi.org/10.1006/game.1995.1023
Morris, S., & Shin, H. S. (2003). Global games: Theory and applications. In M. Dewatripont, L. P. Hansen, & S. J. Turnovsky (Eds.), Advances in Economics and Econometrics: Theory and Applications, Eighth World Congress, Vol. 1 (pp. 56–114). Cambridge University Press. https://doi.org/10.1017/CBO9780511610240.004
Pynadath, D. V., & Tambe, M. (2002). The communicative multiagent team decision problem: Analyzing teamwork theories and models. Journal of Artificial Intelligence Research, 16, 389–423. https://doi.org/10.1613/jair.1024
Sapienza, A., Zeng, Y., Bessi, A., Lerman, K., & Ferrara, E. (2018). Individual performance in team-based online games. Royal Society Open Science, 5(6), 180329. https://doi.org/10.1098/rsos.180329
Schelling, T. C. (1960). The Strategy of Conflict. Harvard University Press.
Suleiman, R., & Rapoport, A. (1992). Provision of step-level public goods with continuous contribution. Journal of Behavioral Decision Making, 5(2), 133–153. https://doi.org/10.1002/bdm.3960050205
附录A 命题证明
A.1 命题1
定义Mᵢ(z,θ)=Bᵢ[q(z+1,θ)−q(z,θ)]+Δrᵢ(z,θ)。由式(2),ΔUᵢ=Mᵢ−cᵢ。在θᴸ下,假设对所有可行z均有Mᵢ<cᵢ,故xᵢ=0严格优于1;在θᴴ的某一可行z下Mᵢ>cᵢ,故xᵢ=1严格优于0。任何行动若为严格占优,必须对所有θ与z严格优于另一行动,与上述两状态矛盾。因此不存在状态无关的严格占优行动。证毕。
A.2 命题2
在二元行动与有限玩家下,最佳反应对应由ΔUᵢ的符号决定。式(3)给出递增差异,故最佳反应随z弱单调增加。若最低支持预期下所有玩家的ΔUᵢ<0,则全体不响应构成均衡;若最高支持预期下所有玩家的ΔUᵢ>0,则全体响应构成均衡。可观察的早期支持提高对z的信念,沿单调最佳反应映射推动迭代,因此扩大高响应均衡的吸引域。证毕。
A.3 命题3
令延迟损失Dᵢ(Δ;λ)连续且对λ严格递增,Dᵢ(0;λ)=0;令信息净收益Gᵢ(Δ)=VOIᵢ(Δ)+Sᵢ(Δ)有界。对任意固定Δ>0,存在λ*(Δ)使Dᵢ(Δ;λ*)=Gᵢ(Δ)。当λ>supΔ λ*(Δ)时,对所有正Δ均有Dᵢ>Gᵢ,立即决策最优;在较低λ且某一Δ满足Gᵢ>Dᵢ时,等待可改善期望效用。证毕。
A.4 命题4
若敌方策略在J̄处由追击离散转为撤退,且c(x)递增,则所有使J≥J̄的支持强度获得相同的纯威慑收益。令x*=inf{x:J(x)≥J̄}。任取x>x*,其威慑收益不变而成本更高,故在没有额外战斗收益时被x*严格支配。若存在额外收益,则最优x可超过x*,但其理由来自该额外项而非威慑本身。证毕。